



前端一旦要加载几十 MB 甚至几百 MB 的 JSON,最容易踩中的坑就是主线程卡顿和内存暴涨。真正有效的优化,不是单纯把 `JSON.parse()` 挪进 Worker,而是把“读取、切块、解析、过滤、回传”整条链路重排:先流式接收,再把筛选逻辑下沉到 Worker,能零拷贝就别做结构化克隆,最后再补上取消和缓存,让页面在大数据场景下还能保持可交互。
为什么“直接传 JSON 给 Worker”仍然不够快
很多实现会直接写成 `fetch(url).then(r => r.json())`,然后把结果丢给 Worker。问题在于,这种方式通常会先把完整 JSON 一次性读入内存,再完成一次主线程解析,之后传给 Worker 时还要经历结构化克隆。
如果数据量达到几十 MB 以上,这条路径很容易出现两个问题:
- 主线程在下载完成前后都要承受明显阻塞,页面交互会变差;
- 内存占用可能成倍增长,尤其是在“主线程解析完一份、Worker 再接收一份”的情况下,更容易逼近 OOM。
所以关键不只是“用 Worker”,而是避免整包读取、避免全量序列化、避免把本可以在 Worker 内完成的筛选又搬回主线程。
先改读取方式:用流式读取代替整包 `fetch`
第一步应该先把读取方式换掉,别再依赖 `fetch(url).then(r => r.json())` 这种整包处理。更合适的做法,是通过 `response.body.getReader()` 按流读取数据,在主线程边收边切块。
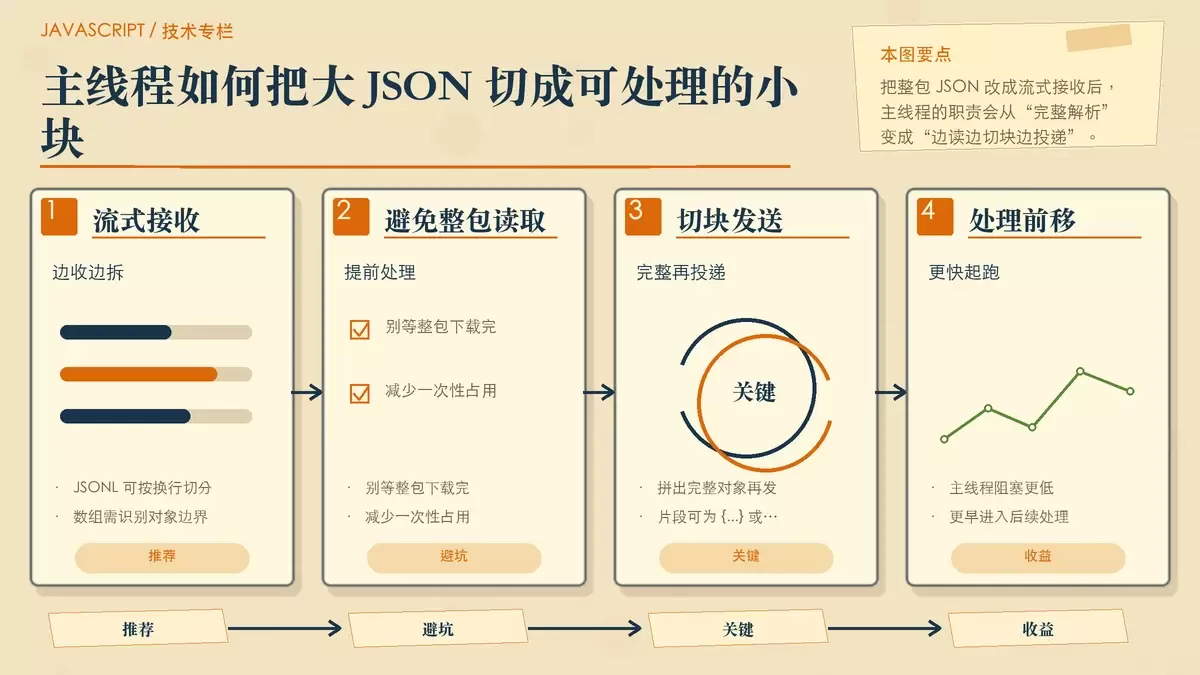
这样做的价值很直接:数据不需要等到全部下载完才开始处理,主线程也不必先持有完整 JSON 再交给 Worker。只要能拼出一个完整片段,就可以立刻投递出去。
不同 JSON 结构,切块方式不同
- 如果后端返回的是 JSONL(每行一个 JSON 对象),最简单,按 `\n` 切分即可;
- 如果返回的是标准 JSON 数组,就不能简单按换行拆,需要监听 `[`、`]` 的层级变化,或者用一个简单状态机识别对象边界;
- 每次拼出一个完整 JSON 对象,比如 `{...}` 或某段 `[...]` 片段后,就立即用 `postMessage` 发给 Worker。
这一步的重点是“尽早分发”,而不是“等全部下载完再统一处理”。对于大文件,这个差异往往直接决定页面会不会在加载期间失去响应。
const reader = response.body.getReader();Worker 里不要只解析,还要顺手完成过滤
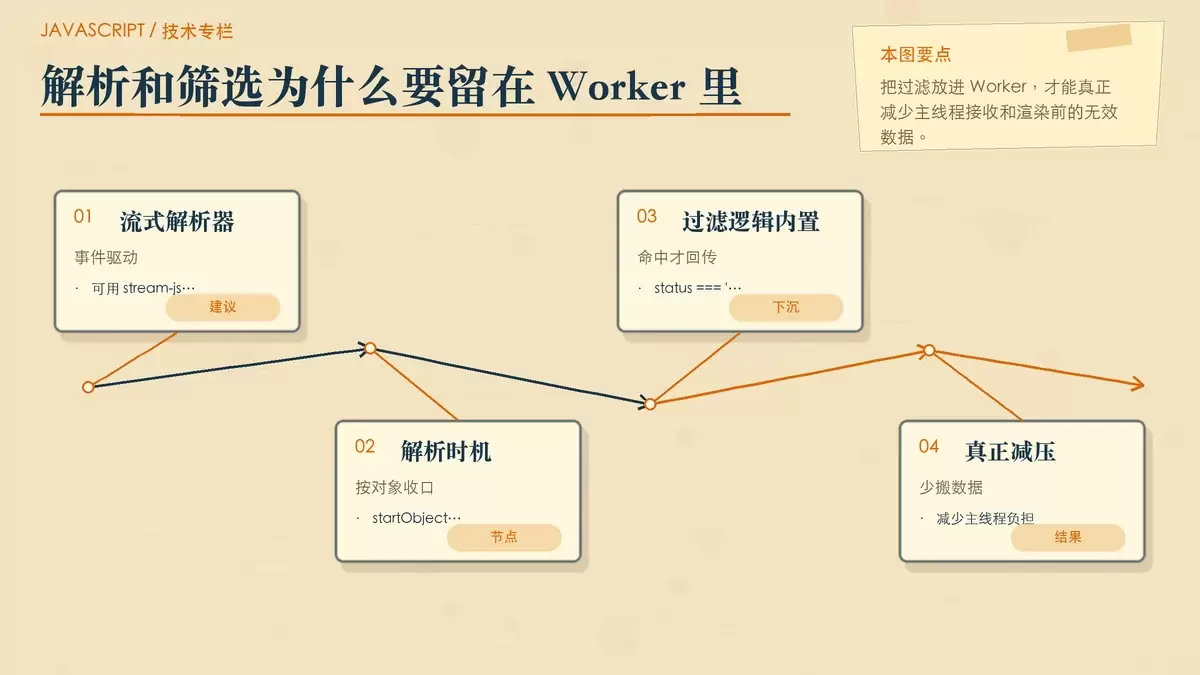
Worker 收到的最好不是整份原始 JSON 字符串,而是已经切好的 JSON 片段。即便如此,直接对每个大对象调用 `JSON.parse()`,在嵌套很深、字段很多时,仍可能造成明显卡顿。更稳的方案,是在 Worker 中使用事件驱动的流式解析器,边解析边判断是否保留。
适合放进 Worker 的解析方式
- 可以使用 `stream-json` 或轻量版 `jsonparse`;
- 解析时监听 `startObject` 开始收集对象,监听 `endObject` 时再做一次过滤判断;
- 命中过滤条件的数据,才通过 `self.postMessage(item)` 回传主线程。
过滤逻辑必须尽量留在 Worker 里。例如:
- `item.status === 'active'`
- `item.title.includes(keyword)`
只有匹配的数据再返回主线程,才能真正减轻主线程负担。反过来,如果把原始数据全量回传后再筛选,本质上只是把解析挪了地方,数据搬运成本和主线程压力都还在。
需要传二进制时,用 `Transferable Objects` 避免重复拷贝
当 Worker 处理的不是普通对象,而是压缩 JSON、Base64 编码块,或已经转成 `ArrayBuffer` 的文本数据时,重点就变成“不要复制内存”。这时应该优先使用 `Transferable Objects`。
典型做法是主线程先构造 `Uint8Array` 或 `ArrayBuffer`,填充完后把它的控制权直接交给 Worker:
worker.postMessage({type: 'chunk', buffer}, [buffer])这种写法的特点是零拷贝传输。传递完成后,主线程这边的 `buffer` 会自动失效,表现为 `byteLength === 0`;Worker 拿到的则是同一块底层内存的控制权,而不是一份副本。
哪些类型支持直接转移
- `ArrayBuffer`
- `MessagePort`
- `ImageBitmap`
- `OffscreenCanvas`
- `SharedArrayBuffer`
这部分很适合用在“大文本先转字节流、再进 Worker 解码或解压”的场景里。只要传输对象支持转移,就应优先考虑这条路径,避免结构化克隆带来的额外内存峰值。
补上取消与缓存,才能把体验做完整
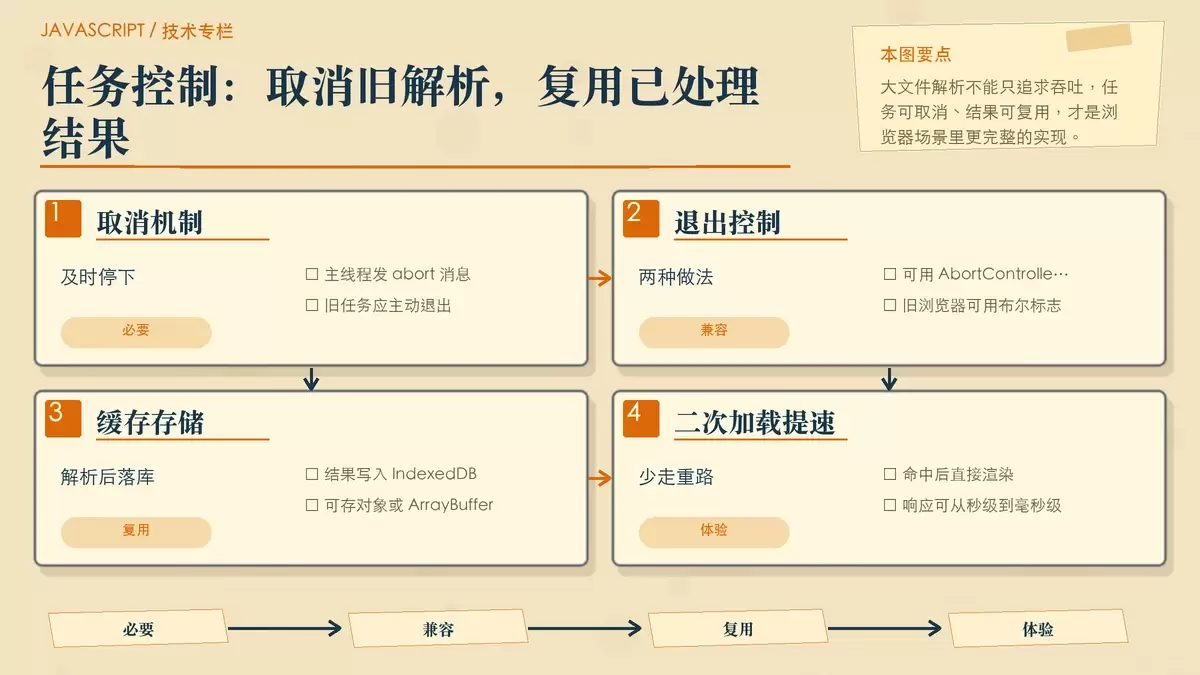
大 JSON 解析往往不是一次性任务。用户可能切换筛选条件、关闭当前页面,或者在数据还没处理完时发起新的请求。如果没有取消机制,旧任务会继续占用 CPU 和内存,Worker 也会白白跑完整个流程。
取消机制怎么放
- 主线程可以发送 `{ type: 'abort' }` 消息;
- Worker 内部用 `AbortController.signal` 监听并主动退出循环;
- 如果要兼容旧浏览器,也可以退回到布尔标志位控制终止。
这样处理后,旧任务就能及时让位给新任务,筛选切换时的响应会更直接。
缓存适合放在哪
对于首次解析成功后的结果,可以直接存入 `IndexedDB`。存储时既可以用 `structuredClone` 存对象,也可以直接保存 `ArrayBuffer`。下次进入同一页面或同一数据集时,先查缓存:
- 命中缓存,直接读取并渲染;
- 未命中,再走下载和解析流程。
这样做的收益很明确:首轮仍然要付出解析成本,但后续访问可以绕开重复解析,响应时间通常能从秒级缩短到毫秒级。
一条更稳妥的落地路径
如果要把这套方案真正落到项目里,可以按下面的顺序收敛实现:
- 先把 `fetch(url).then(r => r.json())` 改成 `response.body.getReader()` 流式读取;
- 根据数据格式选择 JSONL 按行切分,或对标准 JSON 数组做边界识别;
- 把切好的 JSON 片段送进 Worker;
- 在 Worker 内使用 `stream-json` 或 `jsonparse` 做事件驱动解析,并把筛选逻辑放进去;
- 涉及字节流时,优先改用 `Transferable Objects` 传 `ArrayBuffer`;
- 最后补齐 `{ type: 'abort' }` 取消控制和 `IndexedDB` 缓存。
总结来看,在 Web Worker 中高效处理大型 JSON,真正起作用的是一整套链路优化,而不是单点替换。只要同时抓住流式读取、分块解析、零拷贝传输和过滤下沉这几个关键点,大文件 JSON 也能在浏览器里以更可控的内存占用和更平滑的交互完成处理。















