


Python数据分析入门:pandas库安装与核心对象详解

本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
pandas库简介与安装
对于从事数据分析工作的人员而言,pandas 是必须熟练掌握的第三方库。pandas 在科学计算领域具有显著优势,尤其对数据分析师来说至关重要。虽然 Python 中已有 Numpy,但 Numpy 的数学抽象程度较高,因此需要一种更具体地代表数据模型的库。众所周知,在数据处理中,EXCEL 格式的表格模式是展示数据模型的最佳形式。
pandas 旨在对表格数据模型在 Python 环境中进行模拟,它提供了类似 SQL 的数据处理功能,使得在 Python 中实现数据处理变得便捷。
pandas 的安装
在 Python 中安装 pandas 同样使用 pip 工具进行:
pip install pandas核心数据结构:Series与DataFrame
pandas 创建对象
pandas 主要包含两种数据结构:Series 和 DataFrame。
Series对象详解
Series
Series 类似于 Python 中的 list,每个数据元素都拥有自己的索引。可以通过 list 来创建 Series。
>>> import pandas as pd
>>> s1 = pd.Series([100,23,'bugingcode'])
>>> s1
0   100
1   23
2 bugingcode
dtype: object
>>>
在 Series 中可以指定相应的索引值:
>>> import numpy as np
>>> ts = pd.Series(np.random.randn(365), index=np.arange(1,366))
>>> ts
此处 index 设置为从 1 到 366 的数值序列。
Series 的数据结构最接近 Python 中的字典,可以从字典中创建 Series:
sd = {'xiaoming':14,'tom':15,'john':13}
s4 = pd.Series(sd)
此时可以看到 Series 已自动带有索引 index。
pandas 本身与 Python 的另一个第三方库 Matplotlib 有紧密连接,Matplotlib 最常用于数据展示。如果读者对 Matplotlib 尚不熟悉,后续章节将作介绍,此处先直接应用。若未安装,同样使用 pip 命令安装 pip install Matplotlib,展示数据如下:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

ts = pd.Series(np.random.randn(365), index=np.arange(1,366))
ts.plot()
plt.show()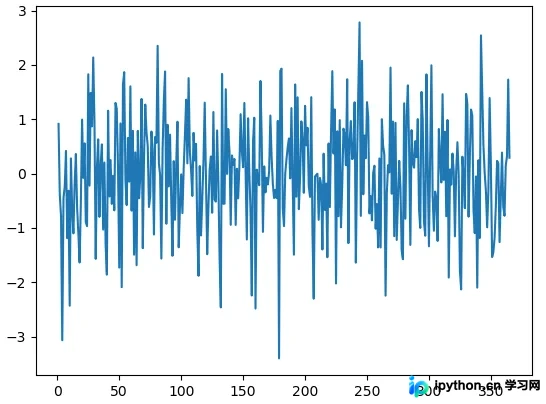
这是一个不规则图形。在数据分析中,时间是一个重要特性,因为许多数据(如销售额、天气)都与时间相关。pandas 中提供了相关时间函数,使用 date_range 可生成一系列时间数据。
>>> pd.date_range('01/01/2017',periods=365)
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03', '2017-01-04',
    '2017-01-05', '2017-01-06', '2017-01-07', '2017-01-08',
    '2017-01-09', '2017-01-10',
    ...
    '2017-12-22', '2017-12-23', '2017-12-24', '2017-12-25',
    '2017-12-26', '2017-12-27', '2017-12-28', '2017-12-29',
    '2017-12-30', '2017-12-31'],
    dtype='datetime64[ns]', length=365, freq='D')
>>>
之前的图形不规则,部分原因是数据不连续,使用 cumsum 可使数据连续:
结果如下:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

ts = pd.Series(np.random.randn(365), index=pd.date_range('01/01/2017',periods=365))
ts = ts.cumsum()
ts.plot()
plt.show()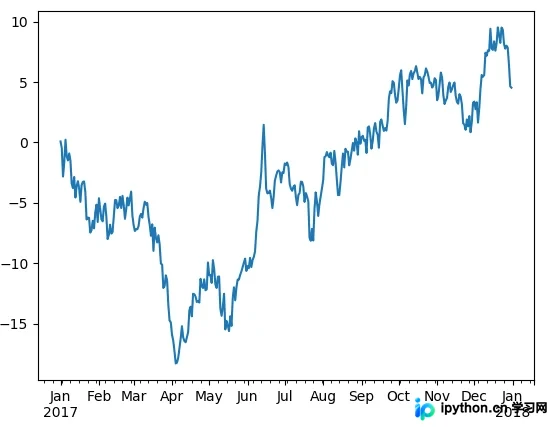
DataFrame对象详解
DataFrame
DataFrame 相当于 Series 的一维扩展,是一种二维数据模型,类似于 Excel 表格中的数据,包含横竖两个坐标轴。横轴类似 Series,使用 index 标识;竖轴通过 columns 确定。在建立 DataFrame 对象时,需确定三个元素:数据、横轴和竖轴。
df = pd.DataFrame(np.random.randn(8,6), index=pd.date_range('01/01/2018',periods=8),columns=list('ABCDEF'))
print df
数据示例如下:
     A   B   C   D   E   F
2018-01-01 0.712636 0.546680 -0.847866 -0.629005 2.152686 0.563907
2018-01-02 -1.292799 1.122098 0.743293 0.656412 0.989738 2.468200
2018-01-03 1.762894 0.783614 -0.301468 0.289608 -0.780844 0.873074
2018-01-04 -0.818066 1.629542 -0.595451 0.910141 0.160980 0.306660
2018-01-05 2.008658 0.456592 -0.839597 1.615013 0.718422 -0.564584
2018-01-06 0.480893 0.724015 -1.076434 -0.253731 0.337147 -0.028212
2018-01-07 -0.672501 0.739550 -1.316094 1.118234 -1.456680 -0.601890
2018-01-08 -1.028436 -1.036542 -0.459044 1.321962 -0.198338 -1.034822
在数据分析过程中,常见情况是数据直接从 excel 或 cvs 导入,可以从 excel 中读取数据到 DataFrame,并在 DataFrame 中进行处理:
df = pd.read_excel('data.xlsx',sheet_name= 'Sheet1')
print df
同样支持将数据保存到 excel 中,使用 to_excel 方法。
处理 cvs 数据的函数为 read_cvs 和 to_cvs,处理 HDF5 的函数为 read_hdf 和 to_hdf。
访问 DataFrame 可以采用类似二维数组的访问方式:
print df['A']提取横轴标签:
2018-01-01 0.712636
2018-01-02 -1.292799
2018-01-03 1.762894
2018-01-04 -0.818066
2018-01-05 2.008658
2018-01-06 0.480893
2018-01-07 -0.672501
2018-01-08 -1.028436
同样可以指定特定元素:
print df['A']['2018-01-01']对数组进行切片,需明确横轴和纵轴:
>>> import pandas as pd
>>> df = pd.read_excel('data.xlsx',sheet_name= 'Sheet1')
>>> df[:][0:3]
     A   B   C   D   E   F
2018-01-01 0.712636 0.546680 -0.847866 -0.629005 2.152686 0.563907
2018-01-02 -1.292799 1.122098 0.743293 0.656412 0.989738 2.468200
2018-01-03 1.762894 0.783614 -0.301468 0.289608 -0.780844 0.873074
>>>
DataFrame 涉及较多函数,后续章节将做更多介绍。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















