



Embedding 模型升级看似只是替换一个接口,真正麻烦的是历史向量会随之失效。对于百万级、千万级数据,重建过程既不能拖垮线上检索,也不能把回填任务做成一次高风险停机操作。下面按工程落地顺序,梳理一套更适合 Go 后端实践的迁移方案:先保证增量不丢,再把存量平滑回填,最后用可量化的检索结果决定是否切流。
为什么换了 Embedding 模型,旧向量不能继续用
向量数据库的迁移,难点并不在“搬数据”,而在“重建语义坐标系”。关系型数据库通常可以通过导出 SQL、同步 Binlog 等方式迁移,但向量数据强依赖生成它的 Embedding 模型。
这意味着,一旦模型从 text-embedding-ada-002 切换到其他模型,例如 DeepSeek 的 Embedding 模型,原来的向量坐标就不再具有可比性。旧向量不是简单“精度变差”,而是从根上失去了与新向量同场检索的意义。
在实际工程里,这个过程通常表现为一次完整的 Re-indexing:把每条历史文本重新送入新模型计算,再把新向量写入新的索引或新集合。真正的压力主要集中在三个方向:
- Embedding API 的 QPS 限制:外部模型接口通常有严格频控。
- 单次计算延迟:一次向量生成可能就是数百毫秒,数据量放大后总耗时会非常可观。
- 向量库写入与建索引成本:高并发导入时,像 HNSW 这类索引结构会持续吃掉 CPU 和内存。
如果没有节奏地并发推进,结果往往是两头出问题:一边是线上检索延迟升高,另一边是回填任务因为内存膨胀甚至 OOM 直接中断。所以,这类迁移不能只看“能不能跑完”,而要设计成可限流、可观测、可回退的流水线。
先保业务连续:蓝绿迁移与双写兜底
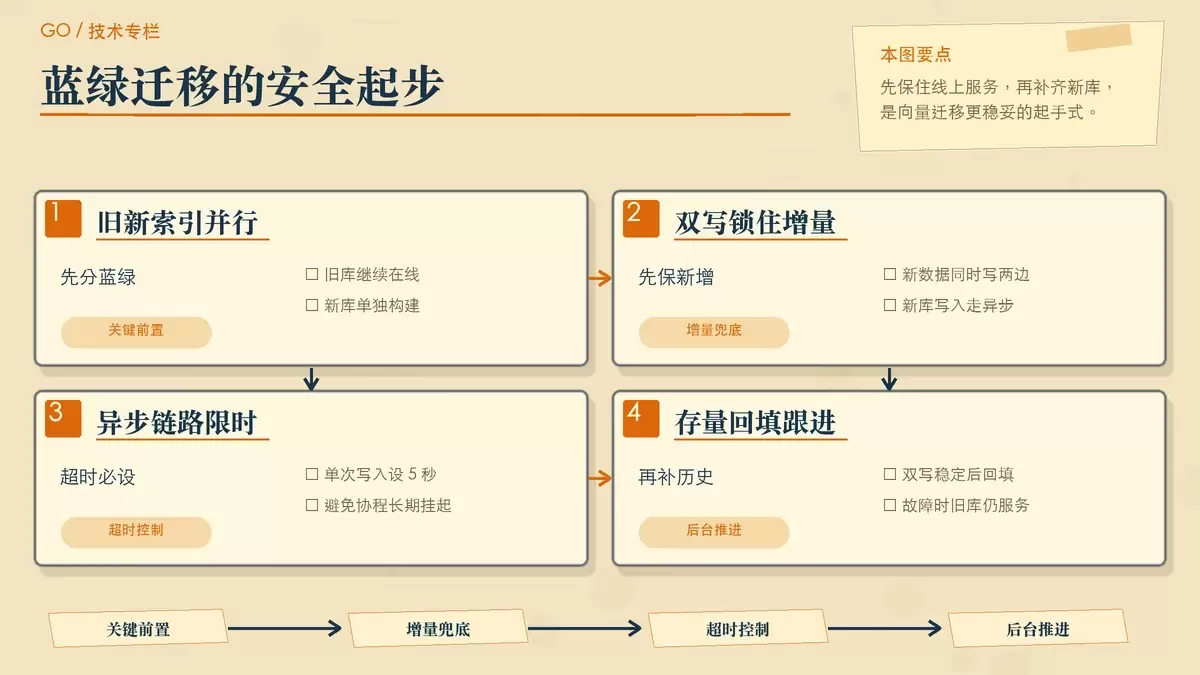
向量库平滑迁移的第一原则,是不要让旧索引在新索引尚未验证前就退出服务。更稳妥的做法是保留旧索引作为蓝环境继续承接线上请求,同时搭建新的绿环境,在后台完成新模型向量的构建与验证。
双写为什么要先上
迁移一开始最容易忽略的是增量数据。如果业务仍在不断写入,而你只顾着回填历史数据,等全量跑完后,新旧库之间已经出现新的缺口。因此,第一步应该先引入 Dual Write:所有新产生的数据,同时写入新老两个向量库。
为了不把主请求链路拖慢,新库写入通常放到异步流程中。简单场景可以直接用 Goroutine;更强调可追踪和解耦的生产环境,则更适合接入 Kafka 这类消息队列。
// 异步双写示例:利用 Goroutine 开启异步写入
go func(doc Document) {
    ctx, cancel := context.WithTimeout(context.Background(), 5*time.Second)
    defer cancel()

    vec, err := newModel.Embed(ctx, doc.Content)
    if err == nil {
        _ = newClient.Upsert(ctx, doc.ID, vec) // 异步写入新索引
    }
}(newData)这段实现里有两个点很关键。第一,context.WithTimeout 把新链路写入时间限制在 5*time.Second 内,避免协程长期挂起;第二,新索引写入放在异步协程中,不阻塞主流程响应。实际落地时,还应该把失败记录到补偿队列或重试日志中,否则双写失败会变成静默丢数。
双写稳定后,再做存量回填
当双写确认稳定,新产生的数据已经持续进入新库后,才适合启动历史数据的 Backfill。这样做的好处很直接:哪怕回填过程中绿环境出故障,蓝环境仍能继续对外服务,迁移不会演变成一次整体停摆。
所以从顺序上看,比较可靠的迁移节奏是:先锁住增量一致性,再处理历史存量,最后再评估切流,而不是一上来就对全库开跑。
Go 回填流水线怎么搭:流式读取加受控并发
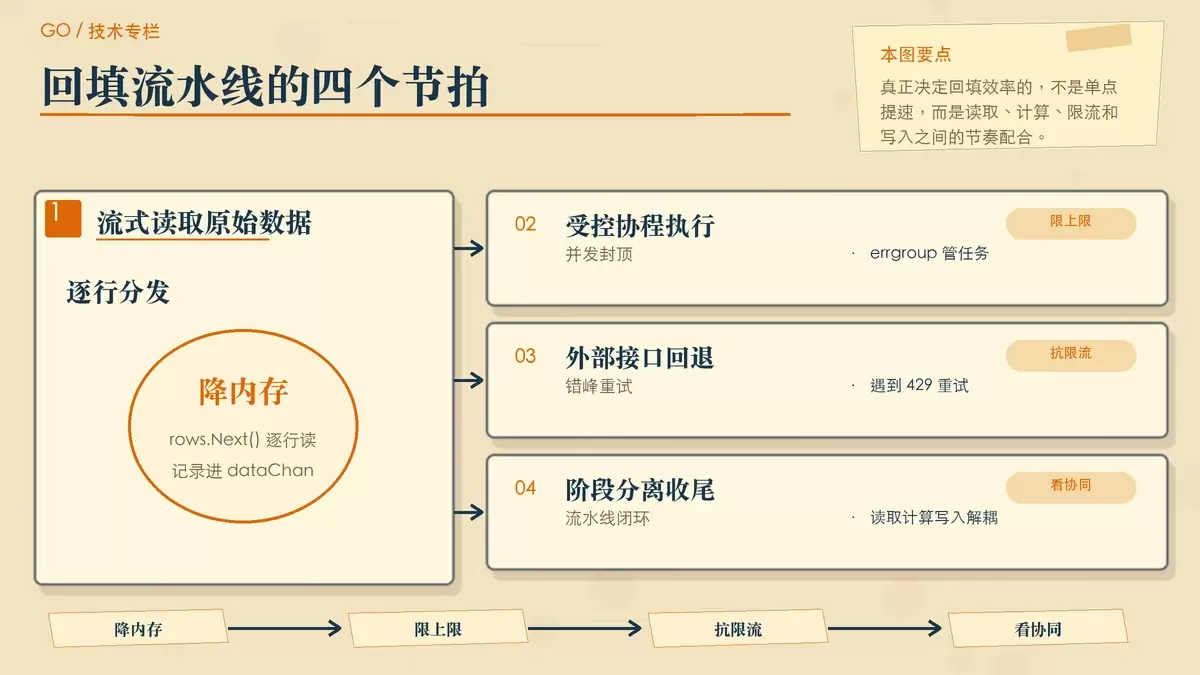
在 Go 中做回填工具,核心不是把逻辑堆进一个大循环,而是把读取、计算、写入拆开,让它们以生产者-消费者模型协同工作。这样既方便限流,也更容易定位瓶颈究竟卡在数据库、模型接口,还是向量库写入端。
先解决内存问题:原始数据必须流式读取
面对百万级文档,最忌讳的就是一次性读入内存再批量处理。只要数据行足够大、字段稍多,内存很快就会被打满。更稳妥的方式是利用 sql.Rows 或数据库游标逐行读取,把每条记录通过通道送到后续处理环节。
// 流式读取数据,将内存消耗降到最低
rows, _ := db.QueryContext(ctx, "SELECT id, content FROM docs")
defer rows.Close()

for rows.Next() {
    var doc Document
    if err := rows.Scan(&doc.ID, &doc.Content); err == nil {
        dataChan <- doc // 放入通道,流式分发
    }
}
rows.Next() 每次只消费一条记录,避免海量数据整体驻留内存;而 dataChan 则把“读取速度”和“处理速度”解耦。只要通道容量设置合理,就能让上游数据库读取和下游 Embedding 计算并行推进,而不是互相等待。
并发不能只靠感觉,直接用 errgroup 控制上限
回填阶段最容易出现的误区,是把 Goroutine 开到很大,试图用“堆并发”换时间。但向量重建高度依赖外部接口,真正先撞上的往往不是 CPU,而是 API 频率限制和下游写入承载能力。
Go 官方扩展包 golang.org/x/sync/errgroup 提供的 SetLimit 很适合这里的需求:既能统一管理错误,又能把同时运行的任务数限制在明确范围内。
// 并发控制:利用 errgroup 精准限制最大并发数为 50
g, ctx := errgroup.WithContext(mainCtx)
g.SetLimit(50)

for doc := range dataChan {
    doc := doc
    g.Go(func() error {
        return processWithRetry(ctx, doc)
    })
}
_ = g.Wait() // 确保等待所有并发任务安全结束
这里的 g.SetLimit(50) 指定了最大并发数为 50。达到上限后,新的 g.Go 调用会阻塞,直到已有任务结束。相比手写 Channel 信号量,这种写法更集中,也更容易和错误处理、上下文取消机制结合。
别忽略最后的 g.Wait()。它不只是“等一等”这么简单,而是整个任务收口的关键点:只有等所有子任务结束,才能判断这次回填批次是否真正完成。
如果 processWithRetry 遇到 429,重试策略建议采用带 Jitter 的指数退避。原因是单纯固定间隔重试很容易让一批协程在同一时间再次苏醒,形成第二波冲击,限流问题会被放大而不是缓解。
写入阶段怎么提速:暂缓索引构建,再集中生成
向量回填慢,不一定都慢在 Embedding 计算。很多时候,写入端真正昂贵的是索引实时构建,尤其是 HNSW 这种图结构索引。边写边建索引,会让导入吞吐明显下降,还可能推高 CPU 与内存占用。
更高效的办法是把“写入原始向量”和“构建检索索引”拆成两个阶段:回填期间先尽量快地落盘,等全量数据进入新库后,再恢复正常索引阈值,让系统后台集中完成建索引。
以 Qdrant 为例,可以在创建新集合时把 IndexingThreshold 设为 0,临时关闭索引构建。
// Qdrant 临时禁用索引,以最大化写入吞吐量
_, _ = client.CreateCollection(ctx, &qdrant.CreateCollection{
    CollectionName: "new_vectors",
    VectorsConfig: qdrant.NewVectorsConfig(&qdrant.VectorParams{
        Size: 1024, Distance: qdrant.Distance_Cosine,
    }),
    OptimizersConfig: &qdrant.OptimizersConfigDiff{
        IndexingThreshold: qdrant.PtrOf[uint64](0), // 阈值设为 0
    },
})在这段配置中,IndexingThreshold: qdrant.PtrOf[uint64](0) 的含义很明确:回填期间只做追加写入,不急着把数据实时合入 HNSW 图结构。对于全量导入任务,这通常能显著减轻计算压力。
等到回填完成后,再把阈值调整回正常值,例如 20000,由向量库在后台统一构建索引。原文给出的经验值显示,这种做法可以把整体写入时间缩短 40%-60%。是否能达到这个幅度,还取决于向量维度、磁盘与 CPU 资源,以及集合规模,但方向通常是成立的。
别只盯吞吐:内存复用和切换校验同样关键
迁移任务跑得快,只代表任务可能更早结束;要想真正可上线,还得同时解决长时间运行的稳定性,以及切流前的质量验证问题。
用 sync.Pool 缓解切片分配压力
高维向量一般以 []float32 表示。数据规模一旦上来,大量切片的重复创建与释放会持续增加 GC 压力。尤其在长时间批处理任务中,这类“小分配很多次”的模式,常常比单次大对象更难察觉。
// 利用 sync.Pool 复用切片内存,降低 GC 压力
var pool = sync.Pool{
    New: func() any { return make([]float32, 0, 1024) },
}

func process(doc Document) {
    buf := pool.Get().([]float32)[:0]
    defer pool.Put(buf) // 必须放回 Pool 才能实现复用!
    // ... 执行计算与写入 ...
}
这里通过 sync.Pool 复用容量为 1024 的 []float32 缓冲区,拿到后先切成 [:0],在保留底层数组的同时把逻辑长度清零。关键动作是 defer pool.Put(buf),否则对象池只有取出没有归还,复用机制就失效了。
这种方式不能替代所有内存优化,但对于持续运行的回填程序,往往能明显减轻 GC 扫描压力,让任务吞吐和延迟曲线更稳定。
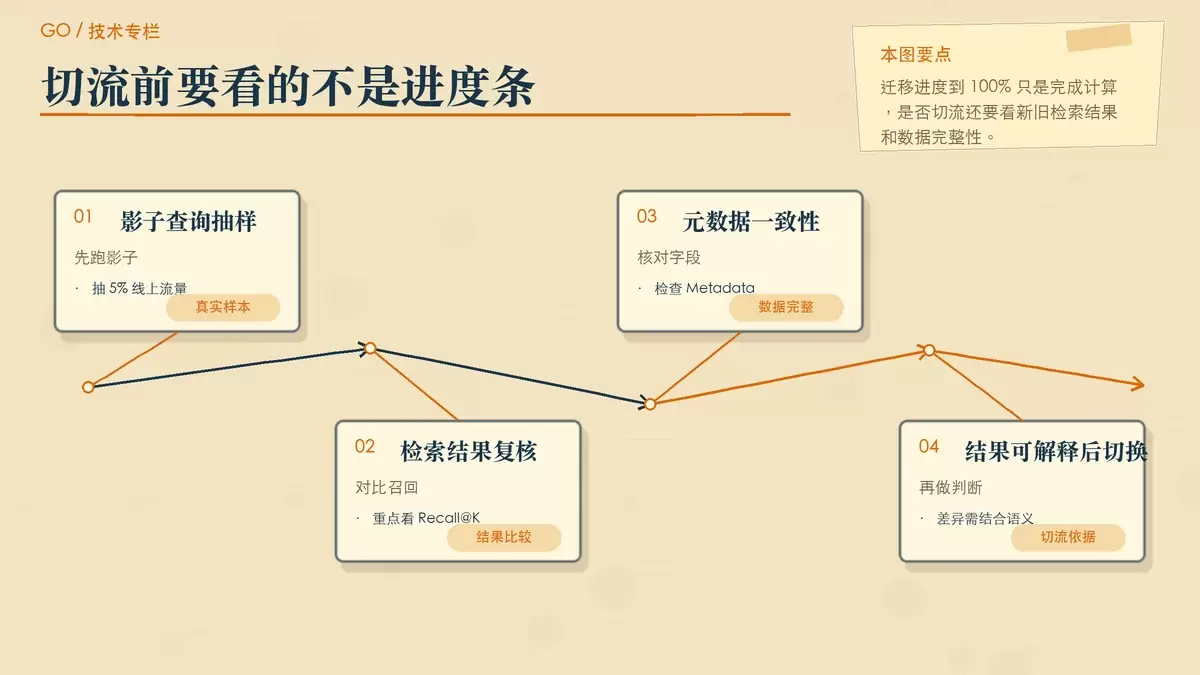
切流前必须做影子查询,而不是只看进度 100%
迁移完成不等于可切换。新索引是否真的能接住线上检索,还需要在流量层面验证效果。比较常见的方式,是对一部分真实请求执行 Shadow Query:同一查询同时打到新旧两个索引,然后比较结果差异。
可以重点检查三类信息:
- 并行检索覆盖率:例如抽取
5%的真实线上流量,同时查询新旧索引。 - 召回结果差异:对比 Recall@K,尤其观察 Top 10 结果变化是否异常。
- 元数据一致性:确认 Metadata 没有在迁移过程中丢失、错位或格式异常。
这里有一个常见误区:新旧 Top 10 不一致,不一定就是新模型退化。Embedding 模型一旦改变,语义空间本来就会变化。真正需要判断的是,结果差异是否符合业务预期,是“召回更好”还是“相关性偏移”。因此,影子查询的价值不只是找 bug,更是为切流提供业务可解释的依据。
这类迁移本质上是一次工程化重建
向量数据库迁移与传统数据库迁移最大的不同,在于它不是简单的数据复制,而是一次围绕新模型展开的全量重算。要把这件事做稳,关键不是依赖某个现成“迁移按钮”,而是把过程拆成几段清晰、可控的工程步骤。
从实践顺序看,比较稳妥的路径是:先用蓝绿架构保住旧链路服务,再通过双写锁住增量一致性;随后用 Go 的流式读取、errgroup 并发限制和重试机制完成历史回填;在写入端临时降低索引构建开销,用 sync.Pool 控制内存波动;最后再通过影子查询和召回对比决定是否正式切换流量。
模型迭代只会越来越频繁。掌握这套平滑重构方法,解决的不只是一次 Embedding 更换,而是让 AI 系统以后每次升级都具备更高的可迁移性和韧性。















