


Python实现简易推荐系统:从原理到代码实战

本文通过不到40行Python代码,详解如何构建一个简单的电影推荐系统。文章介绍了基于内容和协同过滤(用户与物品)的推荐原理,利用Pandas处理ratings.csv和movies.csv数据,通过计算皮尔逊相关系数并过滤低评分电影,实现个性化推荐。适合希望理解推荐系统底层逻辑的初学者。
推荐系统概述
推荐系统概述
根据维基百科的定义,推荐系统是资讯过滤技术的一种具体应用。其核心功能是将用户可能感兴趣的资讯或实物(如电影、电视节目、音乐、书籍、新闻、图片及网页等)精准推送给使用者。
从本质上看,推荐系统依据用户的历史行为数据,针对性地推送其更可能感兴趣的内容。以网易云音乐为例,用户收听和收藏的音乐越多,系统就越能捕捉其偏好,从而推荐符合其口味的音乐作品。
推荐系统的工作机制大致如下:
假设用户A收藏了歌曲a、b和c,而用户B收藏了歌曲a和b。此时,推荐系统会将歌曲c推荐给用户B。算法的逻辑在于判断用户A与用户B在音乐品味上具有高度的一致性,因此用户A喜欢的内容,用户B也可能喜欢。
推荐算法的主要分类
推荐算法的主要分类
主流的推荐算法主要分为基于内容的推荐和协同过滤两大类。其中,协同过滤又可细分为基于用户的协同过滤和基于物品的协同过滤。 基于内容的推荐直接评估推荐内容本身与目标用户历史行为的相关性。例如在文章推荐场景中,算法会计算某篇文章与用户历史阅读文章之间的相似度,进而进行推荐。
基于用户的协同过滤即前文所举的例子,通过寻找相似用户群体来进行推荐。
基于物品的协同过滤逻辑如下:
假设用户A、B、C都收藏了音乐a和b,而用户D仅收藏了音乐a。此时,系统会将音乐b推荐给用户D。其原理是,既然用户D喜欢音乐a,而音乐a与音乐b常被同一群体收藏,则音乐b可能是用户D潜在感兴趣的内容。
动手构建推荐系统
动手构建推荐系统
本示例旨在构建一个简单的电影推荐模型。尽管该模型距离工业级应用尚有巨大差距,但非常适合新手理解推荐系统的内部运作原理。所需数据集包含两个文件:ratings.csv和movies.csv。
数据预处理与合并
# 载入数据
import pandas as pd
import numpy as np
df = pd.read_csv('data/ratings.csv')
df.head()
ratings.csv文件包含以下四个维度的数据:
- userId:进行评分的用户ID
- movieId:被评分电影的ID
- rating:用户对电影的评分,取值范围为[1, 5]
- timestamp:电影被评分的时间戳
为了获取电影名称,需从movies.csv中读取数据。
movies = pd.read_csv('data/movies.csv')
movies.head()
接下来,根据movieId将ratings.csv与movies.csv的数据进行合并处理。
df = pd.merge(df, movie_title, on='movieId')
df.head()
本推荐系统的核心逻辑如下:
- 首先,基于所有用户的评分数据,计算所有电影与用户a已观看的某部电影A之间的相似度。
- 然后,向用户a推荐那些与电影A相似度高且评分较高的电影。
为此,我们需要构建一个包含所有用户对所有电影评分的列联表(矩阵)。
构建评分矩阵与相关性计算
movie_matrix = df.pivot_table(index = 'userId', columns = 'title' ,values = 'rating')
movie_matrix.head()
假设用户A观看的电影是《空军一号》(Air Force One, 1997),则需计算列联表中所有其他电影与该电影的相关性。
AFO_user_rating = movie_matrix['Air Force One (1997)']
simliar_to_air_force_one = movie_matrix.corrwith(AFO_user_rating)
通过上述计算,我们得到了所有电影与《空军一号》(1997)的相关性系数。
然而,直接对该相关性进行排序并推荐最相关的电影存在一个严重问题:
数据过滤与最终推荐
ratings = pd.DataFrame(df.groupby('title')['rating'].mean())#计算电影平均得分
ratings['number_of_ratings'] = df.groupby('title')['rating'].count()
import matplotlib.pyplot as plt
%matplotlib inline
ratings['number_of_ratings'].hist(bins = 60);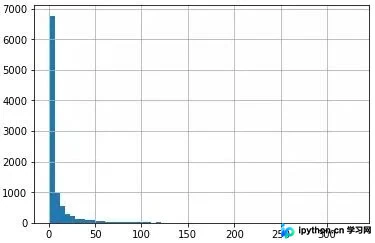
上图展示了电影被评分次数的直方图。数据显示,大量电影的评分次数不足10次。由于样本量过小,这些电影极易被错误地判定为高相关性。因此,我们需要剔除评分次数过少的电影数据。
corr_AFO = pd.DataFrame(similar_to_air_force_one, columns = ['Correlation'])
corr_AFO.dropna(inplace = True)
corr_contact = corr_contact.join(ratings['number_of_ratings'],how = 'left',lsuffix='_left', rsuffix='_right')
corr_AFO[corr_AFO['number_of_ratings']>100].sort_values(by = 'Correlation',ascending = False).head()
经过上述过滤,我们得到了与《空军一号》(1997)高相关的电影列表。虽然高相关性可能伴随低评分(尽管概率较低),但我们可以进一步从该列表中筛选出平均得分较高的电影进行最终推荐。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















