


pandas DataFrame 交集、并集与补集操作详解

发布时间:2026-10-13 |
2人浏览过
本文介绍在 columns 相同的 DataFrame 中进行集合运算的方法。利用 pd.merge 配合 on 参数可获取交集,设置 how='outer' 获取并集。对于补集(从 df1 中剔除 df2 存在的行),通过 append 合并后使用 drop_duplicates 保留唯一值实现。
DataFrame 集合运算场景介绍
在处理具有相同列结构的 DataFrame 时,经常需要对数据进行过滤和集合操作。
假设存在两个 DataFrame,其列名完全一致,我们需要在此基础上进行后续操作。
df1 = DataFrame([['a', 10, '男'],
         ['b', 11, '男'],
         ['c', 11, '女'],
         ['a', 10, '女'],
         ['c', 11, '男']],
        columns=['name', 'age', 'sex'])

df2 = DataFrame([['a', 10, '男'],
         ['b', 11, '女']],
        columns=['name', 'age', 'sex'])
交集与并集的实现方法
计算两个 DataFrame 的交集时,可以使用 merge 函数并指定共同的列名列表。例如:print(pd.merge(df1,df2,on=['name', 'age', 'sex']))
若要计算并集,同样使用 merge 函数,但需指定 how 参数为 'outer'。例如:print(pd.merge(df1,df2,on=['name', 'age', 'sex'], how='outer'))
差集(补集)的过滤逻辑
计算差集(即从 df1 中移除在 df2 中存在的行,也可视为补集操作):
df1 = df1.append(df2)
df1 = df1.append(df2)
df1 = df1.drop_duplicates(subset=['name', 'age', 'sex'],keep=False)
print(df1)
具体实现代码如下:
# -*- coding:utf-8 -*-
__version__ = '1.0.0.0'
"""
@brief :  简介
@details:  详细信息
@author :  zhphuang
@date  :  2018-10-29
"""

import pandas as pd
from pandas import *

df1 = DataFrame([['a', 10, '男'],
         ['b', 11, '男'],
         ['c', 11, '女'],
         ['a', 10, '女'],
         ['c', 11, '男']],
        columns=['name', 'age', 'sex'])
print("df1:\n%s\n\n" % df1)
df2 = DataFrame([['a', 10, '男'],
         ['b', 11, '女']],
        columns=['name', 'age', 'sex'])
print("df2:\n%s\n\n" % df2)
# 取交集
print("交集:\n%s\n\n" % pd.merge(df1,df2,on=['name', 'age', 'sex']))

# 取并集
print("并集:\n%s\n\n" % pd.merge(df1,df2,on=['name', 'age', 'sex'], how='outer'))

# 从df1中过滤df1在df2中存在的行,也就是取补集
df1 = df1.append(df2)
df1 = df1.append(df2)
print("补集(从df1中过滤df1在df2中存在的行):\n%s\n\n" % df1.drop_duplicates(subset=['name', 'age', 'sex'],keep=False))
运行结果截图如下:
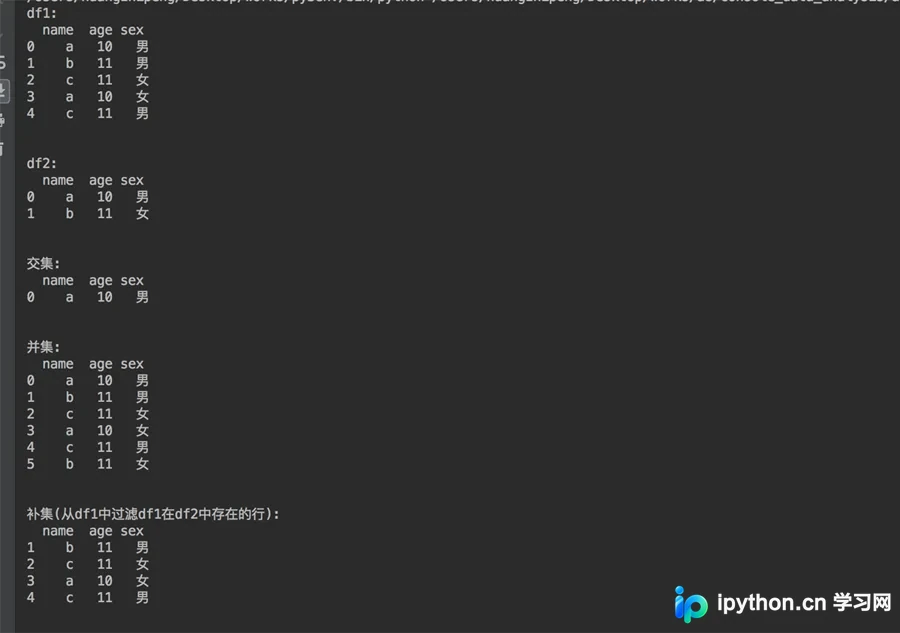
以上内容涵盖了 DataFrame 常见集合运算的实现方式,希望对读者有所帮助,欢迎继续支持本站获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















