



在 Go 编写的高并发系统里,开发者经常会遇到同一个问题:一个执行单元要同时盯住大量 I/O 事件,既不能继续沿用“一连接一线程”的高成本模型,也不能把 CPU 浪费在无意义轮询上。Go 的多路复用能力正是为这类场景服务的,但它并不等同于单纯会写一个 select。
这篇文章按“概念定义 - 运行机制 - 实战用法 - 适用边界”的顺序展开,把 select、goroutine 调度和操作系统 I/O 事件模型放到同一张图里理解。读完后,你可以更清楚地判断:什么时候它能明显提升并发效率,什么时候又该把优化重点转向别处。
Go 多路复用到底解决了什么问题
多路复用(I/O Multiplexing)的核心,是用统一的执行单元监听多个 I/O 事件源,只要其中任意一个事件就绪,就立即分发处理。它改变的不是某一行语法,而是“事件必须绑定独立执行单元”的传统思路。
在高并发服务里,这种模式的价值非常直接:
- 单个
goroutine可以高效管理大量并发事件,减少线程和调度开销。 - 避免“一连接一线程”带来的频繁上下文切换。
- 比简单循环轮询更节省 CPU,不会长期空转等待。
Go 的优势在于,这套机制不是靠开发者手动拼装出来的。语言层面有 goroutine 和 channel,语法层面有 select,运行时还会自动封装不同平台上的底层 I/O 模型。也就是说,业务代码可以保持统一,而底层由 runtime 去适配 Linux 的 epoll、macOS 的 kqueue 以及 Windows 的 IOCP。
因此,Go 多路复用的真正意义,不只是“并发写起来更短”,而是把资源调度模式从“多线程抢占”转成“事件驱动协同”,在有限资源下承接更高的并发规模。
从 select 到内核事件:Go 是怎么把它串起来的
Go 的多路复用可以理解为一个分层结构:上层由 select 管理 channel 事件,下层由 runtime 对接操作系统提供的 I/O 事件通知机制,再配合调度器安排 goroutine 的挂起和唤醒。
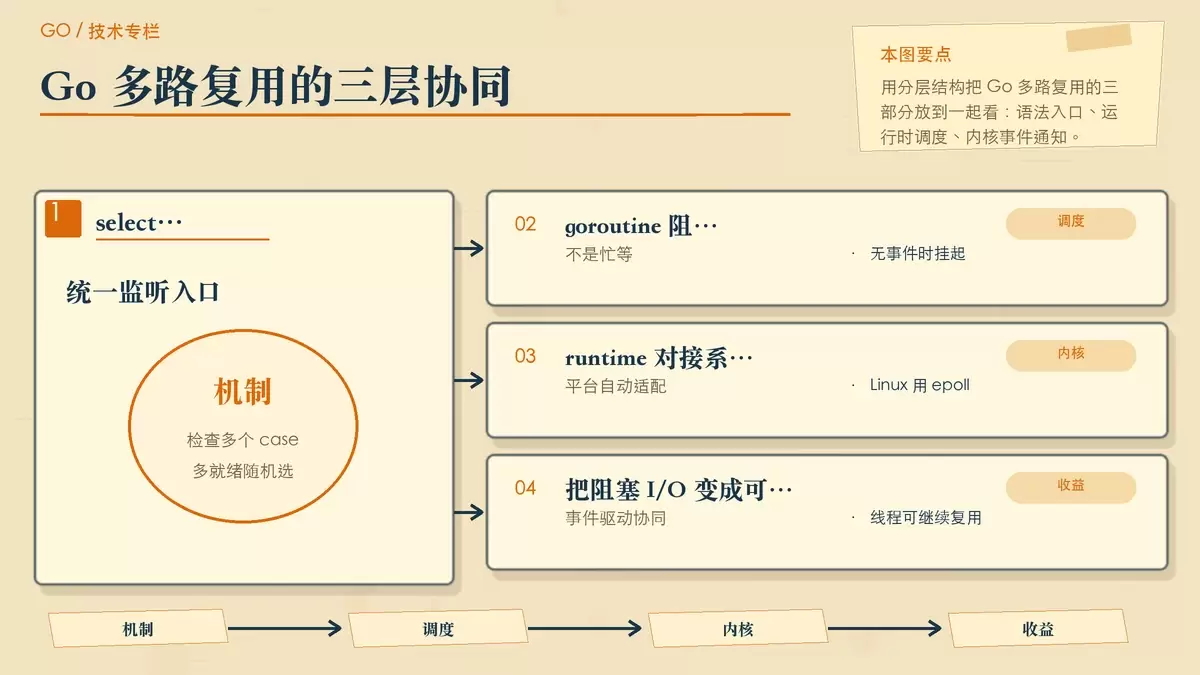
select 的工作流程:轮询、阻塞、唤醒
select 是 Go 并发编程里最常见的多路监听入口,但它只面向 channel 的原子操作。它的执行过程可以概括为三步:
- 遍历各个
case,检查通道是否就绪。 - 如果有多个
case同时就绪,随机选择一个,避免长期偏向某个分支。 - 如果没有任何
case就绪,当前goroutine会阻塞,并登记到对应通道的等待队列中,待条件满足后再被唤醒。
这里有一个需要特别注意的点:如果 select 带有 default 分支,那么当其他 case 都未就绪时,它不会阻塞,而是直接执行 default。这意味着 select 会从阻塞模式变成非阻塞模式。
这种写法适合“快速探测状态”或“需要立刻返回”的逻辑,但如果把它放进高频循环中,又没有节流措施,就很容易造成 CPU 空转。很多看似“响应很快”的代码,瓶颈恰恰就出在这里。
runtime 如何对接底层 I/O 模型
当场景进入网络 I/O,单靠 select 还不够,因为真正的套接字可读、可写状态,需要内核负责通知。Go 在这一层的做法是:由 net 包与 runtime 屏蔽平台差异,把开发者从具体系统调用细节里解放出来。
不同平台对应的底层模型如下:
| 运行平台 | 底层 I/O 多路复用模型 | 核心特性与优势 |
|---|---|---|
| Linux 2.6+ | epoll | 基于事件驱动,支持水平触发(LT)与边缘触发(ET),采用红黑树管理文件描述符,事件查询时间复杂度为 O(1),可高效处理万级以上并发连接 |
| macOS/FreeBSD | kqueue | 支持文件、管道、网络等多种事件类型,事件通知延迟低,支持事件过滤与优先级设置,适配 BSD 类系统的底层特性 |
| Windows | IOCP(I/O 完成端口) | 基于异步 I/O 模型,通过线程池管理完成事件,避免线程上下文切换开销,是 Windows 平台高并发 I/O 的最优选择 |
这层封装的关键,不是简单调用某个系统接口,而是把文件描述符(FD)与等待中的 goroutine 关联起来。某个 I/O 操作暂时不可继续时,相关 goroutine 会挂起,线程资源则交还给调度器,用于执行其他任务;等内核发出事件通知,再把对应 goroutine 唤醒继续执行。
最终形成的是一条完整链路:内核负责发现事件,runtime 负责接收通知和调度,业务代码通过 select、channel 和 goroutine 完成表达。Go 的高并发能力,本质上就是这几层协同工作的结果。
三类常见场景,怎么把多路复用真正用起来
理解原理之后,更重要的是知道它在什么场景里最值钱。下面这三类写法,覆盖了服务调用、网络连接管理和后台任务调度三个高频方向。
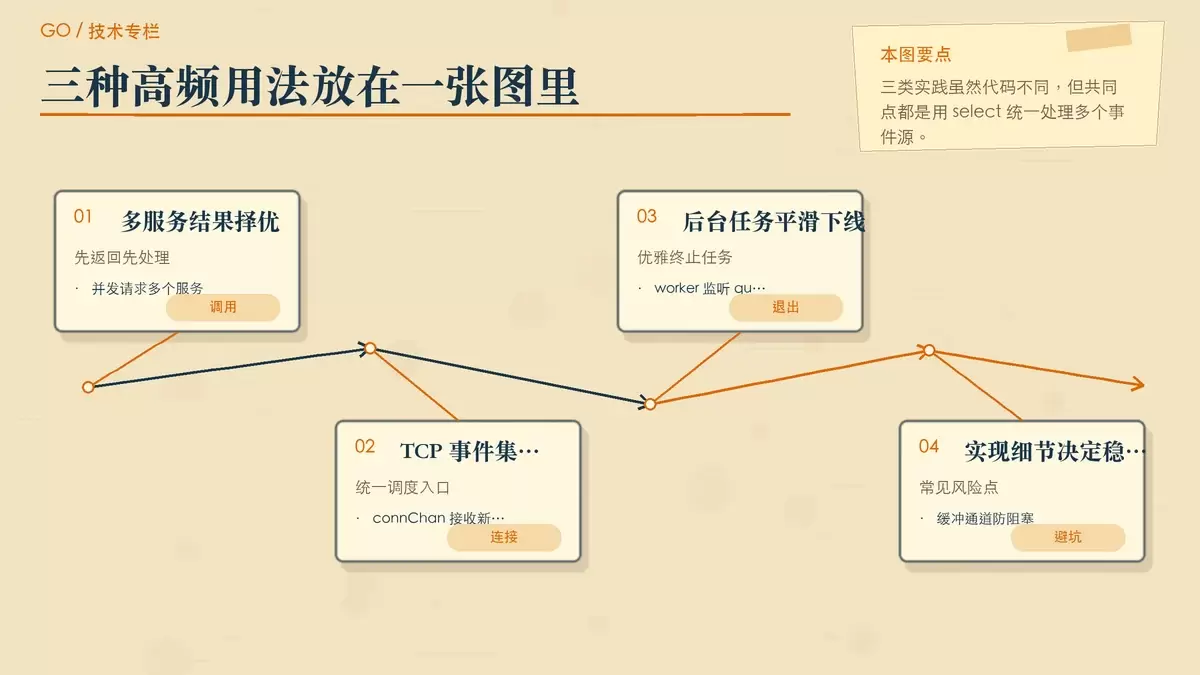
场景一:并行调用多个服务,并做超时控制
微服务系统里,一个请求往往要同时调用多个下游服务。有时要取最快返回结果,有时要做兜底或降级。这类需求和 select 的模型天然契合:多个调用并发发起,谁先返回就先处理,同时保留超时退出机制。
// 伪代码:多服务并行调用(核心逻辑)
func callMultiServices(req Request) (Response, error) {
    resA, resB := make(chan Response,1), make(chan Response,1)
    go func() { resp, _ := serviceA.Call(req); resA <- resp }()
    go func() { resp, _ := serviceB.Call(req); resB <- resp }()

    select {
    case resp := <-resA: return resp, nil
    case resp := <-resB: return resp, nil
    case <-time.After(500 * time.Millisecond):
        return Response{}, errors.New("超时")
    }
}
这段逻辑有几个关键点不能省:
- 响应通道使用缓冲区,例如
make(chan Response,1),可以降低 goroutine 因接收方提前返回而卡住的风险。 select让“多个结果竞争同一个出口”变得很自然,代码也比手写锁或状态轮询更清晰。time.After(500 * time.Millisecond)这种超时控制通常是必选项,否则某个下游长期无响应时,请求链路就可能被整体拖住。
如果场景继续复杂化,比如既要取最快结果,又要收集其他分支状态,就不能只停留在“谁先返回用谁”的简化模式上,而需要进一步加入取消信号、结果聚合和错误传播机制。不过就多路复用的核心思路来说,这个模式已经非常典型。
场景二:高并发 TCP 服务中的统一事件管理
当服务端要维护大量 TCP 连接时,问题不再只是“收一个请求回一个响应”,而是怎样统一接入连接事件、消息事件和退出信号。比较常见的做法,是用全局通道把这些事件汇聚到调度 goroutine 中集中处理。
// 伪代码:TCP服务多路复用(核心逻辑)
func startTCPServer(addr string) {
    listener, _ := net.Listen("tcp", addr)
    msgChan, connChan, quit := make(chan ClientMsg,1024), make(chan net.Conn), make(chan struct{})

    go func() {
        for { connChan <- listener.Accept() }
    }() // 接收连接
    go func() { // 核心调度逻辑
        conns := make(map[net.Conn]struct{})
        for {
            select {
            case conn := <-connChan:
                conns[conn] = struct{}{}; go handleConn(conn, msgChan)
            case msg := <-msgChan:
                processClientMsg(msg)
            case <-quit:
                for c := range conns { c.Close() }
            }
        }
    }()
    <-syscall.SIGINT; close(quit)
}
这类结构的重点,在于把职责拆清楚:
- 连接接收层负责监听新连接,把新连接送进
connChan。 - 调度层负责统一监听
connChan、msgChan和quit,决定系统状态如何推进。 - 具体连接处理层负责读取客户端数据,再把业务消息汇总进
msgChan。
这种“接收连接 - 调度 - 处理”的三级结构,可以把大量离散连接压缩进一套统一事件流里,便于做统计、广播、限流和退出控制。
实际工程中还要额外注意两件事。第一,退出流程必须可回收,像示例中那样用 quit 统一触发连接关闭,是防止资源泄漏的基础。第二,调度 goroutine 本身不要承担过重业务逻辑,否则它会从“统一入口”变成新的瓶颈点。
场景三:任务调度中的优雅终止与资源清理
多路复用不只适用于网络 I/O,在后台任务系统里同样常见。一个 worker 往往需要同时等待“有新任务可执行”以及“系统准备退出”两种事件,用 select 监听这两个方向,代码会比手工轮询更加直接。
// 伪代码:WorkerPool优雅终止(核心逻辑)
type WorkerPool struct{
    taskChan chan Task
    quit chan struct{}
}

func (wp *WorkerPool) worker(id int) {
    for {
        select {
        case task := <-wp.taskChan:
            task.Execute() // 执行业务
        case <-wp.quit:
            wp.cleanResources(id);
            return // 优雅退出
        }
    }
}

func NewWorkerPool(n int) *WorkerPool {
    wp := &WorkerPool{make(chan Task,100), make(chan struct{})}
    for i:=0; i<n; i++ {
        go wp.worker(i)
    }
    return wp
}
func (wp *WorkerPool) Shutdown() {
    close(wp.quit)
}
这个模式的好处,在于退出条件被明确纳入主循环,不需要在外层再加额外状态判断。它带来的工程价值主要有三点:
- worker 会一直阻塞等待任务或退出信号,不会因为轮询而额外占用 CPU。
- 关闭
quit后,所有 worker 都能感知到退出事件,并执行各自清理逻辑。 - 当任务系统需要平滑下线时,这种写法比强制中断更容易保证资源一致性。
如果系统还要求“先停止接收新任务,再等待已接任务执行完成”,那么在 Shutdown() 之外,还需要补充对 taskChan 生命周期的控制。原理并不复杂,但它提醒我们:多路复用负责的是事件协调,不自动替你完成完整的任务收敛策略。
适用边界:什么时候值得用,什么时候别高估它
Go 多路复用的主要优势,集中在 I/O 密集型场景,比如网络通信、文件操作、数据库访问等。在这些地方,程序的大量时间都耗在“等待事件就绪”上,事件驱动调度能显著提高资源利用率。
但如果问题本质上是 CPU 密集型,例如大量计算、复杂编解码或高强度数据处理,那么多路复用并不会直接带来同等收益。此时更有效的手段通常是:
- 根据负载调整
GOMAXPROCS。 - 优化任务拆分粒度,减少不必要的竞争。
- 重新审视热点计算逻辑,而不是继续堆叠
select。
换句话说,Go 多路复用不是“高并发万能药”。它擅长解决的是等待型并发,而不是所有类型的性能问题。
真正想把它用好,关键不只是会写语法,而是理解这套机制背后的调度关系:goroutine 为什么能轻量,select 为什么能统一事件入口,底层内核通知又是怎样把阻塞 I/O 变成可调度事件。只有在这些认识清楚之后,开发者才能在“代码简洁”和“运行效率”之间做出更稳的判断。















