



不少 Go 项目都会在 goroutine 入口或 HTTP 中间件里加一层 recover(),希望程序即使出错也别直接崩。问题在于,这种做法很容易让人产生错觉:只要加了 recover(),异常就都能被拦下来。
实际并不是这样。Go 里有些问题属于普通 panic,可以恢复;有些则是运行时认定的致命错误,一旦触发就会直接终止进程。下面按“哪些能接住、哪些接不住、为什么接不住、该怎么预防”四个问题来梳理,方便你在排查线上崩溃时快速判断。
哪些异常可以被 recover 捕获
先看结论:凡是通过 runtime.panic() 抛出的异常,通常都能在正确位置用 recover() 接住。常见场景包括下标越界、空指针解引用、向未初始化 map 写入、类型断言失败。
下标越界
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err)
        }
    }()
    nums := []int{}
    fmt.Println(nums[1]) // 越界访问,触发panic
}
切片或数组访问越界时,运行时会触发 panic。只要 recover() 放在同一 goroutine 的延迟调用里,这类错误就能被捕获。
空指针解引用
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err)
        }
    }()
    var str *string
    fmt.Println(*str) // 空指针解引用
}
这也是 Go 中最常见的运行时 panic 之一。它说明代码访问了一个值为 nil 的指针,但从机制上仍属于可恢复错误。
未初始化 map 写操作
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err)
        }
    }()
    var mp map[string]int
    mp[""] = 1 // 对未初始化的map进行写操作
}
声明了 map 但没有初始化,直接写入时会触发 panic。这类问题在线上并不少见,尤其容易出现在结构体字段默认值没有补齐的场景里。
类型断言失败
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("panic")
        }
    }()
    var str interface{} = "123"
    _ = str.(int) // 类型断言失败
}
当接口中的真实类型与断言目标不一致时,会触发 panic。如果业务上预期可能失败,更稳妥的写法通常是使用 v, ok := x.(T) 这种双返回值形式,而不是把断言失败交给恢复逻辑处理。
哪些致命错误是 recover 也接不住的
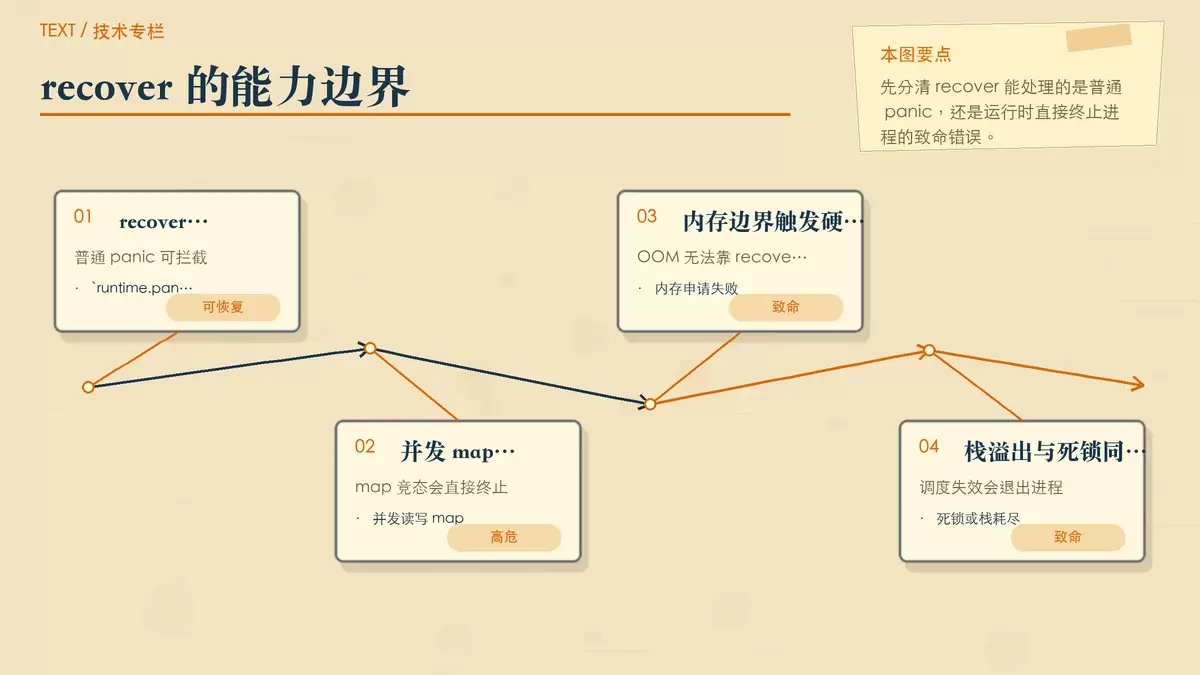
这部分才是线上事故里最容易误判的地方。代码里即便已经写了 defer recover(),下面这些情况照样可能让进程直接退出。
并发读写 map
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err) // 这行代码不会执行
        }
    }()

    m := map[string]int{}
    // goroutine 1: 写操作
    go func() {
        for {
            m["x"] = 1
        }
    }()
    // goroutine 2: 读操作
    for {
        _ = m["y"]
    }
}
这类错误会报出 fatal error: concurrent map writes。它之所以危险,不只是“发生了竞态”,更关键的是运行时认为 map 的内部状态可能已经被破坏,继续跑下去不再可信,所以直接以致命错误结束进程。
这也是实际项目中最常见的一类“以为能 recover,结果服务照样崩”的问题。
内存溢出 OOM
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err) // 这行代码不会执行
        }
    }()

    _ = make([]int64, 1<<40) // 尝试分配超大内存
}
当程序已经无法拿到继续执行所需的内存,恢复本身就失去了基础条件。这种情况下,指望 recover() 把程序“拉回来”并不现实。
栈空间耗尽
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err) // 这行代码不会执行
        }
    }()

    var fun func([1000]int64)
    fun = func(i [1000]int64) {
        fun(i) // 无限递归,导致栈溢出
    }
    fun([1000]int64{})
}
无限递归会不断吃掉栈空间,直到运行时报出 runtime: goroutine stack exceeds 1000000000-byte limit。这说明 goroutine 已经没有足够栈空间继续完成正常的异常处理流程。
启动 nil 函数
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err) // 这行代码不会执行
        }
    }()

    var f func()
    go f() // 启动一个nil函数
}
这里会触发 fatal error: go of nil func value。问题不在于业务逻辑抛出了一个普通 panic,而是运行时在创建 goroutine 时就发现执行目标本身非法,因此直接按致命错误处理。
程序死锁
func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("err:", err) // 这行代码不会执行
        }
    }()

    // 所有goroutine都处于休眠状态,产生死锁
    <-make(chan int)
}
当所有 goroutine 都进入阻塞且没有任何继续推进的可能时,Go 运行时会判定程序已经死锁。此时不是某段业务代码出错,而是整个调度状态已经无法前进,所以它会直接抛出致命错误终止程序。
为什么这些错误接不住
判断标准的关键,不在于“有没有报错”,而在于报错是由什么机制触发的。
- 可恢复错误:通常通过
runtime.panic()抛出,可以在合适的defer中被recover()捕获。 - 不可恢复错误:通常通过
runtime.throw()或runtime.fatal()触发,属于运行时层面的致命问题。
两者的差异可以简单理解为:前者是“当前调用链出错了”,后者是“整个运行环境已经不可靠,或者已经无法继续执行”。一旦进入后者,继续恢复并运行程序,反而可能把问题扩大成数据损坏、状态错乱或更难定位的事故。
所以,recover() 更适合做边界保护、日志记录和降级处理,而不是被当成系统稳定性的最后防线。
比 recover 更重要的,是提前预防
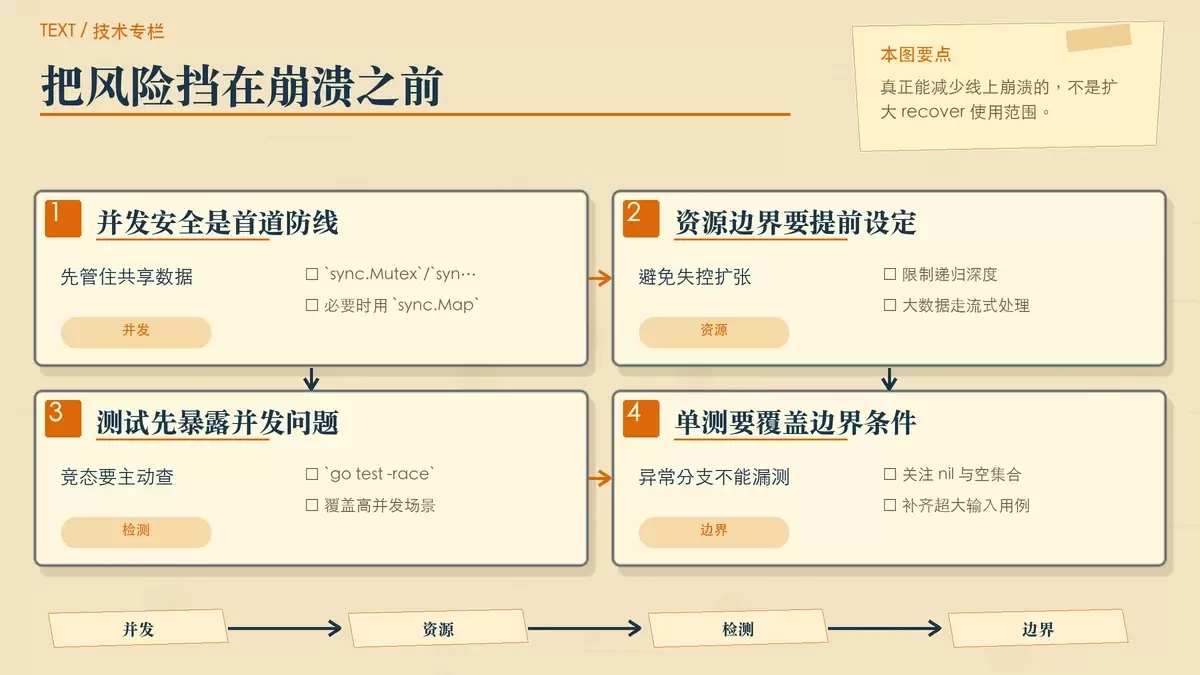
既然有些错误根本无法恢复,治理重点就应该前移到设计、编码和测试阶段。
并发安全
- 对共享数据使用
sync.Mutex或sync.RWMutex保护。 - 在确有需要时,用
sync.Map代替普通 map 处理并发读写。 - 优先通过 channel 传递数据,减少共享状态暴露面。
如果你的服务有明显的多 goroutine 访问热点对象,先审视共享方式,再考虑是否要用恢复逻辑兜底,通常收益更高。
资源控制
- 限制递归深度,避免无终止条件的递归调用。
- 预估切片和 map 的容量,减少失控扩张。
- 面对大数据集时尽量采用流式处理,而不是一次性全部载入内存。
OOM 和栈溢出本质上都和资源边界有关。代码只要缺少上限意识,线上流量一放大,问题往往就会从“偶发”变成“必现”。
测试与检测
- 使用
go test -race做竞态检测。 - 做压力测试,尽量在接近真实并发的条件下暴露问题。
- 为边界条件补充单元测试,尤其是 nil、空集合、超大输入和异常分支。
很多致命错误并不是线上才会发生,而是测试阶段没有覆盖到运行时边界。对 Go 服务来说,go test -race 往往是成本最低、收益最高的一道筛查。
结语:recover 是护栏,不是免死金牌
recover() 当然有价值,它能拦住很多普通 panic,避免单次请求或单个任务直接把程序带崩。但它并不负责修复运行时已经认定为不可继续执行的致命错误。
真正可靠的思路是把它当作边界保护措施,而不是稳定性的核心策略。遇到并发读写 map、OOM、栈溢出、nil 函数启动、死锁这类问题时,重点应该放在预防、约束和测试上,而不是事后期待一次 recover() 能把进程救回来。















