


Python数据分析基础:NumPy与Scikit-learn核心用法解析

本文详细介绍Python中两大核心库NumPy与Scikit-learn的基础应用。涵盖NumPy数组创建、内存优势及常用数值计算方法,并系统讲解Sklearn的监督与无监督学习模块、数据变换工具及标准API调用流程,助力快速上手机器学习实践。
Python核心库概述
NumPy和Scikit-learn是Python生态中不可或缺的第三方库。NumPy专注于大型矩阵的存储与处理,有效弥补了原生Python在数值运算效率上的短板,使其成为科学计算领域的关键工具;Scikit-learn则是广受欢迎的机器学习库,内置丰富算法与数据集,且文档完善,极大降低了机器学习的学习与开发门槛。
NumPy库基础应用
1. NumPy库基础
使用NumPy前需先导入该库,具体导入方式见后续代码示例。
import numpy as npNumPy数组与List对比
1.1 numpy.array 与 list 的区别
a = [1,2,3,4,5,6] # python内置数组结构
b = np.array(a) # numpy数组结构
Python内置了list结构,但为何还需引入NumPy的数组?这主要源于两者在内存管理上的差异。list允许存储异构数据(如字符串、整数或对象),这种灵活性带来了便利,却导致较高的内存开销。因为list中每个元素都包含一个指针指向实际数据,相比原生数组多出一层指针存储。若需优化内存占用并提升计算速度,将list替换为np.array是更优选择,它作为数值计算的容器效率更高。
NumPy常用操作详解
1.2 numpy常用操作指南
数组创建方法
np.array([1,2,3]) # 创建一维数组
np.asarray([1,2,3])
np.array([1,2,3], [4,5,6]) # 创建多维数组

np.zeros((3, 2)) # 3行2列 全0矩阵
np.ones((3, 2)) #全1矩阵
np.full((3, 2), 5) # 3行2列全部填充5
np.array 和 np.asarray 的核心区别在于是否复制数据。
def asarray(a, dtype=None, order=None):
 return array(a, dtype, copy=False, order=order)
具体而言,np.array会创建新对象并分配独立内存空间,行为类似深拷贝;而np.asarray则尽量复用现有数据,不进行额外复制,行为类似浅拷贝。
数值计算功能
基础运算操作
arr1 = np.array([[1,2,3], [4,5,6]])
arr2 = np.array([[6,5], [4,3], [2,1]])

# 查看arr维度
print(arr1.shape) # (2, 3)

#切片
np.array([1,2,3,4,5,6])[:3] #array([1,2,3])
arr1[0:2,0:2] # 二维切片

#乘法
np.array([1,2,3]) * np.array([2,3,4]) # 对应元素相乘 array([2,6, 12])
arr1.dot(b) # 矩阵乘法

#矩阵求和
np.sum(arr1) # 所有元素之和 21
np.sum(arr1, axis=0) #列求和 array([5, 7, 9])
np.sum(arr1, axis=1) # 行求和 array([ 6, 15])

# 最大最小
np.max(arr1, axis=0/1)
np.min(a, axis=0/1)
进阶计算技巧
arr = np.array([[1,2], [3,4], [5,6]])

#布尔型数组访问方式
print((arr>2))
 """
 [[False False]
 [ True True]
 [ True True]]
 """
print(arr[arr>2]) # [3 4 5 6]

#修改形状
arr.reshape(2,3)
 """
 array([[1, 2, 3],
 [4, 5, 6]])
 """
arr.flatten() # 摊平 array([1, 2, 3, 4, 5, 6])
arr.T # 转置
Scikit-learn机器学习库
2. sklearn库概览
若需快速掌握Sklearn使用技巧,可参考相关博客文章《ML神器:sklearn的快速使用》获取进阶指导。
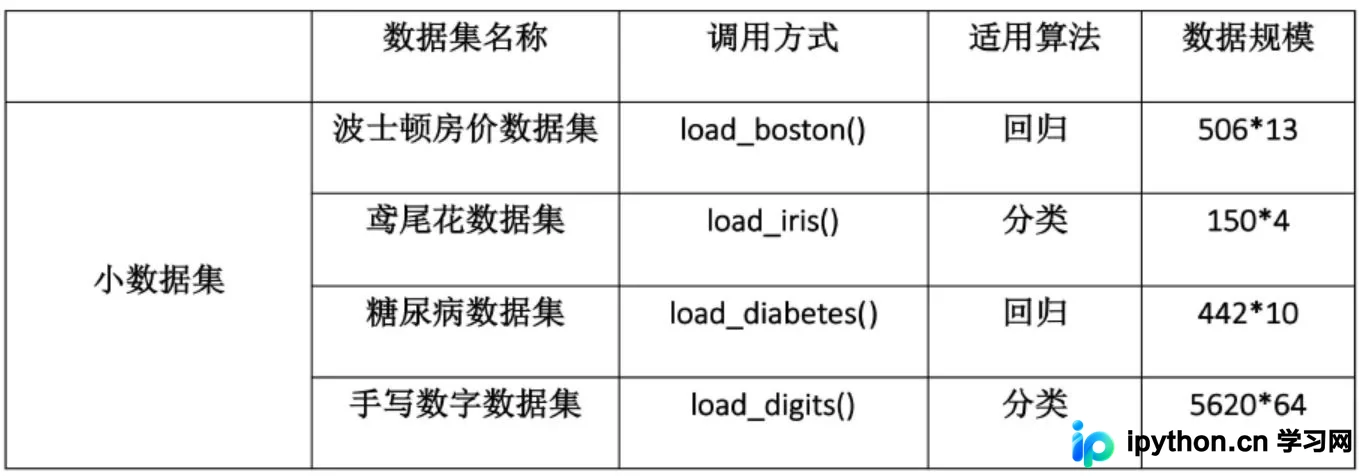
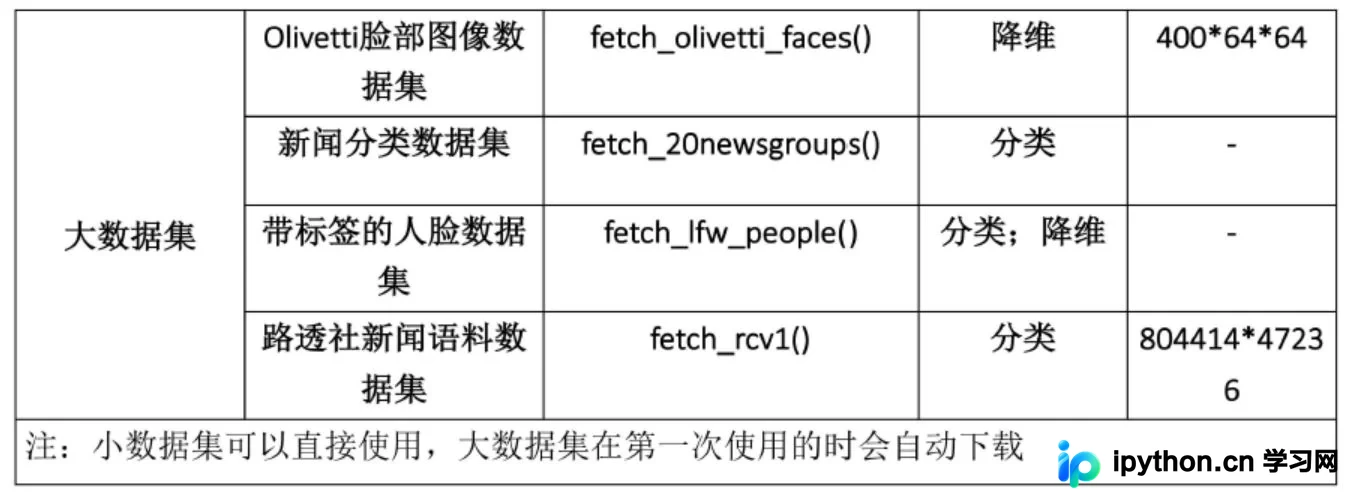
作为Python重要的机器学习库,Sklearn封装了分类、回归、降维及聚类等大量算法,涵盖监督学习、非监督学习和数据变换三大模块。凭借完善的文档和内置数据集,它大幅简化了数据获取与预处理流程,成为业界广泛采用的标准工具。以下简要介绍其常用方法。
监督与无监督学习模块
监督学习模块
sklearn.neighbors #近邻算法
sklearn.svm #支持向量机
sklearn.kernel_ridge #核-岭回归
sklearn.discriminant_analysis #判别分析
sklearn.linear_model #广义线性模型

sklearn.ensemble #集成学习
sklearn.tree #决策树
sklearn.naive_bayes #朴素贝叶斯
sklearn.cross_decomposition #交叉分解
sklearn.gaussian_process #高斯过程

sklearn.neural_network #神经网络
sklearn.calibration #概率校准
sklearn.isotonic #保守回归
sklearn.feature_selection #特征选择
sklearn.multiclass #多类多标签算法
上述各类模型均支持直接导入使用,例如通过import语句调用具体算法类。
from sklearn.linear_model import LogisticRefression
lr_model = LogisticRegression()
无监督学习模块
sklearn.decomposition #矩阵因子分解
sklearn.cluster # 聚类
sklearn.manifold # 流形学习
sklearn.mixture # 高斯混合模型
sklearn.neural_network # 无监督神经网络
sklearn.covariance # 协方差估计
数据变换与预处理工具
sklearn.feature_extraction # 特征提取
sklearn.feature_selection # 特征选择
sklearn.preprocessing # 预处理
sklearn.random_projection # 随机投影
sklearn.kernel_approximation # 核逼近
内置数据集资源
标准机器学习流程与API
此外,Sklearn提供了统一的API接口,使得不同算法的实现流程高度一致。典型的应用流程如下所示。
第一步:加载数据并进行预处理。
第二步:定义分类器,例如初始化逻辑回归模型:lr_model = LogisticRegression()。
第三步:利用训练集拟合模型,执行代码:lr_model.fit(X, Y)。
第四步:使用训练好的模型对测试集进行预测,执行代码:y_pred = lr_model.predict(X_test)。
第五步:评估模型性能,使用代码:lr_model.score(X_test, y_test)。
常用命令速查
1. 数据集分割操作
# 作用:将数据集划分为 训练集和测试集
# 格式:train_test_split(*arrays, **options)
from sklearn.mode_selection import train_test_split
X, y = np.arange(10).reshape((5, 2)), range(5)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
"""
参数
---
arrays:样本数组,包含特征向量和标签

test_size:
  float-获得多大比重的测试样本 (默认:0.25)
  int - 获得多少个测试样本

train_size: 同test_size

random_state:
  int - 随机种子(种子固定,实验可复现)

shuffle - 是否在分割之前对数据进行洗牌(默认True)

返回
---
分割后的列表,长度=2*len(arrays),
  (train-test split)
"""
以上内容涵盖了本文的主要知识点,希望能对读者的学习有所帮助,欢迎继续支持本站获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















