


Python爬取盘搜有效链接的爬虫实现

发布时间:2026-10-13 |
4人浏览过
本文介绍如何使用Python编写爬虫,从盘搜网站筛选出有效的网盘链接。通过解析接口获取JSON数据,结合多线程技术提高爬取效率,并保存结果至CSV文件。代码包含详细的请求头设置、异常处理及文件写入逻辑,适合初学者练习网络爬虫开发。
背景与目标
由于盘搜搜索结果中常包含大量失效链接,严重影响数据查找效率,本文旨在通过编写爬虫程序自动过滤出有效链接,同时借此机会进行编程实践。
目标网站与接口分析
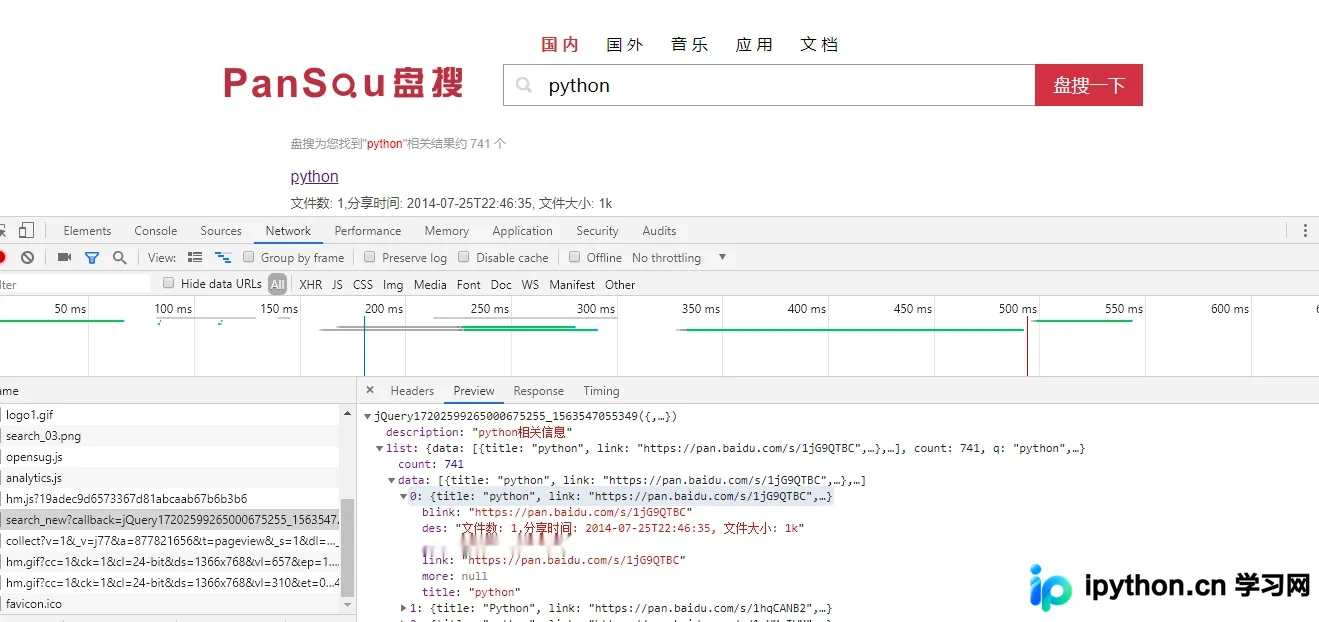
本次爬取的目标网站为http://www.pansou.com。以搜索关键词“python”为例,首先需打开浏览器的开发者工具进行网络请求分析。
通过开发者工具可以观察到,目标链接返回的JSON数据即为所需爬取的内容。在获取数据时,需剔除多余的参数以简化请求。
最终确定的请求链接格式为http://106.15.195.249:8011/search_new?q=python&p=1,其中q参数代表搜索关键词,p参数代表页码。
Python代码实现
以下是具体的Python代码实现过程。
import requests
import json
from multiprocessing.dummy import Pool as ThreadPool
from multiprocessing import Queue
import sys
headers = {
  "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36"
}
q1 = Queue()
q2 = Queue()
urls = [] # 存取url列表
# 读取url
def get_urls(query):
  # 遍历50页
  for i in range(1,51):
    # 要爬取的url列表,返回值是json数据,q参数是搜索内容,p参数是页码
    url = "http://106.15.195.249:8011/search_new?&q=%s&p=%d" % (query,i)
    urls.append(url)
# 获取数据
def get_data(url):
  print("开始加载,请等待...")
  # 获取json数据并把json数据转换为字典
  resp = requests.get(url, headers=headers).content.decode("utf-8")
  resp = json.loads(resp)
  # 如果搜素数据为空就抛出异常停止程序
  if resp['list']['data'] == []:
    raise Exception
  # 遍历每一页数据的长度
  for num in range(len(resp['list']['data'])):
    # 获取百度云链接
    link = resp['list']['data'][num]['link']
    # 获取标题
    title = resp['list']['data'][num]['title']
    # 访问百度云链接,判断如果页面源代码中有“失效时间:”这段话的话就表明链接有效,链接无效的页面是没有这段话的
    link_content = requests.get(link, headers=headers).content.decode("utf-8")
    if "失效时间:" in link_content:
      # 把标题放进队列1
      q1.put(title)
      # 把链接放进队列2
      q2.put(link)
      # 写入csv文件
      with open("wangpanziyuan.csv", "a+", encoding="utf-8") as file:
        file.write(q1.get()+","+q2.get() + "\n")
  print("ok")
if __name__ == '__main__':
  # 括号内填写搜索内容
  get_urls("python")
  # 创建线程池
  pool = ThreadPool(3)
  try:
    results = pool.map(get_data, urls)
  except Exception as e:
    print(e)
  pool.close()
  pool.join()
  print("退出")
总结
总结
以上介绍了利用Python爬取盘搜有效链接的实现方法,希望能为读者提供有益参考。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持!若觉得本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















