


Python爬取腾讯视频评论实战:基于Fiddler抓包与Ajax分析

本文详解如何使用Python爬取腾讯视频纪录片评论。通过Fiddler抓包分析Ajax异步加载机制,解析评论接口URL规律,重点推导cursor参数的获取逻辑。结合Python代码实现自动翻页抓取,完整展示从环境配置、接口分析到代码编写的全过程,帮助开发者掌握动态网页数据抓取的核心技巧。
环境准备与前置条件
一、前提条件
- 需要安装Fiddler工具,用于网络数据包抓取与分析。
- 准备谷歌浏览器或火狐浏览器作为测试环境。
- 若使用谷歌浏览器,需安装SwitchyOmega插件以配置代理服务器,确保抓包工具能捕获流量。
- 搭建Python运行环境,建议使用Python 3.0及以上版本。
声明:本次实战以爬取腾讯视频纪录片《最美公里》的评论数据为目标,测试浏览器选用谷歌浏览器。
Ajax接口分析与规律推导
二、分析思路
1、分析评论页面结构
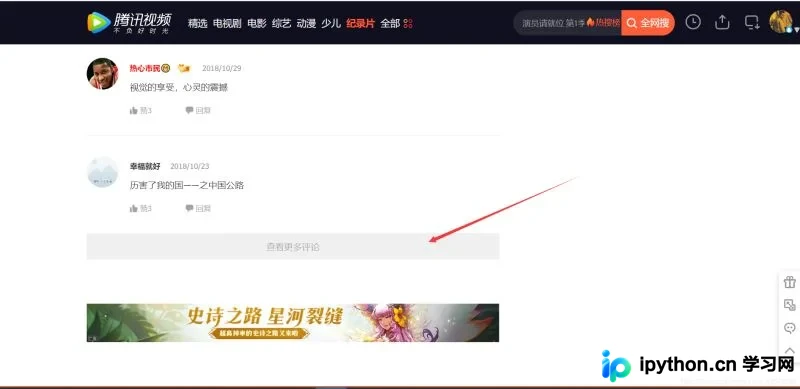
观察页面可知,评论列表采用Ajax异步加载技术。这意味着无法直接通过解析当前HTML页面获取全部评论,因为页面仅展示部分数据,其余评论需通过后台请求动态加载。
因此,必须借助抓包工具分析评论数据刷新的网络请求规律。在大多数现代网页爬虫场景中,先通过抓包分析接口是标准操作流程。
2、使用Fiddler进行抓包分析——得出评论网址规律
关于Fiddler的具体使用方法,属于基础网络知识,读者需自行查阅相关资料,此处不作展开讨论。
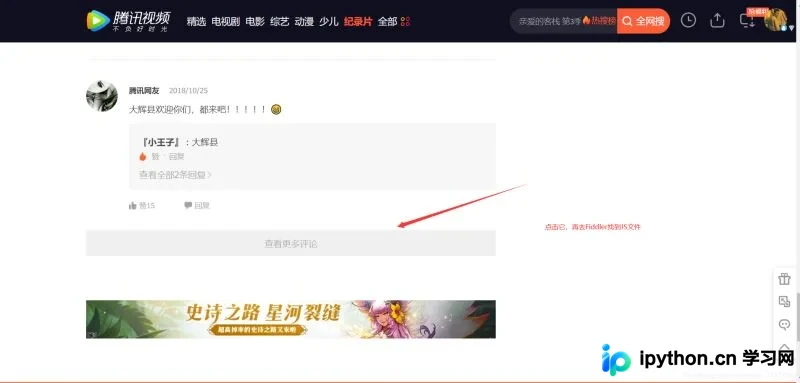
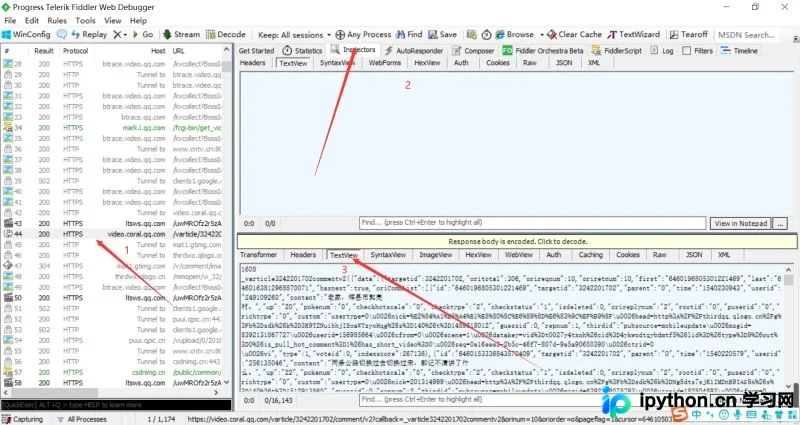
对比抓包结果中的关键文件,可以发现包含评论数据的JS文件即为数据源页面(实际操作中需逐一排查,通常Ajax数据封装在JS文件中,通过对比JS内容即可定位)。
复制该JS文件的URL:在Fiddler中右键点击该请求,选择Copy -> Just Url。
重复多次刷新操作,获取多个JS请求的URL,从中总结规律。下图展示了刷新4次后得到的JS URL列表:
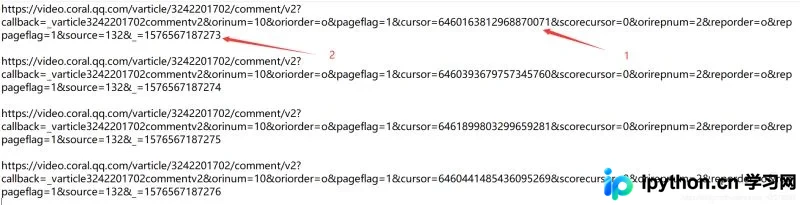
通过对比上述URL,发现差异点主要位于两处:一是cursor=?参数;二是_=?参数。
观察发现,_=?的值遵循递增规律,即在前一个值基础上加1(例如从1576567187273开始递增)。然而,cursor=?的值规律不明显,需进一步探究其生成逻辑。
(1)查阅网络资源,搜索是否有前人针对类似网站进行过爬取,参考其总结的规律与方法;
(2)采用逆向思维:既然数据来自上一个请求,那么当前请求的cursor=?是否可以从上一个JS页面的返回结果中获取?这仅是众多假设中的一种,需逐一验证。
我们尝试第二种方法,深入JS源码查找线索。复制其中一个URL为:
url = https://video.coral.qq.com/varticle/3242201702/comment/v2?callback=_varticle3242201702commentv2&orinum=10&oriorder=o&pageflag=1&cursor=6460163812968870071&scorecursor=0&orirepnum=2&reporder=o&reppageflag=1&source=132&_=1576567187273在浏览器中直接打开该URL,并在返回内容中搜索下一个请求所需的cursor=?值。结果令人惊喜。
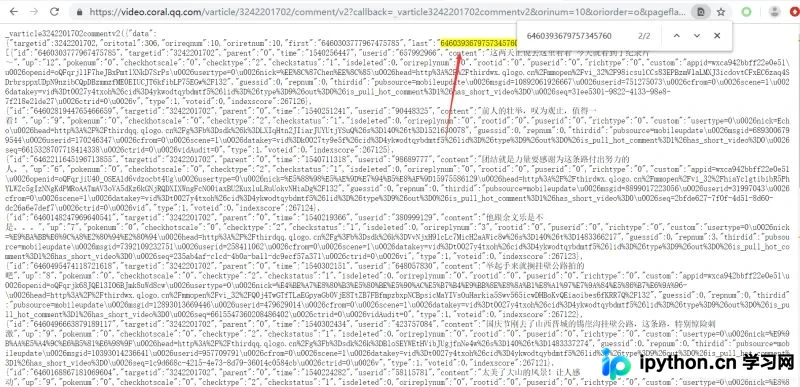
如下所示:
为确保结论可靠,建议多次重复测试,验证该逻辑的稳定性。
至此,我们明确了评论接口URL的生成规律:
- _=?参数值从1576567187273开始,每次请求加1。
- cursor=?参数的值存在于上一个JS请求的返回数据中。
Python代码实现与结果验证
三、代码编写
import re
import random
import urllib.request

#构建用户代理
uapools=["Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36",
  "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36",
  "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:71.0) Gecko/20100101 Firefox/71.0",
 ]
#从用户代理池随机选取一个用户代理
def ua(uapools):
 thisua=random.choice(uapools)
 #print(thisua)
 headers=("User-Agent",thisua)
 opener=urllib.request.build_opener()
 opener.addheaders=[headers]
 #设置为全局变量
 urllib.request.install_opener(opener)

#获取源码
def get_content(page,lastId):
 url="https://video.coral.qq.com/varticle/3242201702/comment/v2?callback=_varticle3242201702commentv2&orinum=10&oriorder=o&pageflag=1&cursor="+lastId+"&scorecursor=0&orirepnum=2&reporder=o&reppageflag=1&source=132&_="+str(page)
 html=urllib.request.urlopen(url).read().decode("utf-8","ignore")
 return html

#从源码中获取评论的数据
def get_comment(html):
 pat='"content":"(.*?)"'
 rst = re.compile(pat,re.S).findall(html)
 return rst

#从源码中获取下一轮刷新页的ID
def get_lastId(html):
 pat='"last":"(.*?)"'
 lastId = re.compile(pat,re.S).findall(html)[0]
 return lastId

def main():
 ua(uapools)
 #初始页面
 page=1576567187274
 #初始待刷新页面ID
 lastId="6460393679757345760"
 for i in range(1,6):
 html = get_content(page,lastId)
 #获取评论数据
 commentlist=get_comment(html)
 print("------第"+str(i)+"轮页面评论------")
 for j in range(1,len(commentlist)):
  print("第"+str(j)+"条评论:" +str(commentlist[j]))
 #获取下一轮刷新页ID
 lastId=get_lastId(html)
 page += 1

main()
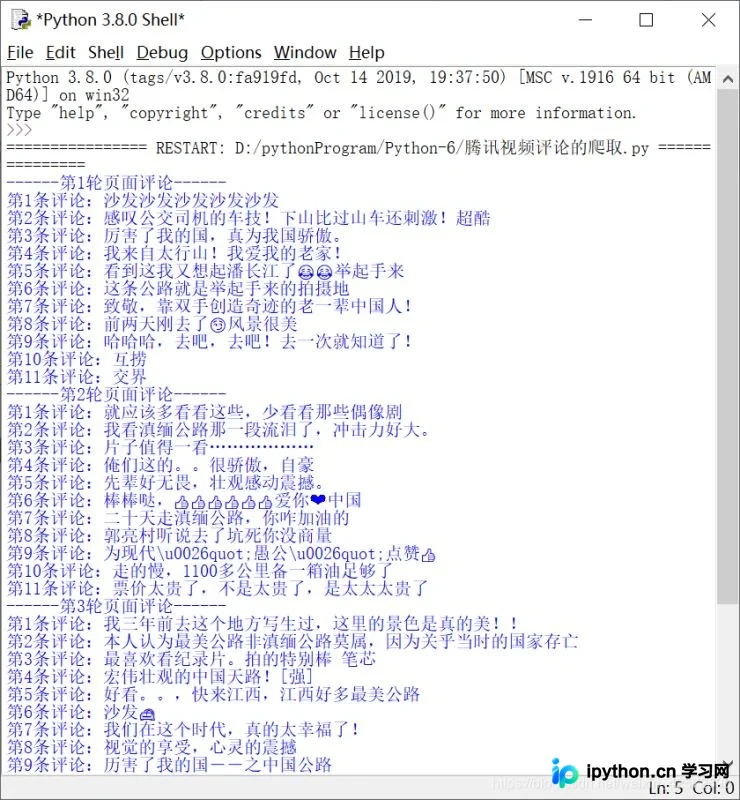
四、结果展示
总结
以上介绍了利用Python爬取腾讯视频评论的完整流程,希望能为读者提供帮助。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持! 如果觉得本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















