


Kubernetes节点维护:cordon与drain操作

维护前检查:确认节点状态与工作负载
在进行任何节点维护操作之前,全面评估目标节点及其承载的工作负载是保障业务连续性的关键第一步。首先,使用 kubectl get nodes 查看节点整体状态,确认其处于 Ready 状态且无异常事件。接着,通过 kubectl get pods --field-selector spec.nodeName=<node-name> -o wide 列出该节点上运行的所有 Pod,并逐一核对它们的控制器归属(如 Deployment、StatefulSet 或 Job)。在此阶段,必须重点关注 PodDisruptionBudget(PDB)配置,因为 PDB 会限制同时中断的 Pod 数量,若未提前评估可能导致 drain 操作长时间阻塞。同时,需识别是否存在 DaemonSet 管理的 Pod(如日志采集或网络插件)、挂载了 emptyDir 卷的 Pod,以及缺乏控制器管理的裸 Pod。DaemonSet 默认不受 drain 影响,emptyDir 数据会在驱逐时丢失,而无控制器 Pod 被删除后将无法自动重建。提前梳理这些信息,能有效制定维护策略,避免执行驱逐时出现意外中断或数据丢失。
执行 cordon:停止节点接收新 Pod
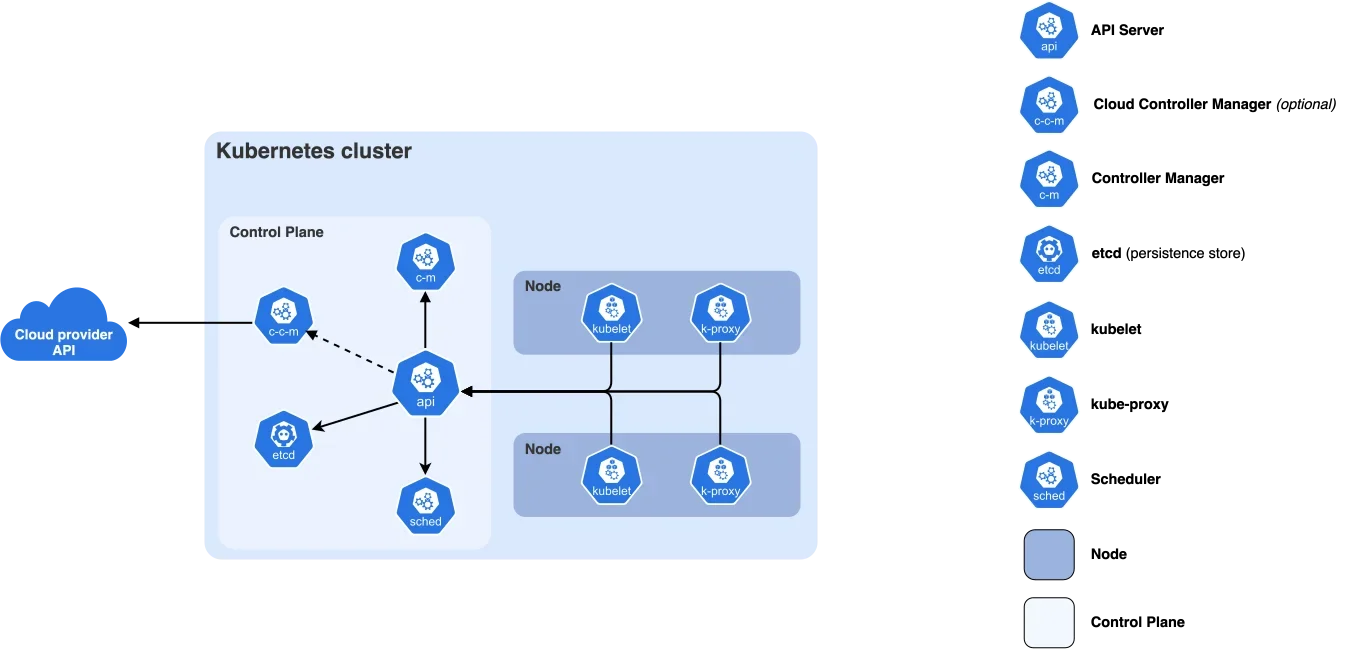
cordon 操作的核心作用是将目标节点标记为不可调度(Unschedulable),从而阻止 Kubernetes 调度器将新的 Pod 分配到该节点上。需要明确的是,cordon 仅影响未来的调度决策,绝不会删除或驱逐节点上已经运行的 Pod,现有业务流量不会因此中断。执行命令非常简单:kubectl cordon <node-name>。执行成功后,调度器会立即感知该节点状态变更。为了验证操作是否生效,可运行 kubectl get nodes 查看输出结果,目标节点的 STATUS 列会显示为 Ready,SchedulingDisabled。这一步是节点维护的标准前置动作,相当于在维修前拉起警戒线,确保在后续执行 drain 或进行系统升级、硬件更换时,集群的自动扩缩容或新建 Pod 请求不会错误地落盘到该节点,从而为安全驱逐工作负载创造稳定的环境。
执行 drain:安全驱逐节点上的 Pod
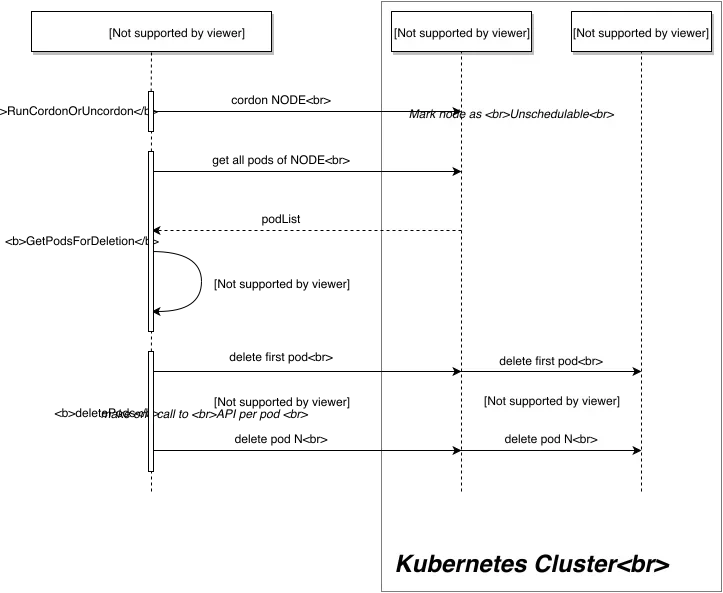
drain 命令是 Kubernetes 节点维护的核心环节,其工作流分为两步:首先自动将节点标记为不可调度(若未提前 cordon),随后通过 Kubernetes Eviction API 安全地驱逐节点上的工作负载。基础命令为 kubectl drain <node-name>。在实际操作中,必须合理搭配参数以应对不同场景:使用 --ignore-daemonsets 跳过由 DaemonSet 管理的 Pod,因为这类组件通常需要在每个节点常驻运行,强制驱逐会导致集群功能异常;添加 --delete-emptydir-data 允许驱逐挂载了 emptyDir 的 Pod,但需确认该数据可丢弃或已备份;若遇到非控制器管理的 Pod 或异常卡死的 Pod,可谨慎使用 --force 强制删除。需要特别强调的是,切勿随意使用 --disable-eviction 参数,该参数会绕过 Eviction API 直接删除 Pod,从而无视 PodDisruptionBudget(PDB)的约束,极易引发服务可用性跌破阈值,导致业务雪崩。
维护后恢复:验证节点并执行 uncordon
当 drain 命令成功执行且节点上所有可驱逐的 Pod 均已安全迁移至其他节点后,方可开始实际的硬件维护、内核升级或配置变更。维护工作彻底完成后,必须将节点重新纳入集群调度池,此时需执行 kubectl uncordon <node-name> 命令。该操作会清除节点的 SchedulingDisabled 标记,恢复其可调度状态。恢复后,应立即进行双重验证:首先运行 kubectl get nodes 确认目标节点状态已恢复为 Ready,且不再包含 SchedulingDisabled 后缀;其次使用 kubectl get pods -o wide 观察集群 Pod 分布情况,验证新创建的 Pod 或处于 Pending 状态的 Pod 是否已正常调度至该节点。通过上述步骤,可确保节点已完全恢复服务能力,集群资源分配重新达到均衡状态,整个维护流程形成闭环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















