


Python爬虫实战:利用urllib模拟有道翻译POST请求

本文详解如何使用Python的urllib库模拟有道在线翻译的POST请求。通过浏览器开发者工具分析网络请求,识别GET与POST差异,重点讲解urlopen方法中data参数的应用、字典数据的构造以及UTF-8编码转换原理,帮助开发者掌握基础网页抓取与接口模拟技巧。
准备工作与请求分析
1.准备工作
首先访问有道在线翻译页面:http://fanyi.youdao.com/
按下F12键打开开发者工具,切换到Network(网络)标签页,随后按F5刷新页面。若未显示Method列,可在Name列上右键点击并勾选Method以显示该列。
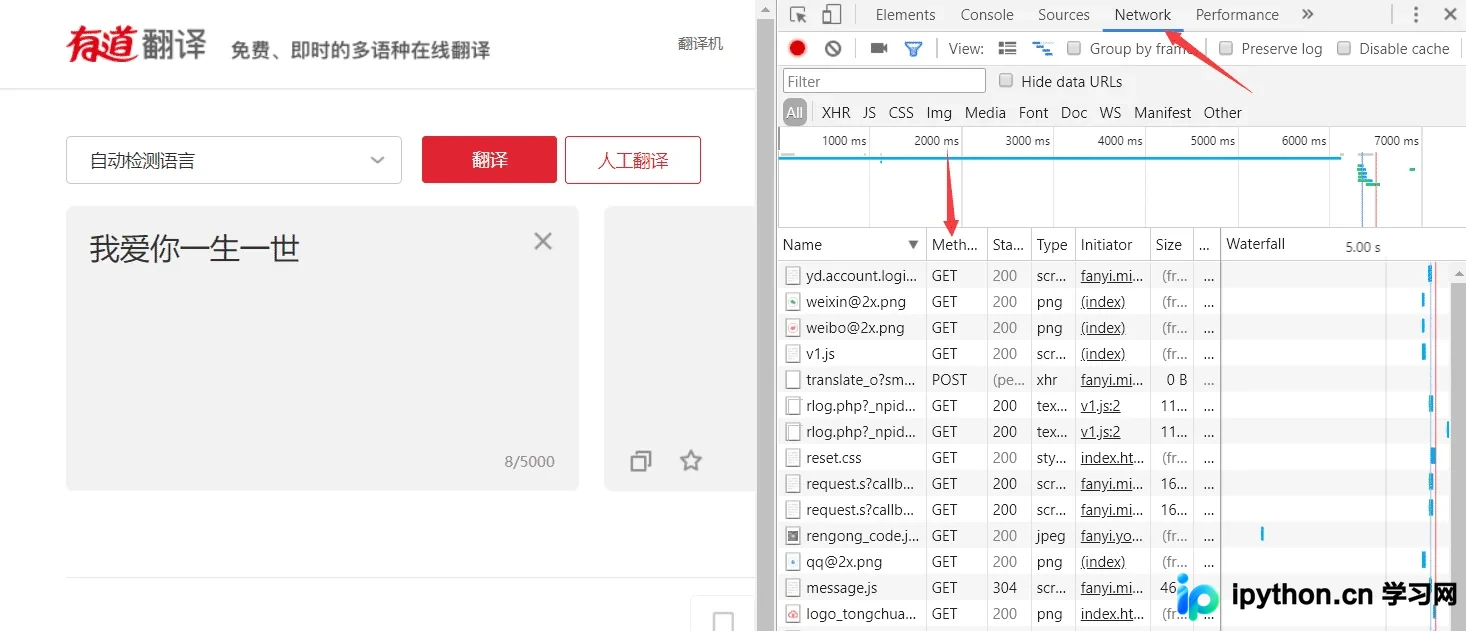
输入文字触发自动翻译后,观察Network列表,会发现同时存在GET和POST请求。其中,GET用于从服务器获取数据,而POST用于向指定服务器提交待处理的数据。
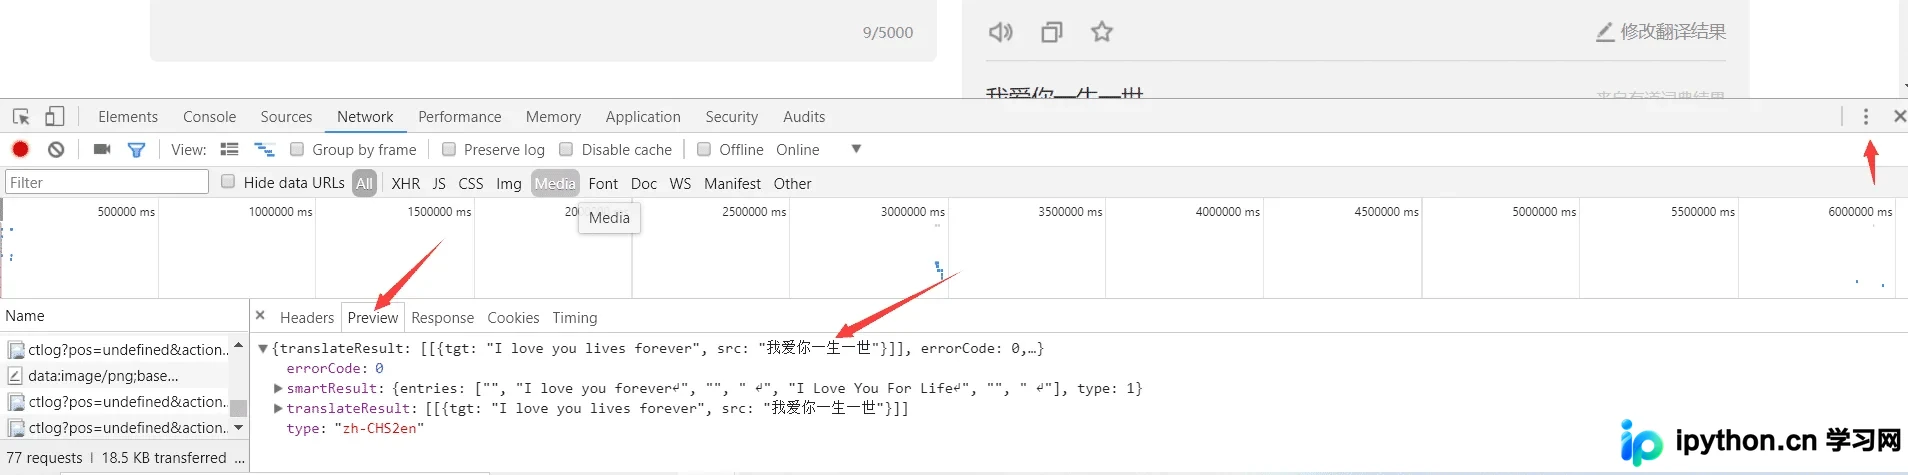
任意展开一个POST请求,在Preview(预览)标签页中可查看到输入的“我爱你一生一世”数据,这证实了POST请求确实提交了提交的数据。
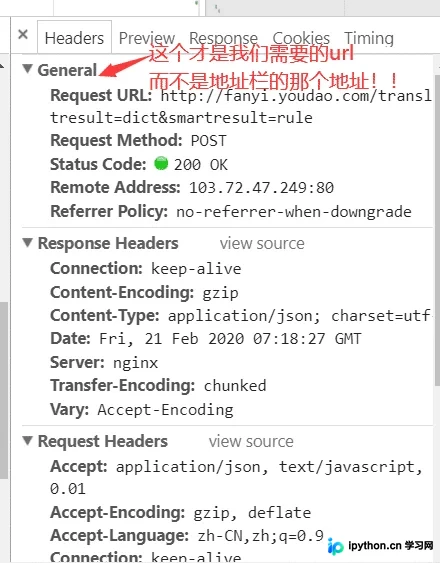
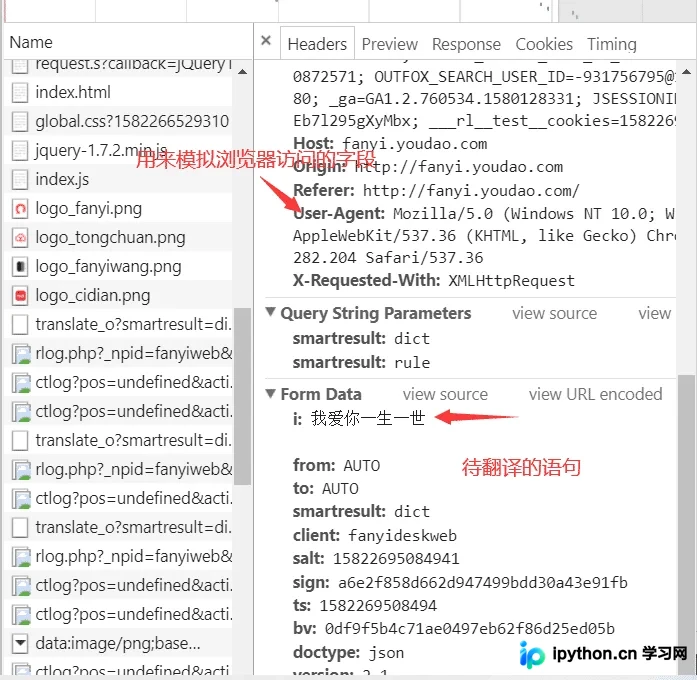
接下来分析Headers(请求头)各字段的含义;其中User-agent字段至关重要。
urllib模块POST请求实现
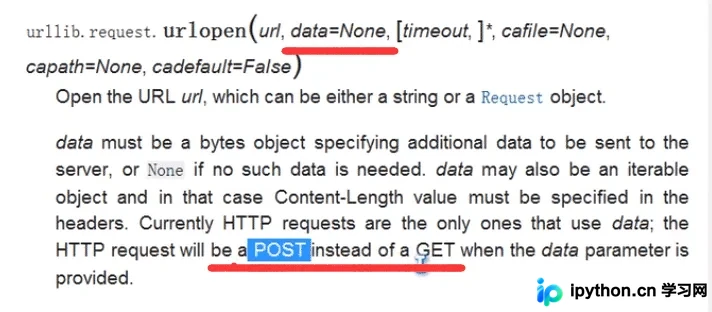
随后查看Python中request模块的urlopen方法文档;
文档显示urlopen包含一个data参数:若该参数未赋值(默认为None),则请求形式为GET;若data参数被赋值,则以POST形式提交数据。
在此处,data参数实际上是一个字典对象,对应源代码中From Data部分的数据。
关于urlencode与unquote的详细解释可参考另一篇文章:(urllib库中缺乏urldecode函数)
https://www.jb51.net/article/183857.htm
为何需要进行编码和解码?------》对于部分中文或特殊字符,URL无法直接识别,必须进行编码转换!encode('utf-8')将Unicode格式转换为UTF-8格式;decode('utf-8')将UTF-8格式转换回Unicode编码格式。2.下面进行敲!
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















