


Kubernetes升级策略:集群版本升级步骤

升级前检查:版本规划、兼容性与备份
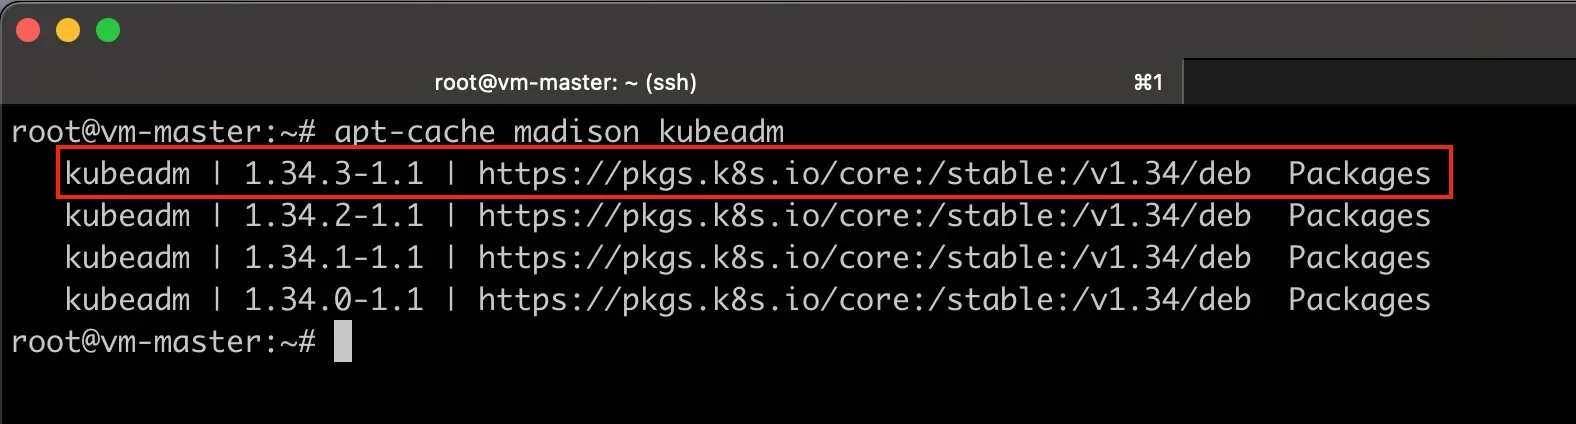
升级前必须明确当前集群版本与目标版本,可通过 kubectl version 与 kubeadm version 获取。Kubernetes 严格禁止跨越次版本升级,必须逐级递进。需详细查阅目标版本的 Release Notes,重点关注 API 弃用列表、CNI/CSI 插件兼容性矩阵以及 kubelet 版本偏差限制。在操作前,务必对 etcd 执行快照备份,并导出集群静态 Pod 清单、ConfigMap 及核心业务配置。同时,使用 kubectl get nodes 确认所有节点处于 Ready 状态,排除底层硬件或网络隐患,为后续升级奠定安全基线。
控制平面升级:kubeadm 规划与逐节点执行
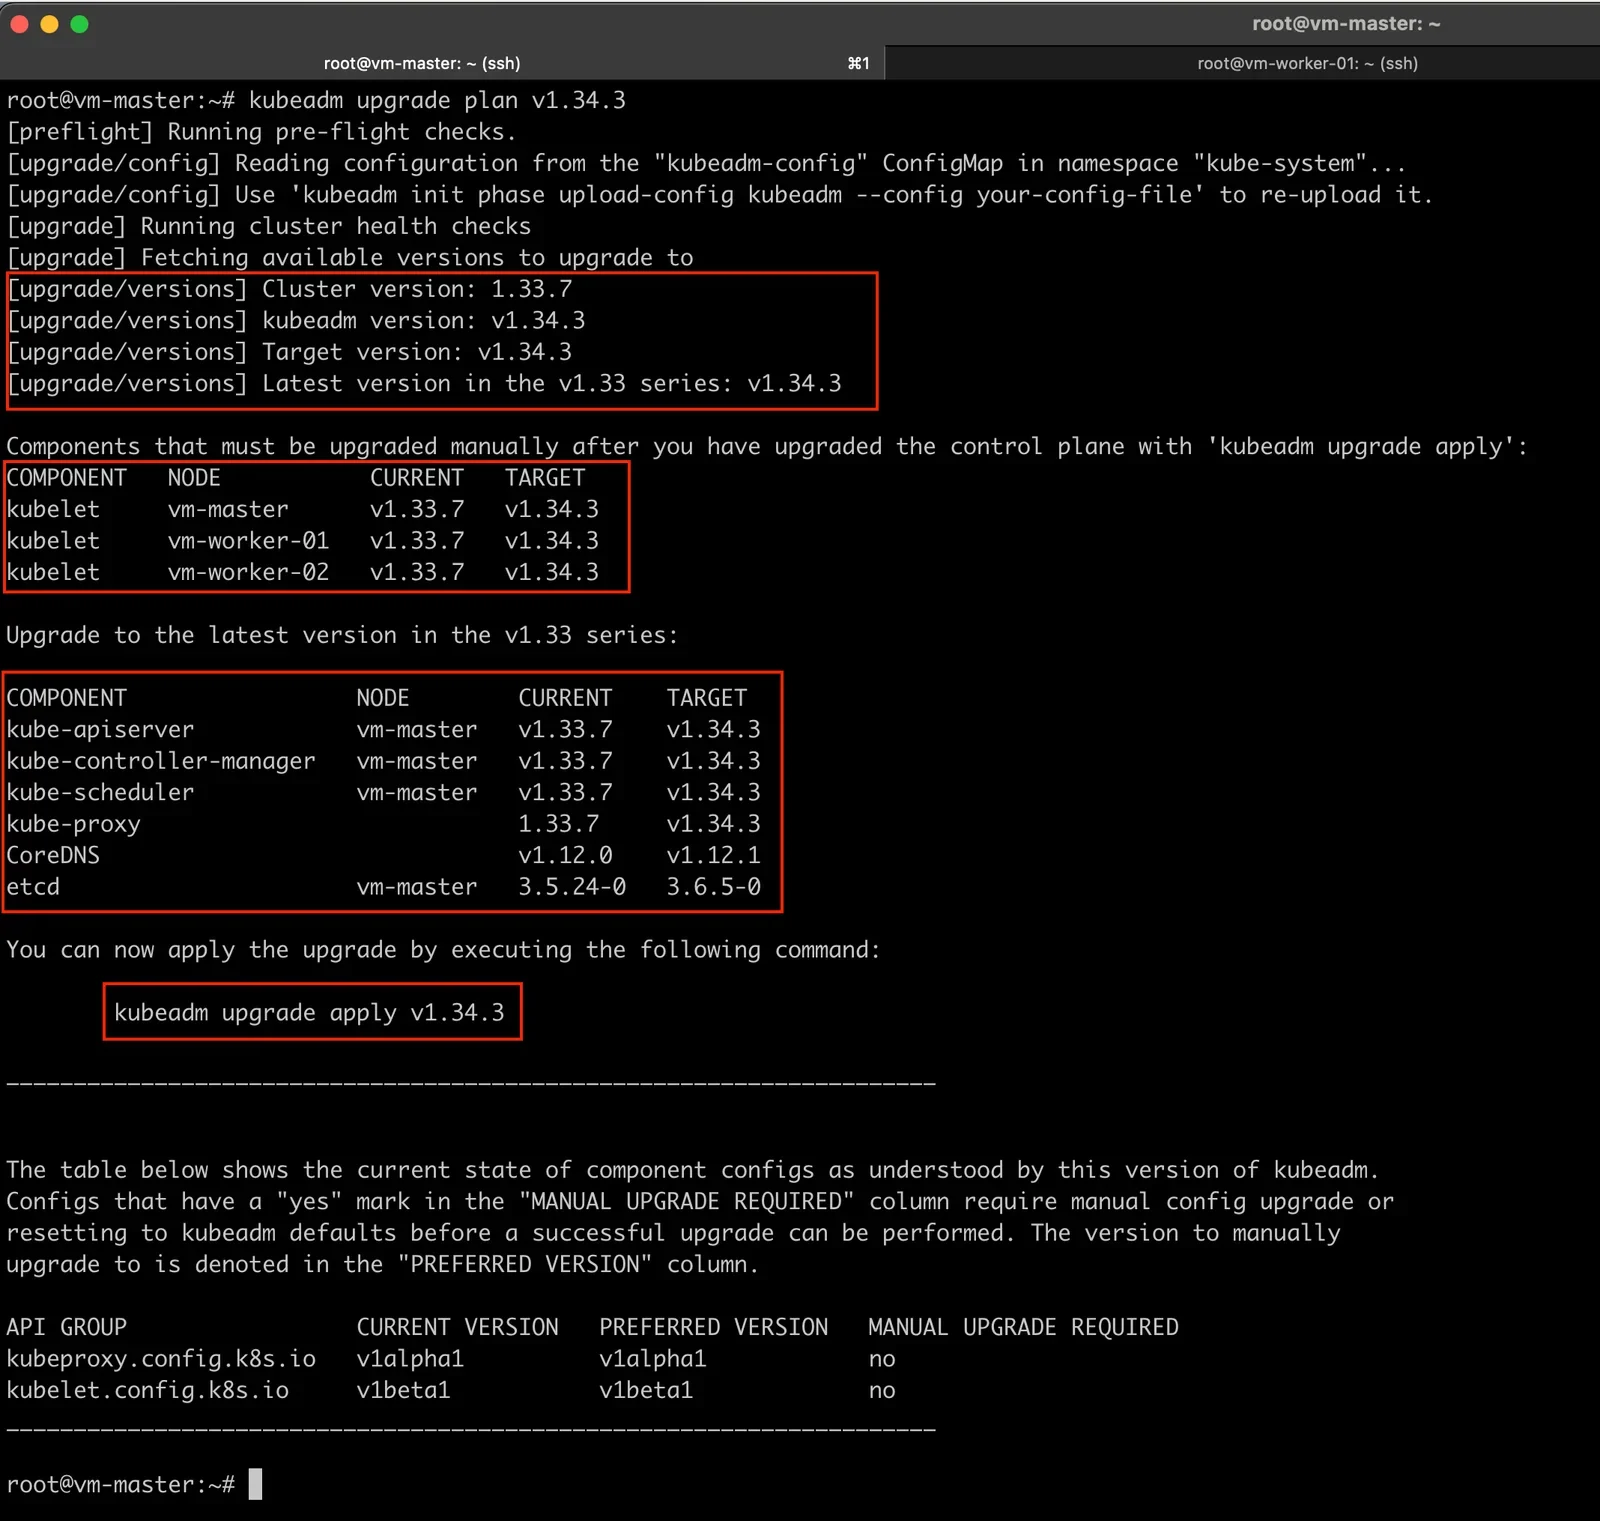
控制平面升级需严格遵循先升级 kubeadm 工具,再执行集群升级的顺序。在首个控制平面节点上,通过包管理器更新 kubeadm 后,运行 kubeadm upgrade plan 获取可用版本与兼容性报告。确认无误后执行 kubeadm upgrade apply 目标版本,该命令会自动更新 API Server、Controller Manager、Scheduler 等静态 Pod,并同步刷新 CoreDNS 与 kube-proxy 配置。对于高可用集群,必须逐节点执行升级,严禁并行操作。升级过程中 kubeadm 会自动处理证书轮换与组件镜像拉取,但需密切观察终端输出,确保 etcd 数据目录未被意外覆盖,且各组件健康探针正常响应。
工作节点升级:排空、升级与恢复调度
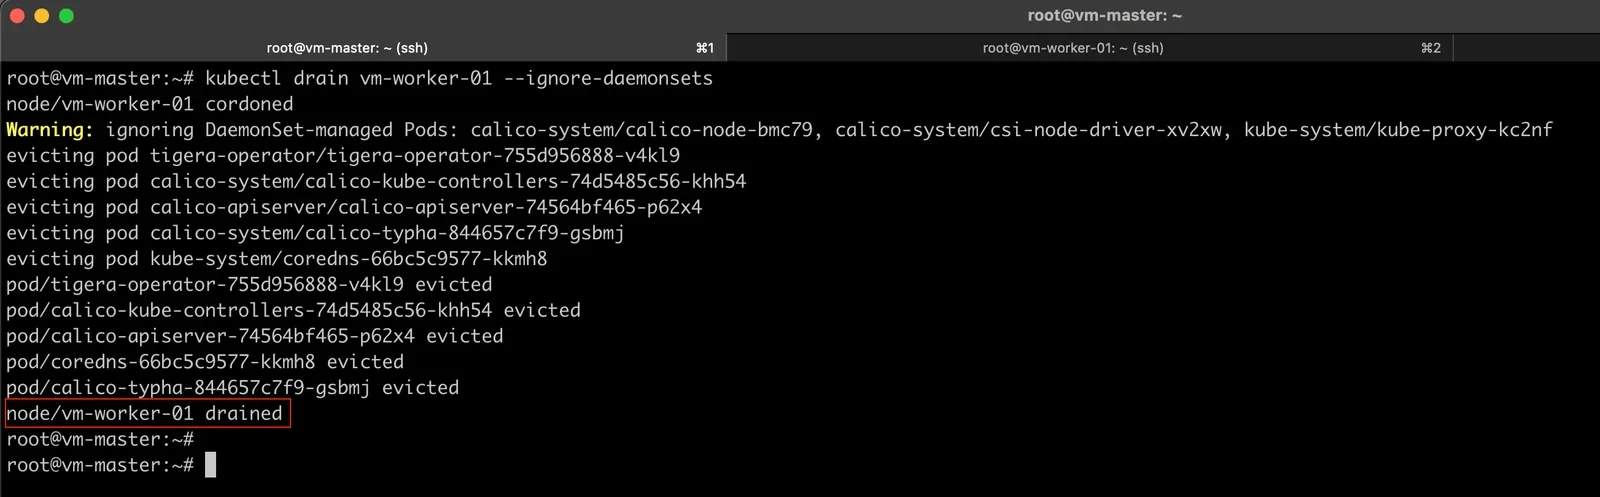
工作节点升级采用标准的排空、升级、恢复滚动链路。首先执行 kubectl cordon 禁止新 Pod 调度,随后运行 kubectl drain 安全驱逐业务负载。节点排空后,通过系统包管理器同步升级 kubeadm、kubelet 与 kubectl,并执行 systemctl daemon-reload 与 systemctl restart kubelet 使新配置生效。待 kubectl get nodes 显示该节点恢复 Ready 状态后,再执行 kubectl uncordon 重新纳入调度池。多节点集群应控制并发数量,建议每次仅处理一到两个节点,以保障业务副本始终满足最小可用数,避免雪崩式中断。
升级后验证:组件、工作负载与业务可用性
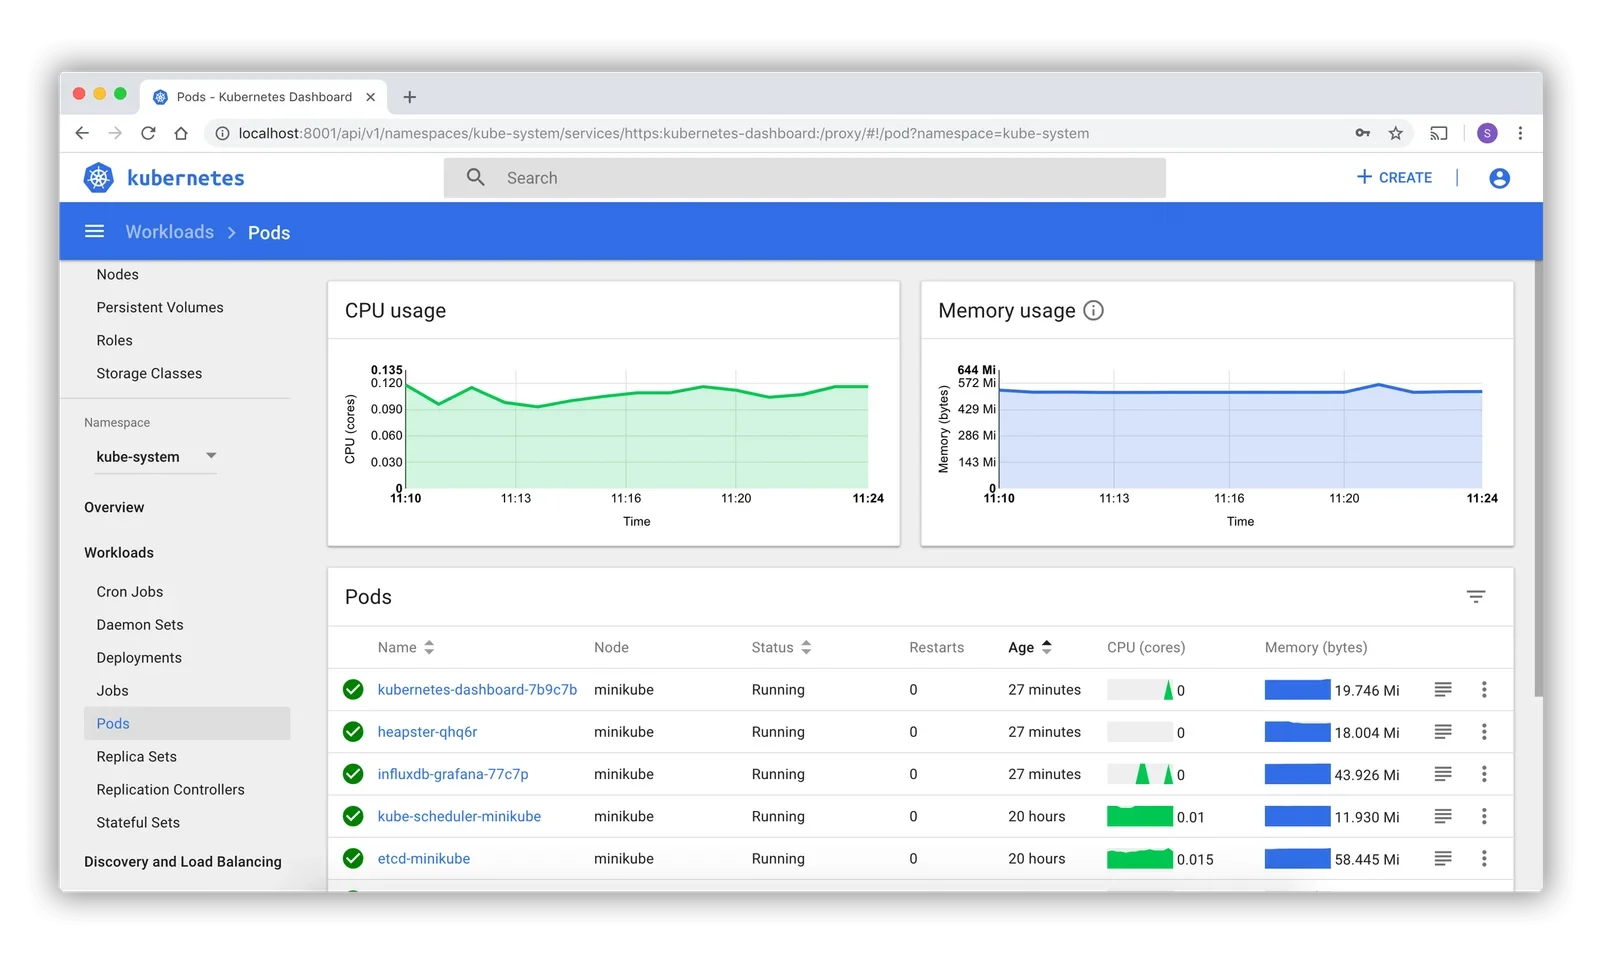
升级完成后需执行标准化验收清单。首先核对集群版本一致性,kubectl version 与 kubectl get nodes 应显示目标版本。检查核心组件状态,确认 kube-system 命名空间下的 CoreDNS、kube-proxy 及网络插件均处于 Running 且 Ready。通过 kubectl get events 排查 Warning 事件,并抽查 kubelet 日志确认无证书过期或资源争抢报错。业务层面需验证关键 Service 端点可达、PVC 挂载正常、Ingress 路由生效及网络策略未阻断流量。若发现 Pod 频繁重启或调度失败,应立即通过 kubectl describe pod 与组件日志交叉定位,必要时回退至备份状态。
常见坑与回滚思路:避免升级失败扩大影响
升级事故多源于跨版本跳跃、系统源版本不匹配、未提前备份 etcd、跳过 drain 直接升级或忽视 API 弃用警告。此外,节点资源不足、网络插件版本不兼容或升级中途断网也会导致组件僵死。一旦升级失败,首要原则是立即暂停后续节点操作,保留现场日志。若控制平面异常,可尝试通过 kubeadm upgrade apply 修复配置;若数据损坏或版本严重不匹配,则需依据部署方式执行回滚:利用 etcd 快照恢复数据,降级 kubelet 与 kubeadm 包版本,并重新应用旧版静态 Pod 清单。切忌盲目重启节点,应优先恢复 etcd 一致性后再逐步重建集群状态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















