


除了写代码,Python还能用于网络爬虫吗

答案是确定的:在现代网络爬虫工程中,直接逐行手写抓取代码只是其中一小部分用途。围绕 Python 建立的无代码可视化平台、爬虫运维调度控制台、自动化解析管道以及中间件服务,可以让使用者在不编写核心请求代码的前提下,直接完成网站结构采集、任务分发与数据沉淀。
假设你现在需要每日定时追踪 20 家行业资讯站点的文章标题与链接。如果按照传统做法,你必须为每个站点写一套解析逻辑,维护各自的异常重试和请求头。但在工程实际中,Python 同样承担着底座引擎的角色:你可以通过现成的 Python 可视化服务在网页上点选生成规则,通过现有后台分发任务,或者只用现有配置模板驱动整个爬虫生命周期。
一、认识 Python 爬虫的多维角色
许多初学者将“用 Python 做爬虫”狭义理解为在编辑器里导入 requests 或 BeautifulSoup,然后写循环和正则提取。实际上,Python 语言因其丰富的胶水特性,已经将网络爬虫拆分为采集层、工具层、调度层和处理层。
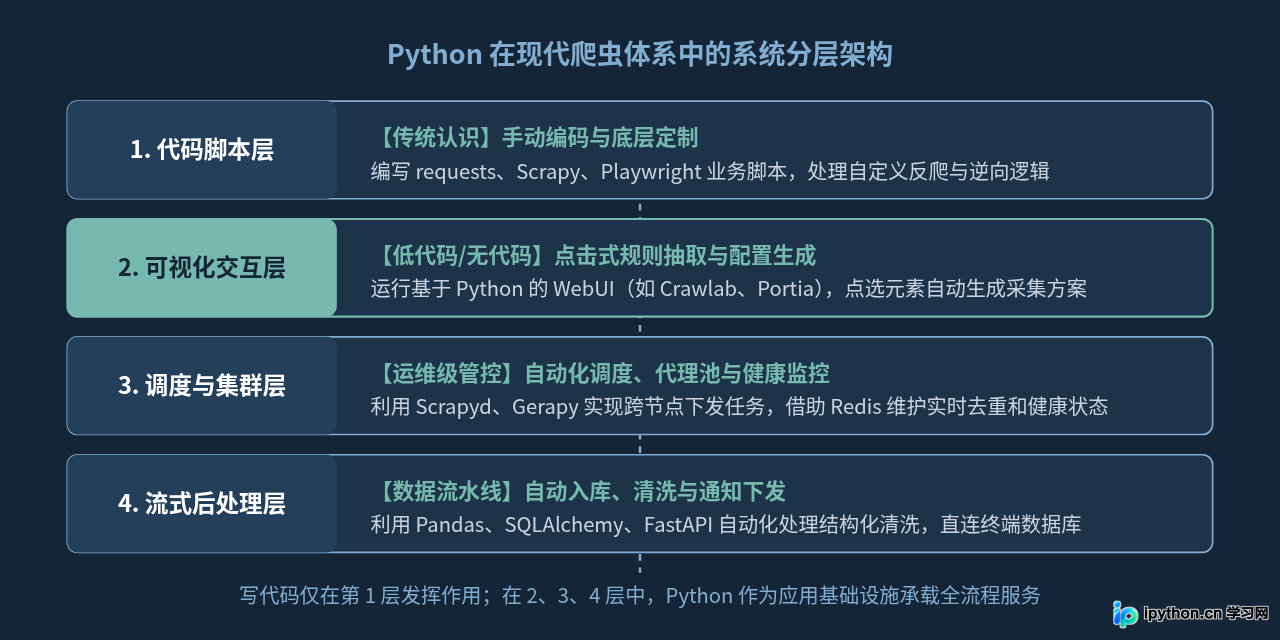
图 1:Python 在现代爬虫体系中的四层角色划分
如果你不打算手工编写 .py 脚本,Python 依然能在以下具体场景中为你服务:
- 作为独立可视化服务的启动核心:在本地或服务器上通过一条安装指令部署 Python 爬虫管理平台,之后所有操作都在浏览器控制台中完成。
- 作为结构化规则解析器:只需提供预先制定的 JSON 或 YAML 配置文件,Python 引擎读取配置并自动调度浏览器执行抓取。
- 作为数据清洗与落库的流水线管道:抓取动作完成后,Python 负责对接数据库、生成报表或执行校验,这个阶段通常通过现成的模板脚本静默执行。
二、场景一:利用 Python 驱动免代码可视化爬虫
对于不需要处理复杂逆向加密的常规站点,完全可以借助 Python 生态现有的可视化工具(例如基于 Python 构建的轻量级爬虫框架与图形化后台),通过点击界面的方式提取内容。
这里以基于 Python 环境部署可视化抓取与调度工具为例。你只需要在命令行执行安装与启动命令,后续工作无需再碰任何代码:
# 步骤 1:在系统中安装调度框架与控制台支持
pip install gerapy scrapyd

# 步骤 2:初始化工程目录并启动服务端
gerapy init
cd gerapy
gerapy migrate
gerapy runserver 0.0.0.0:8000注意:执行上述命令前,确保本地已配置好 Python 3.9 及以上运行环境。启动后看到类似 Starting development server at http://0.0.0.0:8000/ 的输出,即表示服务运行正常。
完成启动后,打开浏览器访问该地址,你可以直接进行如下操作:
- 在页面输入目标网站 URL,通过界面内置的解析器辅助定位元素。
- 在输入框中填入 CSS 选择器或通过鼠标框选区域,系统会自动标记标题、正文、发布时间等字段。
- 点击“生成规则”,系统后台会自动将你的配置转化为可执行的调度任务。
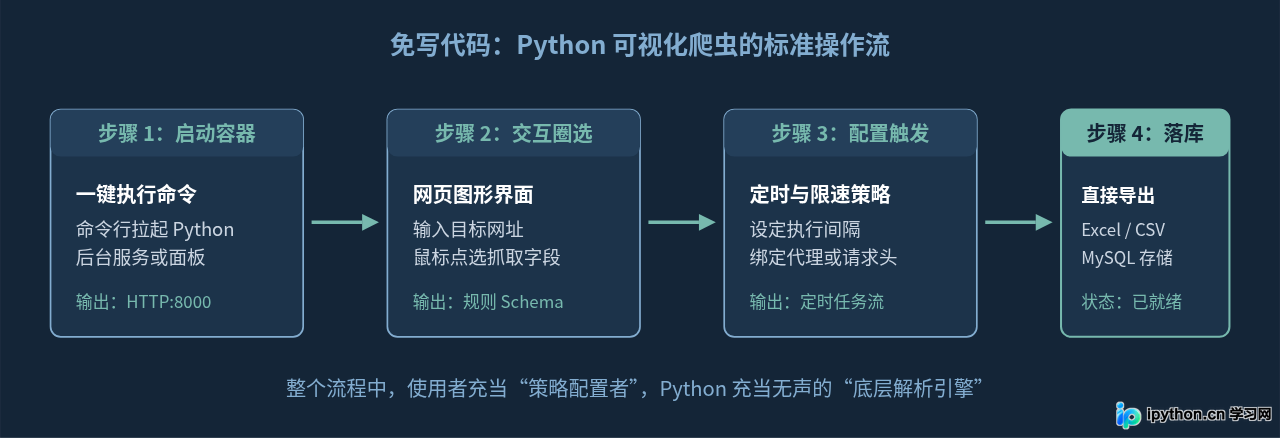
图 2:通过可视化平台执行抓取的四个核心步骤
三、场景二:作为自动化抓取服务的“中枢调度器”
在企业级或长期稳定的采集工程中,写爬虫代码往往只占两成工作量,另外八成在于调度、资源维护与容错。这时,Python 的用途变成了基础设施支撑者:
- 动态代理池分发:目标站点限制 IP 访问频率时,使用开源的 Python 代理池组件(如 ProxyPool),它会自动检测互联网中的可用代理、测试延迟、踢除失效节点,并提供一个统一的本地 API 地址。你任何其他爬虫工具只需调用这个接口,无需手写校验逻辑。
- Headless 无头浏览器容器化常驻:利用预制镜像通过 Python 快速拉起 Playwright 或 Selenium 集群,为外部各种无代码工具提供渲染 JavaScript 页面的能力。
- 任务分发与健康检测:使用基于 Python 的 Celery 或 RQ 框架监听任务队列,一旦某个采集任务发生超时,自动重试并触发告警。
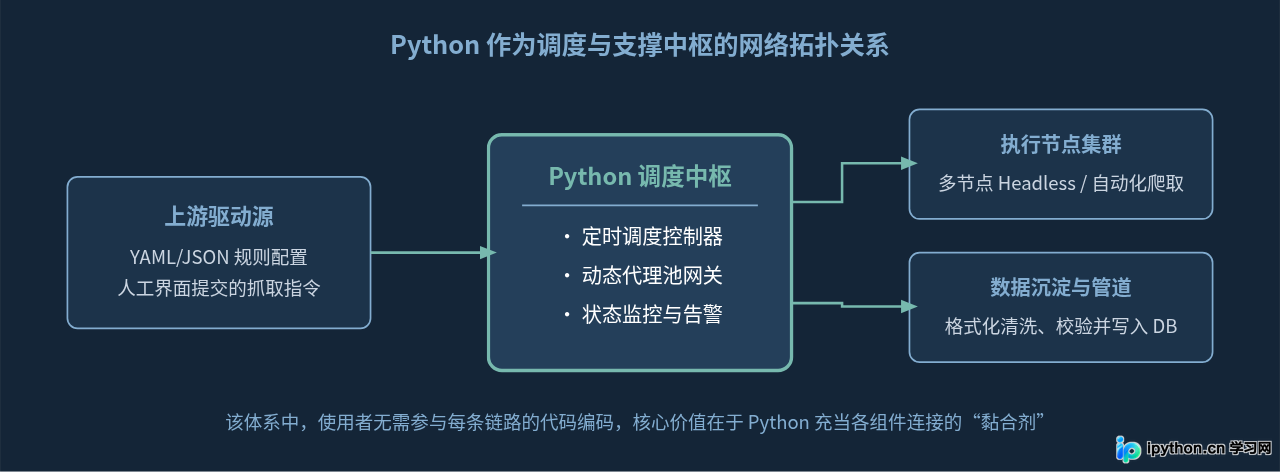
图 3:Python 充当采集链路中枢组件与关系网络
四、两种路径的实际对比与选择依据
决定是“手写 Python 代码”还是“直接使用 Python 生态现成工具”,取决于面对的抓取难度与维护成本:
| 对比维度 | 传统手写代码模式(Requests / Scrapy 等) | Python 工具与平台模式(Gerapy / 规则引擎) |
|---|---|---|
| 前置技能要求 | 必须掌握 Python 语法、DOM 树、异步机制及调试 | 仅需理解基本的 URL 规则、CSS 选择器与网页结构 |
| 首批规则上线耗时 | 较长。需搭架子、写测试、单文件调试 | 极快。启动容器或平台后,鼠标点选几分钟即刻抓取 |
| 复杂反爬应对能力 | 极强。可任意注入 JS、修改 TLS 指纹、逆向扣代码 | 较弱。主要应对常规接口、未加密或轻度加密网页 |
| 多站点批量管理 | 需自行维护脚本库,多站点容易混乱 | 优势明显。统一在控制面板启停、监控运行耗时与成功率 |
五、总结:如何重新理解“Python 与网络爬虫”
回到最初的问题:“除了写代码,Python 还能用于网络爬虫吗?”答案不仅是“能”,而且在实际业务落地中,它常常以更高效的方式出现。
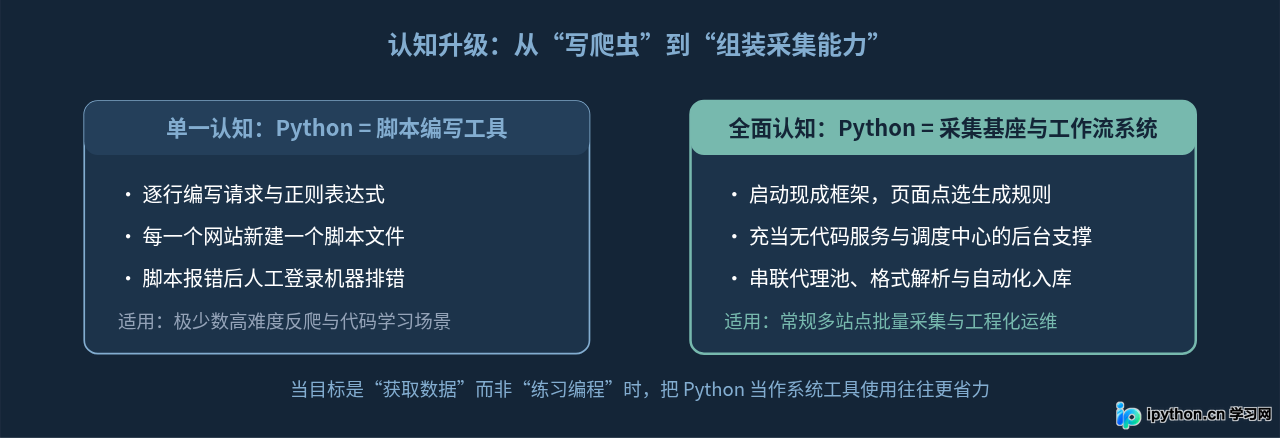
图 4:Python 在网络爬虫领域的应用认知总结
如果你手头有网页抓取需求,并不需要因为“自己编程还不熟练”而止步。学会利用 Python 已经封装好的成熟平台与运维中间件,以配置代替编码、以现成工具代替轮子,同样能够高效稳定地完成网络数据的自动化采集。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















