


Python实现海量表情包多线程爬虫:从环境配置到代码详解

发布时间:2026-10-14 |
5人浏览过
本文详细介绍如何使用Python结合requests、bs4及多线程技术,实现海量表情包的自动抓取与本地保存。内容涵盖环境配置、核心类设计、URL解析逻辑及完整的爬虫代码示例,帮助开发者快速掌握并发爬取技巧。
一、前言
在日常社交聊天中,表情包是重要的沟通元素。本文将演示如何利用Python编写爬虫程序,一键批量获取并下载海量表情包资源。
二、知识点
本案例涉及的核心技术包括:requests网络请求库、bs4网页选择器、本地文件读写操作以及多线程并发处理。
三、所用到得库
import os
import requests
from bs4 import BeautifulSoup
四、 功能
# 多线程程序需要用到的一些包
# 队列
from queue import Queue
from threading import Thread
五、环境配置
运行环境要求Python 3.6及以上版本,建议使用PyCharm专业版作为开发编辑器(需获取激活码)。
六、多线程类代码
# 多线程类
class Download_Images(Thread):
  # 重写构造函数
  def __init__(self, queue, path):
    Thread.__init__(self)
    # 类属性
    self.queue = queue
    self.path = path
    if not os.path.exists(path):
      os.mkdir(path)
  def run(self) -> None:
    while True:
      # 图片资源的url链接地址
      url = self.queue.get()
      try:
        download_images(url, self.path)
      except:
        print('下载失败')
      finally:
        # 当爬虫程序执行完成/出错中断之后发送消息给线程 代表线程必须停止执行
        self.queue.task_done()
七、爬虫代码
# 爬虫代码
def download_images(url, path):
  headers = {
    'User-Agent':
      'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'
  }
  response = requests.get(url, headers=headers)
  soup = BeautifulSoup(response.text, 'lxml')
  img_list = soup.find_all('img', class_='ui image lazy')
  for img in img_list:
    image_title = img['title']
    image_url = img['data-original']

    try:
      with open(path + image_title + os.path.splitext(image_url)[-1], 'wb') as f:
        image = requests.get(image_url, headers=headers).content
        print('正在保存图片:', image_title)
        f.write(image)
        print('保存成功:', image_title)
    except:
      pass

if __name__ == '__main__':
  _url = 'https://fabiaoqing.com/biaoqing/lists/page/{page}.html'
  urls = [_url.format(page=page) for page in range(1, 201)]
  queue = Queue()
  path = './threading_images/'
  for x in range(10):
    worker = Download_Images(queue, path)
    worker.daemon = True
    worker.start()
  for url in urls:
    queue.put(url)
  queue.join()
  print('下载完成...')
八、爬取效果图片
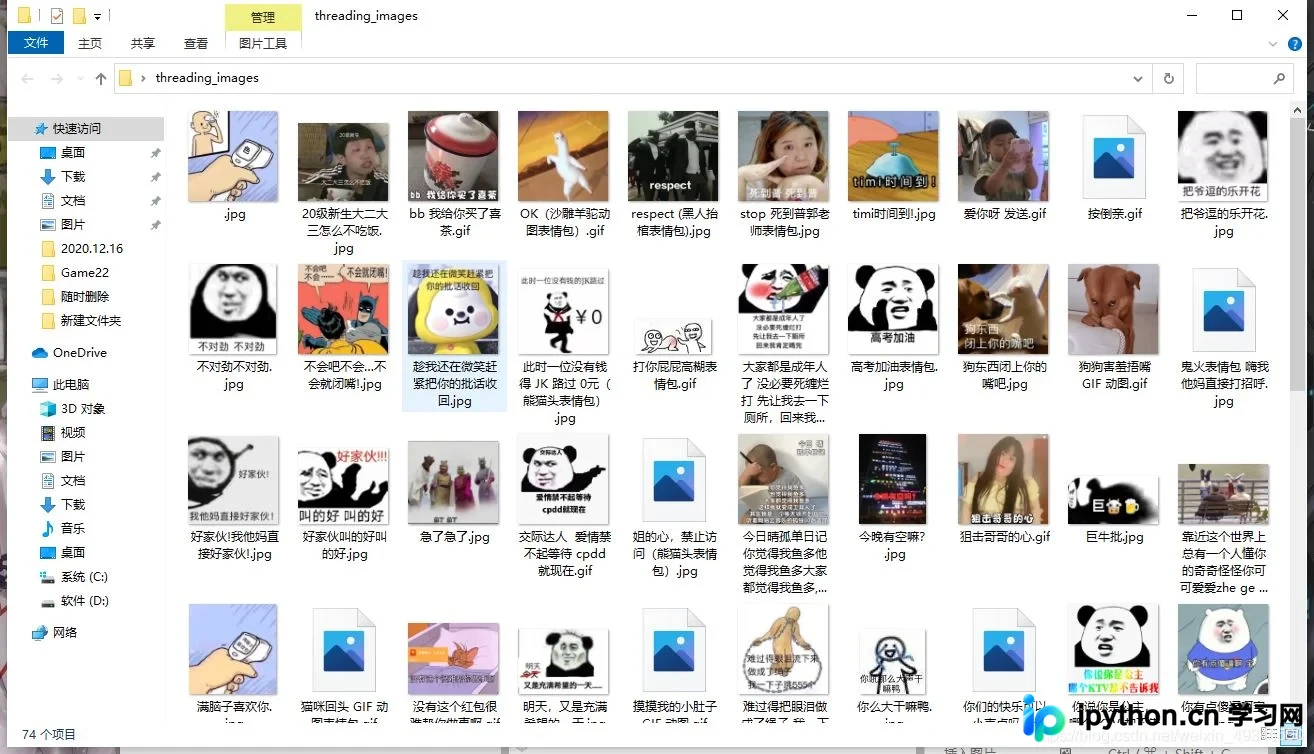
至此,关于Python基础进阶之海量表情包多线程爬虫的教程介绍完毕。如需了解更多Python多线程爬虫相关内容,建议查阅本站过往文章或继续浏览后续教程,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















