


AI写作检测是怎么工作的:困惑度与突发性分析原理解析

在内容创作日益依赖辅助工具的今天,许多作者面临着一个微妙的困境:明明是自己逐字敲出的文章,却被检测工具标记为“高风险”;而有时经过精心润色的段落,反而因为过于流畅平滑而被怀疑是机器所为。这种猫鼠游戏般的焦虑,往往源于我们对黑盒背后机制的无知。
AI写作检测并非拥有某种神秘的“意识”来审视文本的灵魂,它本质上是一场基于统计学的概率博弈。检测工具并不直接读取思想,而是通过两个核心数学指标——困惑度(Perplexity)和突发性(Burstiness),来量化文本的“不可预测性”与“节奏变化”。
理解这两个概念,是摆脱盲目焦虑、理性使用检测工具的第一步。 它们揭示了人类语言与机器生成语言在底层结构上的根本差异:人类语言充满噪点与跳跃,而AI语言倾向于平滑与均衡。
困惑度:衡量文本的“意外程度”
想象你在阅读一本悬疑小说,如果下一句话完全在你的意料之中,比如“他打开了门,走了进去”,你的大脑几乎不需要消耗额外的认知资源去处理这个信息。但如果下一句是“他打开了门,发现里面坐着一只穿着西装的企鹅”,你的大脑会瞬间警觉,因为这句话的“意外程度”极高。
在自然语言处理中,困惑度正是用来衡量这种“意外程度”的指标。大型语言模型(LLM)在生成文本时,本质上是根据前文预测下一个词出现的概率。如果一个词出现的概率很高,模型就很有“信心”;如果概率很低,模型就会感到“困惑”。
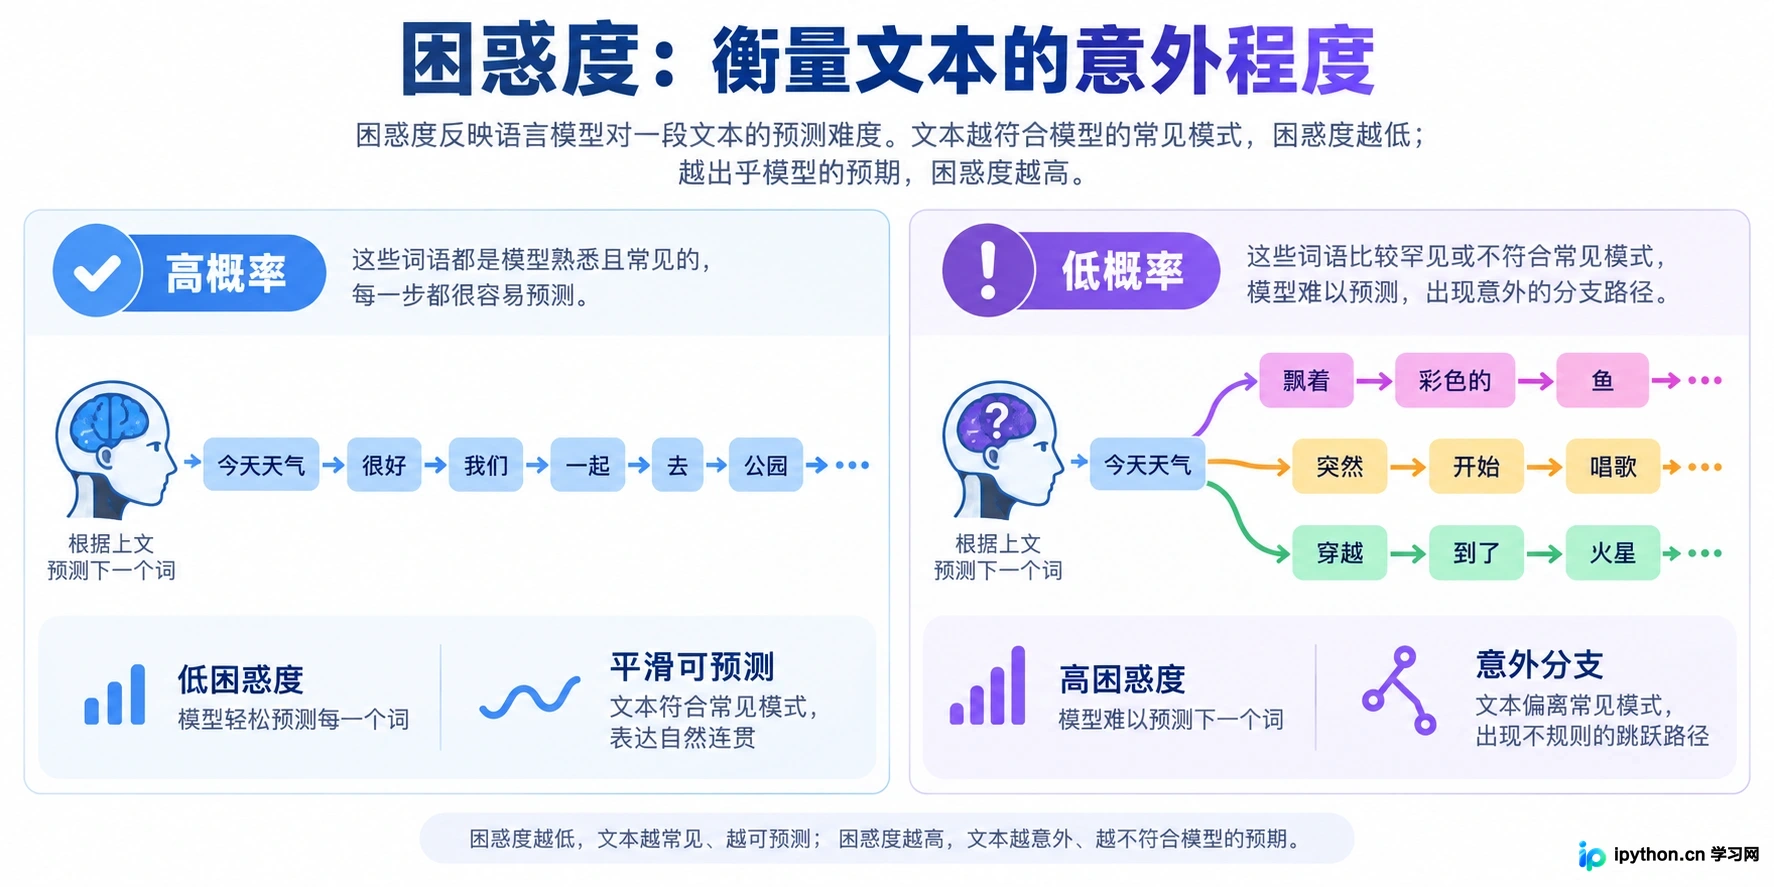
困惑度示意图:左侧为高概率预测的平滑路径,右侧为低概率预测的意外分支
AI生成的文本通常具有较低的困惑度。这是因为主流的大语言模型经过海量数据训练,其核心目标就是生成最符合统计规律、最通顺、最“像人话”的内容。为了降低错误率,模型倾向于选择那些在上下文中概率最高的词汇组合。因此,AI写出的句子往往语法完美、逻辑连贯,但缺乏那种让人眼前一亮或眉头一皱的“意外感”。
相比之下,人类写作充满了低概率的选择。我们会使用生僻的比喻、倒装的句式,甚至是有意的语法破格来表达情绪或强调重点。这些选择在统计模型看来是“高困惑度”的,因为它们偏离了常规的概率分布。
在这种场景下,检测工具会计算整段文本的平均困惑度。如果一段文字读起来过于顺滑,每个词都像是前一个词的必然结果,那么它被判定为AI生成的可能性就会增加。但这并不意味着低困惑度一定等于AI,专业领域的严谨文档或新闻简报本身就需要低歧义和高可预测性,这往往是误判的重灾区。
突发性:捕捉语言的“节奏脉搏”
如果说困惑度关注的是单个词汇的选择,那么突发性(Burstiness)关注的则是句子结构和长度的变化节奏。人类说话和写作是有呼吸感的,我们不会始终保持同样的语速和句式。
试想一下日常对话:你可能会先用一个简短有力的短句表达观点,“这不行。”接着用一个复杂的长句解释原因,“因为目前的资源分配机制存在结构性缺陷,导致核心项目无法获得足够的支持。”然后再用一个反问句加强语气,“难道我们要一直这样下去吗?”
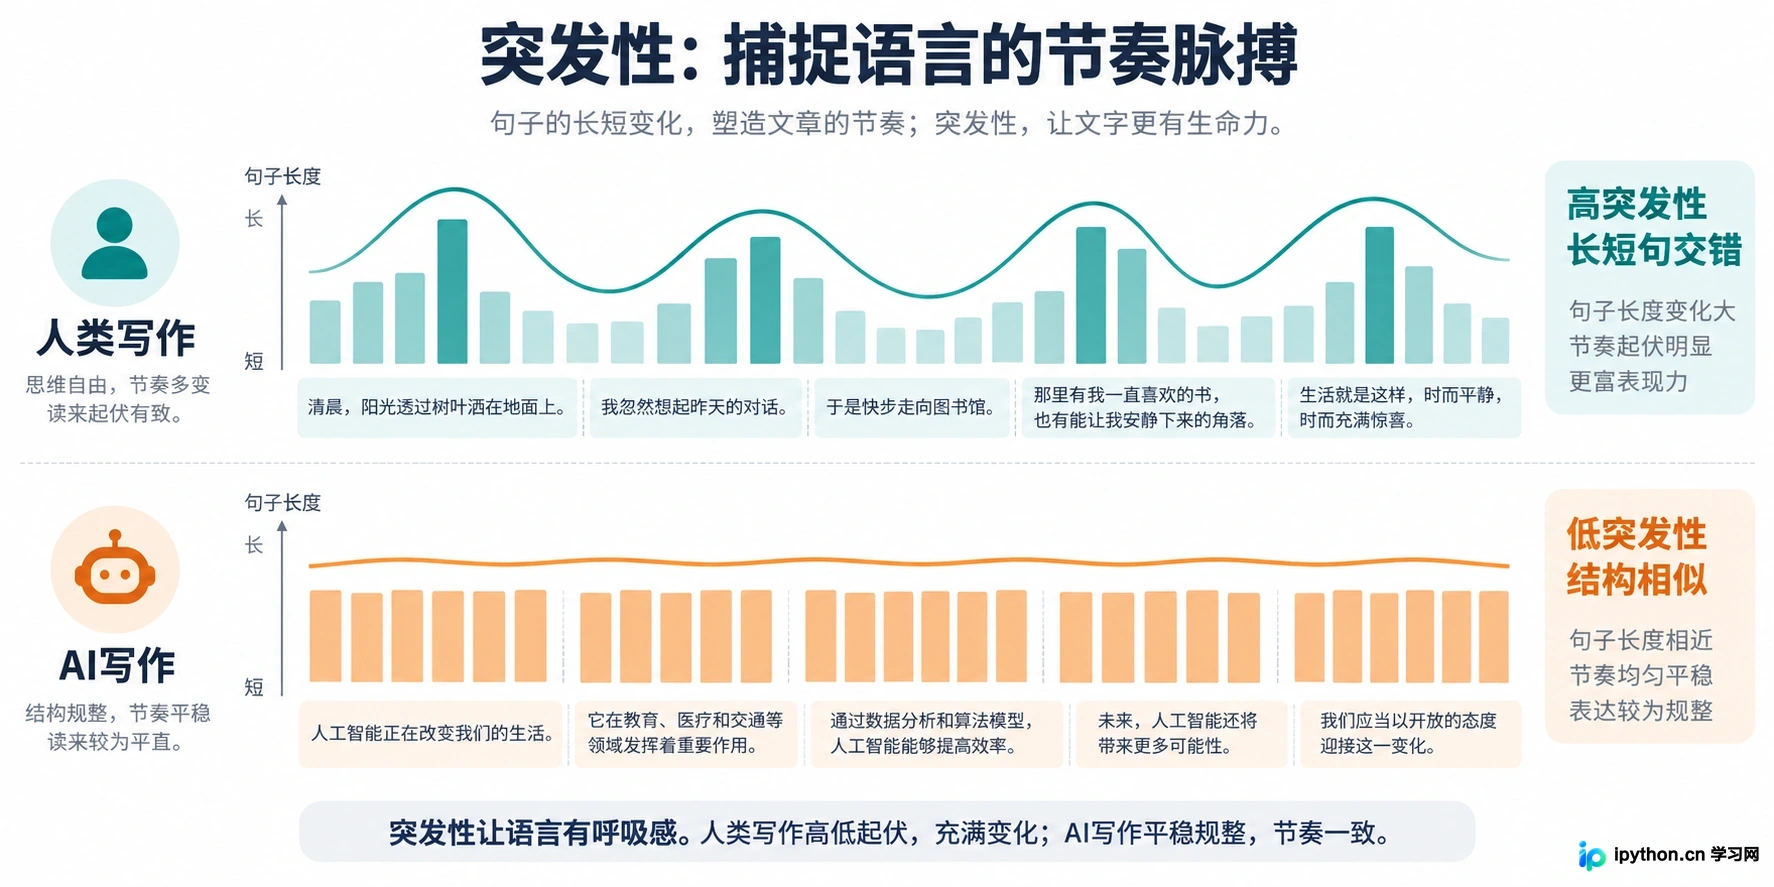
突发性对比:人类写作的波浪形节奏与AI写作的平稳直线
这种长短句交错、简单结构与复杂从句混合的模式,就是高突发性的体现。人类的思维是发散的、跳跃的,反映在文本上就是句式结构的剧烈波动。
然而,AI模型在生成文本时,往往表现出较低的突发性。为了保持上下文的连贯性和稳定性,AI倾向于生成长度相近、结构相似的句子。它可能会连续使用三个结构相同的排比句,或者一直保持中等长度的陈述句。这种均匀的节奏虽然读起来舒适,但在统计学上显得过于“平稳”,缺乏人类语言特有的脉冲式波动。
检测工具通过分析句子长度的方差、句法结构的多样性来计算突发性得分。如果一篇文章的句子长度分布非常集中,句法结构高度重复,即使词汇选择再丰富,也可能因为缺乏节奏变化而被标记。这就是为什么很多AI生成的文章读起来有一种“平庸的流畅感”,挑不出错,但也记不住任何亮点。
场景实测:当严谨遇上算法偏见
理论上的完美区分,在现实场景中往往会遇到边界模糊的地带。不同的写作目的和文体,对困惑度和突发性的要求截然不同,这也导致了检测工具在不同场景下的表现差异巨大。
在创意写作场景中,人类作者通常会刻意追求高困惑度和高突发性,以营造独特的风格。此时,AI检测工具通常能较准确地区分人类与机器,因为AI很难模仿那种极具个人色彩的隐喻和非线性叙事。但如果人类作者刻意模仿某种标准化文体,或者AI经过了特殊的提示词工程(Prompt Engineering)引导去模拟“不完美”,检测的准确率就会大幅下降。
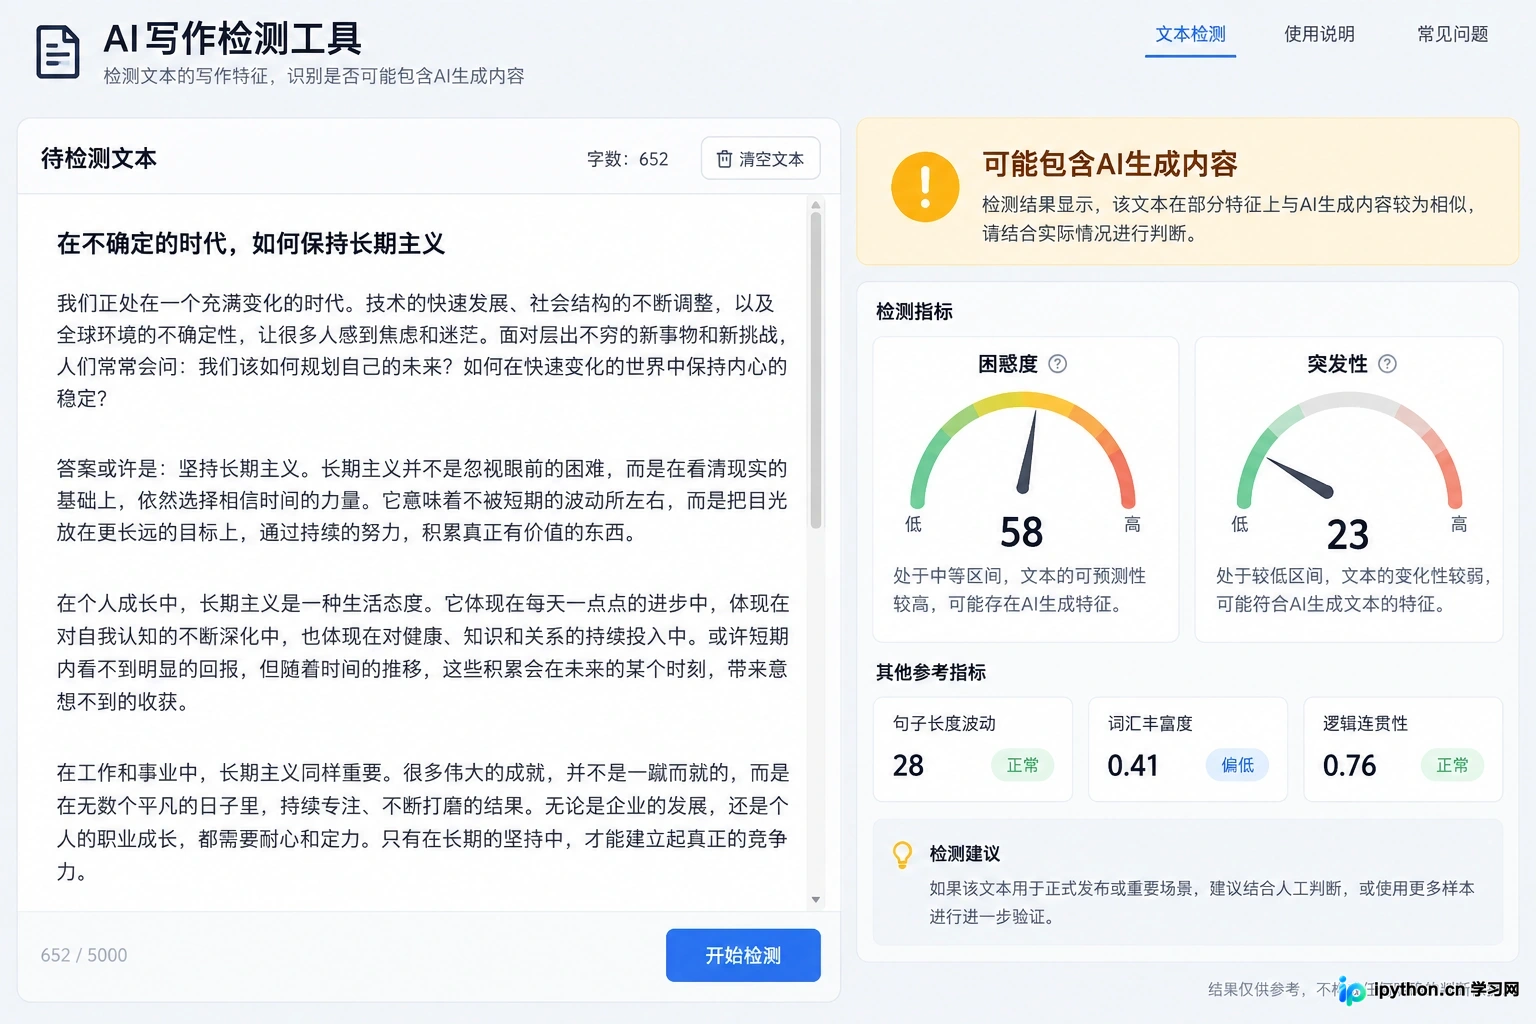
AI检测工具界面:显示困惑度与突发性得分的分析面板
更常见的误判发生在专业技术文档或学术写作中。这类文本要求术语准确、逻辑严密、句式规范,本身就具有低困惑度和低突发性的特征。一篇高质量的医学论文摘要,可能因为用词精准、句式工整,而被检测工具误认为是AI生成的。反之,一些由AI生成但经过大量人工改写、插入个人案例和情感表达的文本,可能因为引入了高困惑度的元素而逃过检测。
这表明,检测工具并不是在判断“真假”,而是在判断“像不像典型的AI输出”。 它是一个基于统计特征的分类器,而非真理裁判官。当人类写作趋向于标准化、规范化时,它与AI输出的统计特征重合度就会提高,从而导致假阳性(False Positive)的增加。
边界与反思:技术不是终点
理解了困惑度与突发性的工作原理,我们就能更清醒地看待AI写作检测的结果。它提供的只是一个概率参考,而非最终判决。对于教育机构和内容平台而言,过度依赖单一的检测分数可能会带来不公,尤其是对于那些写作风格严谨、规范的学生或专业人士。
人类作者与AI工具协同工作的桌面场景
未来的检测技术可能会引入更多维度,如语义一致性深度分析、知识图谱验证等,但核心的博弈依然存在:AI在不断进化以模仿人类的“不完美”,而人类也在不断调整写作以适应或规避检测。在这场博弈中,最重要的不是如何通过检测,而是如何保留写作中那些真正属于人类的特质——独特的视角、真实的情感体验以及打破常规的思考路径。
毕竟,工具可以生成通顺的文字,但无法生成只有你才能经历的故事。 当我们在意检测分数时,或许更应在意的是,我们的文字是否还保留着那份独一无二的“人性噪点”。
抽象艺术:代表人类情感与独特视角的光点
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















