


Python中使用CuPy实现GPU加速:从NumPy迁移与性能对比

本文详解如何利用CuPy库在Python中调用GPU进行加速计算。通过对比NumPy与CuPy在多线程、多进程及单线程下的矩阵乘法性能,展示CuPy显著的速度优势。文章提供安装方法、代码示例及实际运行结果,帮助开发者理解如何将NumPy代码迁移至GPU环境以大幅提升数据处理效率。
CuPy安装与基础替换
CuPy可以被视为CUDA版的NumPy,其安装方式pip install cupy。假设
import numpy as np
import cupy as cp
那么在np.XXX中一般的操作可以直接替换为cp.XXX。
实际上numpy已经足够快速,因为它由C语言编写,每次运行时都会尽力调用系统资源。为了验证这一点,我们可以通过矩阵乘法测试numpy的速度及其对资源的调度情况,具体涉及多线程并发、多进程并行以及单线程执行方式,相关代码为
NumPy多线程与多进程性能测试
# th_pr_array.py
from threading import Thread
from multiprocessing import Process
from time import time as Now
import numpy as np
import sys

N = 3000

def MatrixTest(n,name,t):
    x = np.random.rand(n,n)
    x = x@x
    print(f"{name} @ {t} : {Now()-t}")

def thTest():
    t = Now()
    for i in range(5):
        Thread(target=MatrixTest,args=[N,f'th{i}',t]).start()

def prTest():
    t = Now()
    for i in range(5):
        Process(target=MatrixTest,args=[N,f'pr{i}',t]).start()

if __name__=="__main__":
    if sys.argv[1]=="th":
        thTest()
    elif sys.argv[1]=="pr":
        prTest()
    else:
        t = Now()
        for i in range(5):
            MatrixTest(N,"single",t)
运行结果如下所示:
(base) E:\Documents\00\1108>python th_pr_numpy.py th th0 @ 1636357422.3703225 : 15.23965334892273 th1 @ 1636357422.3703225 : 17.726242780685425 th2 @ 1636357422.3703225 : 19.001763582229614 th3 @ 1636357422.3703225 : 19.06676197052002 th4 @ 1636357422.3703225 : 19.086761951446533
(base) E:\Documents\00\1108>python th_pr_numpy.py pr pr3 @ 1636357462.4170427 : 4.031360864639282 pr0 @ 1636357462.4170427 : 4.55387806892395 pr1 @ 1636357462.4170427 : 4.590881824493408 pr4 @ 1636357462.4170427 : 4.674877643585205 pr2 @ 1636357462.4170427 : 4.702877759933472
(base) E:\Documents\00\1108>python th_pr_numpy.py single single @ 1636357567.8899782 : 0.36359524726867676 single @ 1636357567.8899782 : 0.8137514591217041 single @ 1636357567.8899782 : 1.237830400466919 single @ 1636357567.8899782 : 1.683635950088501 single @ 1636357567.8899782 : 2.098794937133789
因此,在NumPy中应避免使用Python内置的并行和并发机制,这反而会成为累赘。通过上述对比,更能印证NumPy本身具备的强大性能。
然而,在cupy面前,上述速度显得微不足道。接下来进行连续5次创建5000x5000随机矩阵并执行矩阵乘法的测试:
CuPy与NumPy矩阵运算效率对比
#np_cp.py
import numpy as np
import cupy as cp
import sys
from time import time as Now

N = 5000

def testNp(t):
    for i in range(5):
        x = np.random.rand(N,N)
        x = x@x
    print(f"np:{Now()-t}")

def testCp(t):
    for i in range(5):
        x = cp.random.rand(N,N)
        x = x@x
    print(f"cp:{Now()-t}")


if __name__ == "__main__":
    t = Now()
    if sys.argv[1] == 'np':
        testNp(t)
    elif sys.argv[1]=='cp':
        testCp(t)
最终结果如下:
(base) E:\Documents\00\1108>python np_cp.py np np:8.914457082748413
(base) E:\Documents\00\1108>python np_cp.py cp cp:0.545649528503418
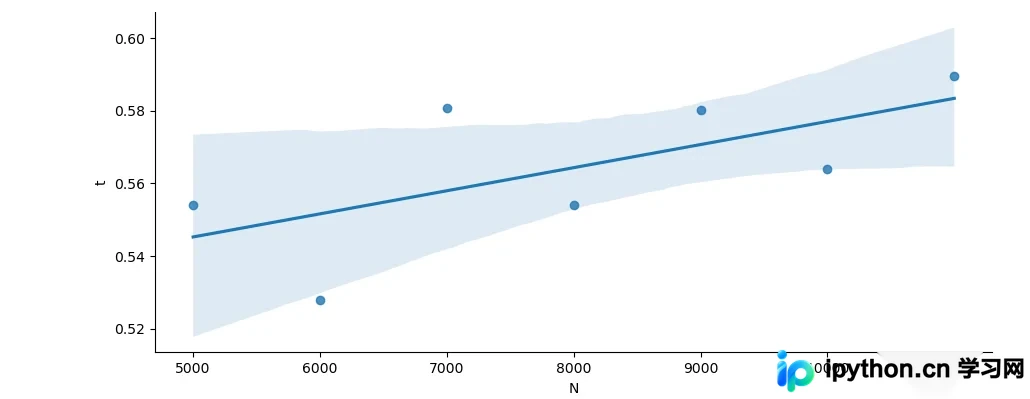
值得注意的是,当矩阵维度从5000x5000增加到15000x15000时,CuPy的计算时间并未发生显著变化,最多仅呈现线性增长。这是因为只要缓存能够容纳,无论矩阵多大,乘法运算无非是按行或按列增加,计算效率依然保持高位。
以上即为Python详解如何使用GPU大幅提高效率的详细内容,更多关于Python GPU提高效率的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















