


Python使用ddddocr实现简单验证码识别

本文介绍如何利用Python的ddddocr开源库进行简单的验证码识别。通过pip安装模块,实例化对象后读取图片二进制数据,调用classification方法即可输出识别结果。该方法适用于纯数字及字母数字混合验证码,虽精度有限但部署简便,适合数据采集场景。
前言
在进行数据采集时,若访问频率过高或请求过于频繁,网站往往会弹出验证码验证,导致程序中断无法继续。
本文将介绍一种处理此类验证码的简易方案。
环境配置
本方案依赖ddddocr模块,这是一个开源的OCR工具,具有使用简单、部署便捷的特点。尽管其识别精度并非最高,但在多数常规场景下表现良好。
若对识别精度有更高要求,建议调用第三方提供的专业API服务。
安装方法:按下Win+R键打开运行窗口,输入cmd并回车打开命令提示符,执行pip install ddddocr命令即可完成安装。
如需更详细的安装指导,可参考作者置顶文章中的完整教程。
代码实现
实现代码简洁,逻辑清晰。
安装完成后,首先导入模块:
import ddddocr接着实例化对象,并将实例赋值给变量cor以便后续调用。
ocr = ddddocr.DdddOcr()测试环节中准备了四张不同类型的验证码图片。
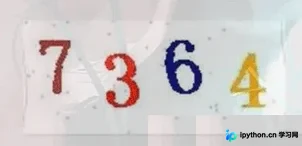
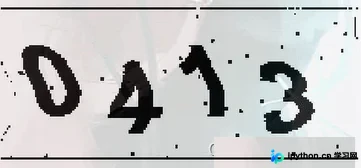
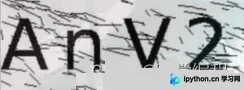
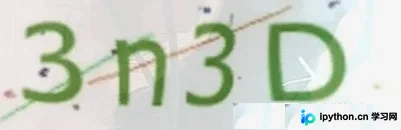
使用with open语句以二进制只读模式(rb)打开图片文件,以获取其二进制数据流。
with open('img_3.png', 'rb') as f:通过f.read()方法读取文件内容,并将读取到的数据赋值给自定义变量。
img_bytes = f.read()随后将数据传入classification方法进行识别,并打印输出识别结果。
result = ocr.classification(img_bytes)
print(result)
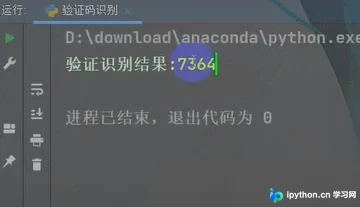
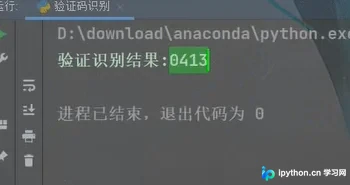
运行效果如下:
纯数字验证码识别结果
字母与数字混合验证码识别结果
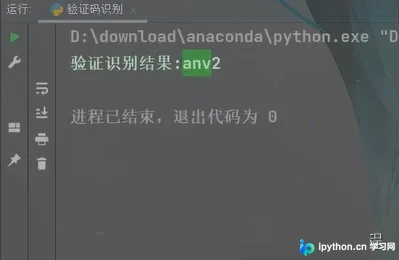
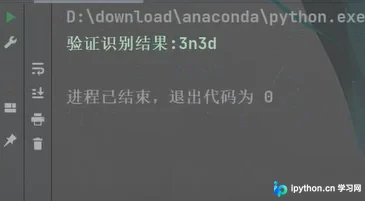
从结果可见,即使图片包含干扰线条等复杂背景,系统仍能准确识别出验证码内容。
完整代码示例
import ddddocr
ocr = ddddocr.DdddOcr()
with open('img_3.png', 'rb') as f:
    img_bytes = f.read()
result = ocr.classification(img_bytes)
print(result)
读者可自行测试该代码,或将其集成至实际的数据采集项目中。
以上就是关于利用Python实现简单验证码处理的全部内容,更多Python相关技术文章欢迎查阅本站往期内容或继续关注后续更新,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















