


Windows下Python多进程启动失败?spawn与fork模式兼容性解析

在 Linux 或 macOS 下运行正常的 Python 多进程脚本,一放到 Windows 系统中往往直接抛出 RuntimeError 崩溃或陷入死循环创建窗口。这种差异并非代码逻辑缺陷,而是由操作系统进程创建机制以及 Python 默认的多进程启动方式(spawn 与 fork)的不同决定的。本文直接剖析失败成因、工作流程与兼容方案。
一、Windows 环境下的典型报错与重现
在 Windows 上使用标准库 multiprocessing 编写多进程代码时,最常见的崩溃形式是进程不受控地反复拉起自身,随后输出如下典型的错误堆栈:
RuntimeError:
    An attempt has been made to start a new process before the
    current process has finished its bootstrapping phase.
    This probably means that you are not using fork to start your
    child processes and you have forgotten to use the proper idiom
    in the main module:

        if __name__ == '__main__':
            freeze_support()
            ...
导致该报错的最简代码往往形如以下写法。在 Linux 终端中运行这段代码可以按预期打印输出,但在 Windows 命令提示符中运行,子进程便会直接异常终止:
# 常见错误写法:未保护入口逻辑
import multiprocessing
import time

def worker(num):
    print(f"Subprocess {num} running")

# 直接在模块顶层创建并启动进程
p = multiprocessing.Process(target=worker, args=(1,))
p.start()
p.join()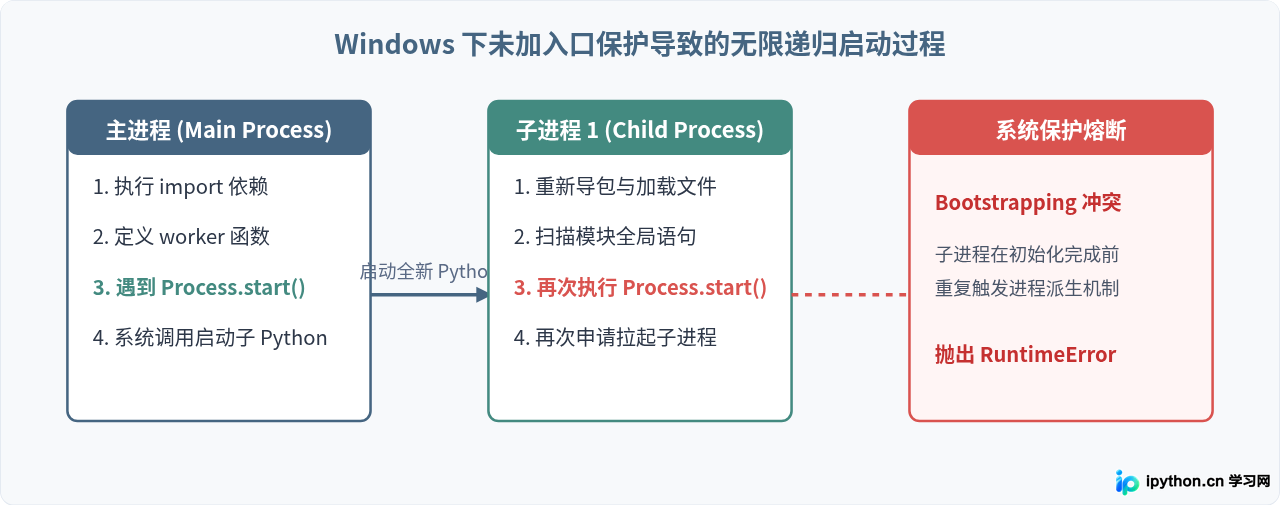
二、核心机制对比:spawn 与 fork 的底层区别
Python 在标准库提供了三种多进程启动方式:fork、spawn 和 forkserver。它们对操作系统的系统调用有不同的依赖。
1. fork 模式(类 Unix 系统专有)
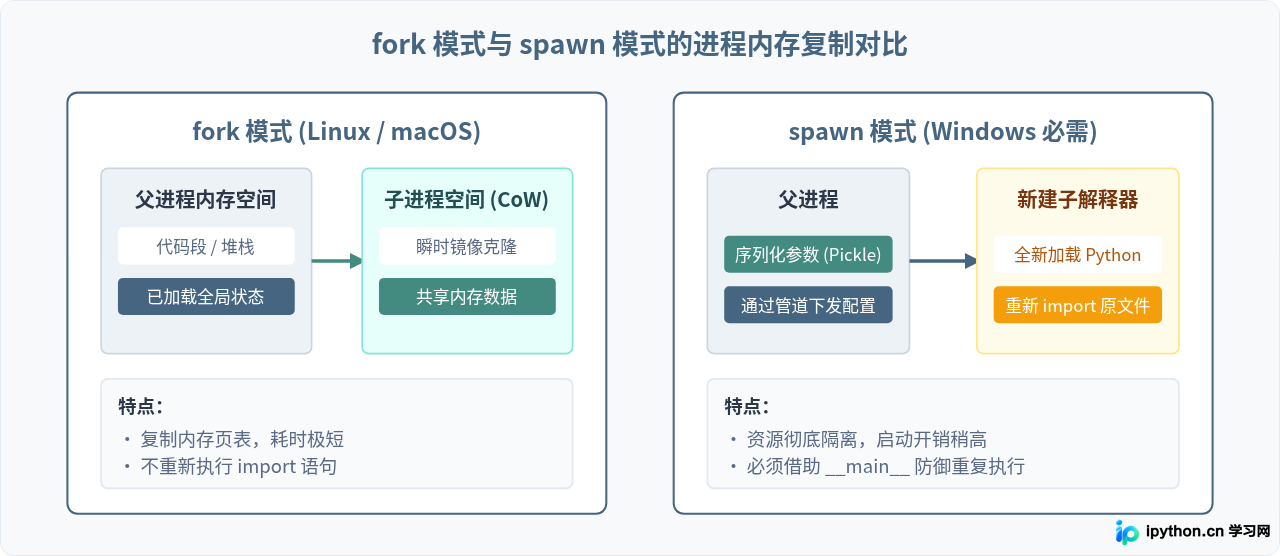
在 Linux 等 POSIX 系统中,默认或历史上广泛使用的模式是 fork。调用 os.fork() 时,操作系统内核会直接复制调用者进程的全部内存映射空间(采用写时复制 Copy-on-Write 机制)。子进程拥有与父进程完全相同的变量、资源描述符和当前代码执行点,因此子进程不需要重新执行 Python 脚本文件,它直接从创建点向下运行即可。
2. spawn 模式(跨平台与 Windows 默认)
Windows 内核从设计上就没有与 POSIX 语义等同的 fork() 系统调用(仅有 CreateProcessW 等)。因此,Windows 上的 Python 只能采用 spawn 模式。
在 spawn 模式下,父进程会启动一个完全干净的全新 Python 解释器。这个全新的解释器启动后,必须了解需要运行哪个目标函数以及函数的参数是什么。为了获得这些定义,子进程会隐式地把启动脚本作为模块重新导入(import)一遍。若启动代码写在顶层模块空间,导入时就会再次执行 p.start(),形成递归派生,最终被安全机制拦截并报错。
| 特性维度 | fork 模式 | spawn 模式 |
|---|---|---|
| 支持平台 | POSIX 兼容系统(Linux 等;macOS 已不再默认开启) | 所有主要平台(Windows, Linux, macOS) |
| 启动速度 | 极快(仅复制页表引用) | 较慢(需新建 Python 解释器进程) |
| 状态继承方式 | 自动继承父进程当前内存数据 | 数据必须能够被 pickle 序列化并通过通道传递 |
| 多线程安全性 | 较差(可能因 fork 锁状态导致死锁) | 高(环境纯净,没有继承旧线程的锁竞争风险) |
三、三步排查与标准修复流程
要在 Windows 环境下彻底消除多进程启动异常,并保证跨平台运行时行为一致,需要完成以下三步调整:
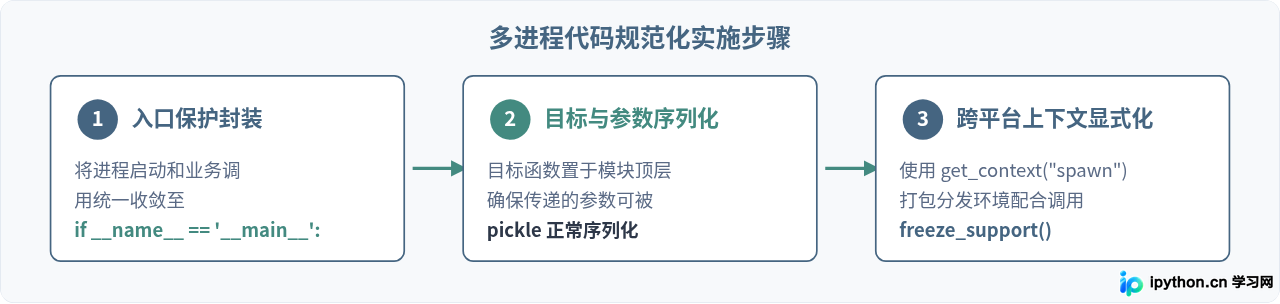
第一步:为执行入口增加模块保护
当 Python 脚本作为直接入口运行时,解释器会将其内置属性 __name__ 赋值为 "__main__";而当子进程通过 spawn 重新导入该文件时,__name__ 会变成模块名自身。利用这个机制,可以彻底截断子进程重新执行初始化代码:
import multiprocessing

def task(name):
    print(f"Task executed by {name}")

# 正确规范:保护主执行体
if __name__ == '__main__':
    p = multiprocessing.Process(target=task, args=("Worker-1",))
    p.start()
    p.join()
第二步:确保函数与参数具备可序列化性(Picklable)
在 spawn 模式下,任务对象与参数是通过 pickle 写入临时通道再发给子进程的。这意味着:
- 目标函数不能是匿名函数(
lambda)。 - 目标函数必须在模块顶层定义,不能是在另一个函数内部嵌套定义的闭包。
- 打开的文件句柄、数据库连接、未绑定的网络 Socket 等系统原生资源不能直接作为进程参数传递,需要改为在子进程内部单独建立,或使用进程池/管理器代理。
第三步:显式指定多进程 Context(跨平台一致性)
如果项目需要同时部署在 Linux 与 Windows 生产环境,建议不要依赖各系统的默认策略,而是直接通过 multiprocessing.get_context() 强制指定启动模式:
import multiprocessing

def compute(x):
    return x * x

if __name__ == '__main__':
    # 强制在所有平台统一定义为 spawn 模式,避免多系统运行时行为断层
    ctx = multiprocessing.get_context("spawn")

    with ctx.Pool(processes=4) as pool:
        results = pool.map(compute, [1, 2, 3, 4, 5])
print("计算结果:", results).exe 可执行文件,必须在 if __name__ == '__main__': 之后紧跟调用 multiprocessing.freeze_support(),以拦截打包环境下的进程再分发。
四、排查验证与自查清单
当多进程程序依然出现卡死、无响应或退出异常时,可以按照以下诊断逻辑进行快速确认:
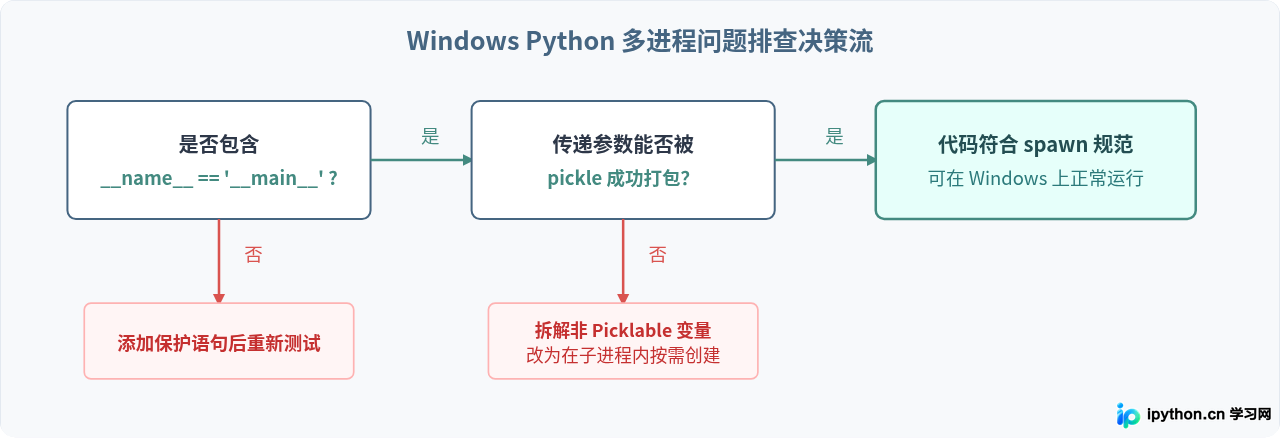
在编写跨平台 Python 应用时,牢固树立 spawn 模式的意识能够规避绝大多数平台差异陷阱。只要保证所有进程启动行为均处于模块入口保护之内,同时避免将不可序列化的系统层资源直接作为参数跨进程投递,多进程任务即可在 Windows 系统以及各类生产环境下保持一致且稳定的执行结果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















