


Python实现汉诺塔:递归算法原理与代码详解
深入解析汉诺塔问题的递归算法原理,提供清晰的Python代码实现、三层移动全过程追踪、递归调用树与时空复杂度分析,帮助读者彻底掌握分治递归思想与参数传递本质。
一、汉诺塔规则与问题的核心本质
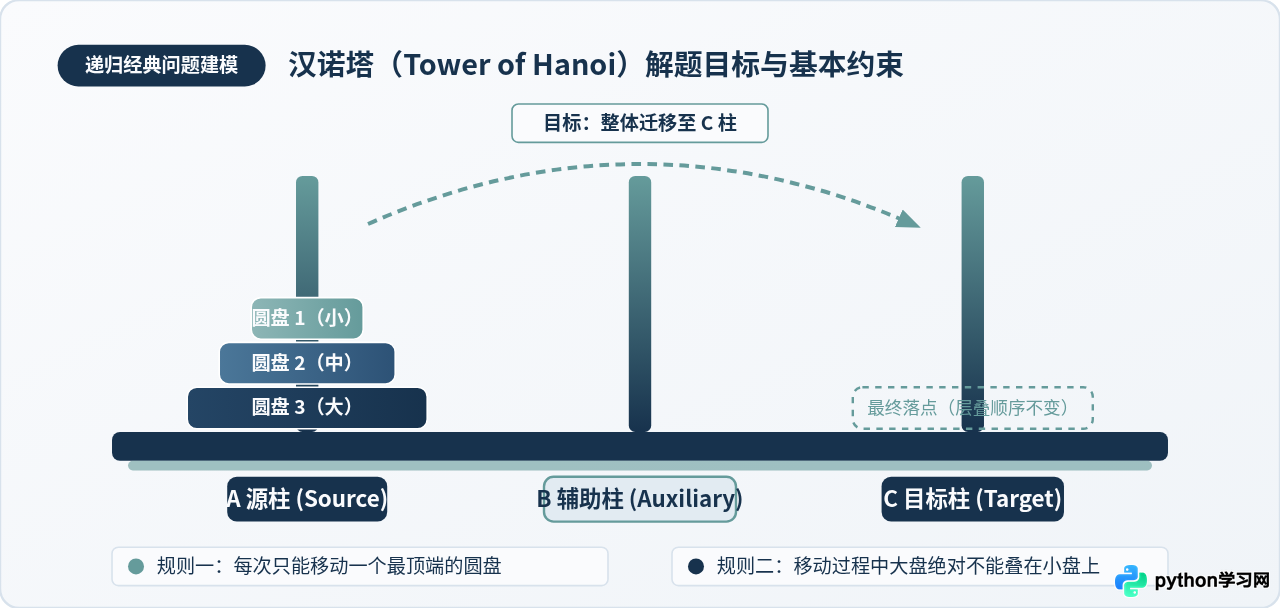
汉诺塔由法国数学家爱德华·卢卡斯于 1883 年提出。题目设定非常直观:有三根竖直放置的柱子,分别记为 A、B、C。在起始柱 A 上,自下而上按直径由大到小套着 n 个圆盘。解题的目标是将这 n 个圆盘完整迁移至目标柱 C 上。
在迁移过程中,必须严格遵守两条核心规则:
- 单次单盘:每次操作只能移动某根柱子最顶端的一个圆盘;
- 大盘不压小盘:在任何时刻、任意柱子上,较粗较大的圆盘都不能压在较小的圆盘上方。
对于只有 1 个圆盘(n=1)的情况,直接将圆盘从 A 移到 C 即可完成;当有 2 个圆盘(n=2)时,先将小盘移到 B,大盘移到 C,再把小盘移到 C,共需 3 步。然而,当圆盘数量增多时,如果试图凭借直觉或使用平铺直叙的循环语句来穷举每一步,状态空间会迅速膨胀,极易陷入逻辑混乱。解决这个问题的突破口,在于建立清晰的“递归思维”。
二、递归算法原理解析:分而治之的三步拆解
递归的核心理念是“先假设更小规模的问题已被解决”。面对规模为 n 的汉诺塔,我们的终极目标是把底盘(第 n 个、也是最大的盘子)稳稳放在目标柱 C 的底部。
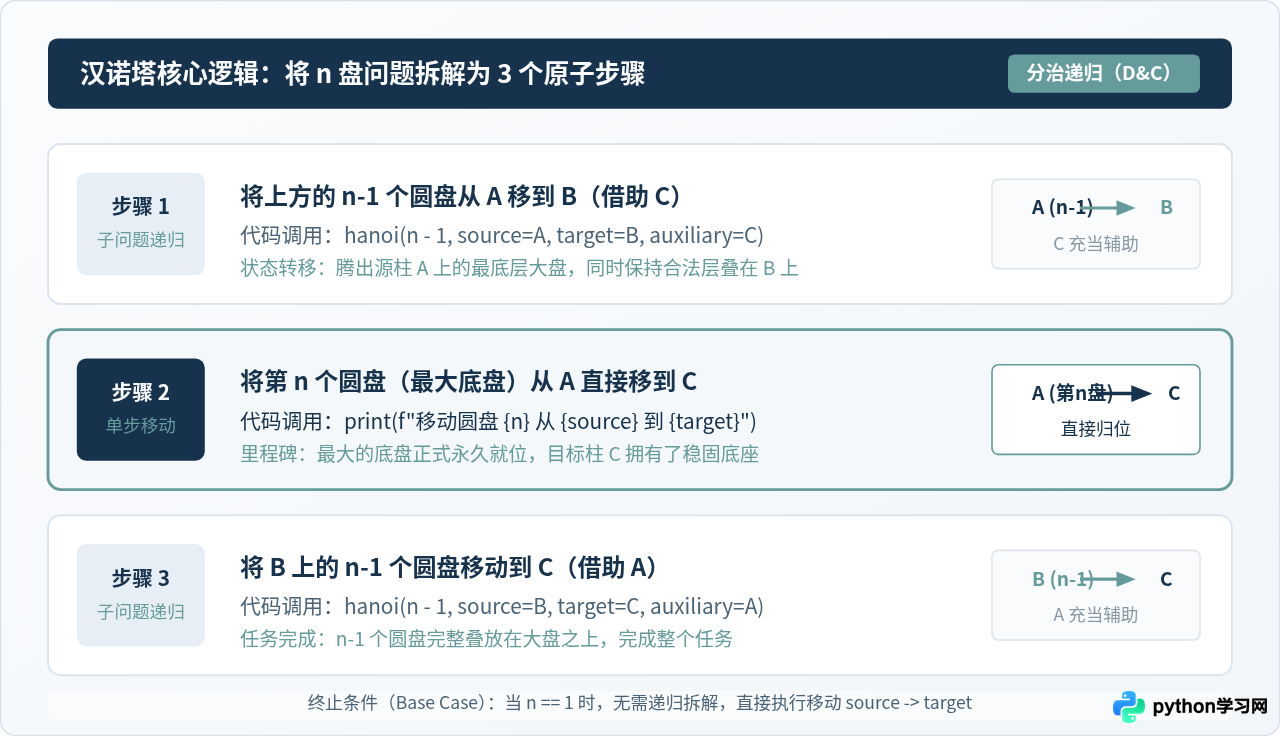
但此时底盘被上面的 n-1 个盘子死死压住,且目标柱 C 也不能被其他盘子占用。因此,整个求解逻辑自然分化为三个前后相继的子任务:
- 子任务 1(为底盘清理道路):把压在底盘上方的 n-1 个盘子,从源柱 A 移动到辅助柱 B。在此过程中,目标柱 C 临时充当辅助角色;
- 子任务 2(底盘落位):此时源柱 A 只剩第 n 个最大底盘,目标柱 C 也是空的。直接将第 n 个盘子从 A 移到 C;
- 子任务 3(圆盘最终回叠):此时底盘已经在 C 柱正确归位,且它是全局最大的盘,后续任何盘子放在它上面都绝对安全。我们只需把暂存在辅助柱 B 上的 n-1 个盘子,整体移到目标柱 C 上。在此过程中,源柱 A 临时充当辅助角色。
递归的基准出口(Base Case)非常简单:当 n == 1 时,没有任何压制物,直接一步把盘子从起点移到终点即可。
三、Python 代码实现与函数签名设计
将上述三步逻辑转换为 Python 代码极其简洁优美。为了让代码更具工程可读性,我们为函数添加清晰的类型注解和文档说明:
def hanoi(n: int, source: str, target: str, auxiliary: str) -> None:
    """
    使用递归算法解决汉诺塔问题并打印移动步骤
    :param n: 圆盘总数
    :param source: 源柱子名称(起始位置)
    :param target: 目标柱子名称(最终落点)
    :param auxiliary: 辅助柱子名称(中转缓冲)
    """
    if n <= 0:
        return

    # 基准出口:只有1个圆盘时,直接移动
    if n == 1:
        print(f"移动圆盘 1 从 {source} -> {target}")
        return

    # 步骤 1:将上方 n-1 个圆盘从 source 移到 auxiliary(借助 target)
    hanoi(n - 1, source=source, target=auxiliary, auxiliary=target)

    # 步骤 2:将第 n 个圆盘直接从 source 移到 target
    print(f"移动圆盘 {n} 从 {source} -> {target}")

    # 步骤 3:将 auxiliary 上的 n-1 个圆盘移到 target(借助 source)
    hanoi(n - 1, source=auxiliary, target=target, auxiliary=source)
请特别注意两次递归调用中柱子参数的位置变化。在函数签名中,第 2 个参数永远代表“起点”,第 3 个参数代表“终点”,第 4 个参数代表“中转点”。当执行步骤 1 时,我们的目标是辅助柱,因此把 auxiliary 传给形参 target;当执行步骤 3 时,起点是刚才的辅助柱,因此把 auxiliary 传给形参 source。
四、以 3 层汉诺塔(n=3)为例:7 步移动全流程追踪
理论上,移动 n 个圆盘所需的最少操作次数为 2ⁿ - 1。对于 n=3,总步数为 2³ - 1 = 7 步。
下面让我们追踪调用 hanoi(3, 'A', 'C', 'B') 时的控制台输出与柱子状态演变:
# 示例调用入口
if __name__ == "__main__":
    print("开始移动 3 层汉诺塔:")
    hanoi(3, 'A', 'C', 'B')
程序实际执行打印的 7 步操作结果如下:
开始移动 3 层汉诺塔:
第 1 步: 移动圆盘 1 从 A -> C
第 2 步: 移动圆盘 2 从 A -> B
第 3 步: 移动圆盘 1 从 C -> B
第 4 步: 移动圆盘 3 从 A -> C   [里程碑:底盘永久落位]
第 5 步: 移动圆盘 1 从 B -> A
第 6 步: 移动圆盘 2 从 B -> C
第 7 步: 移动圆盘 1 从 A -> C   [全部圆盘完成转移]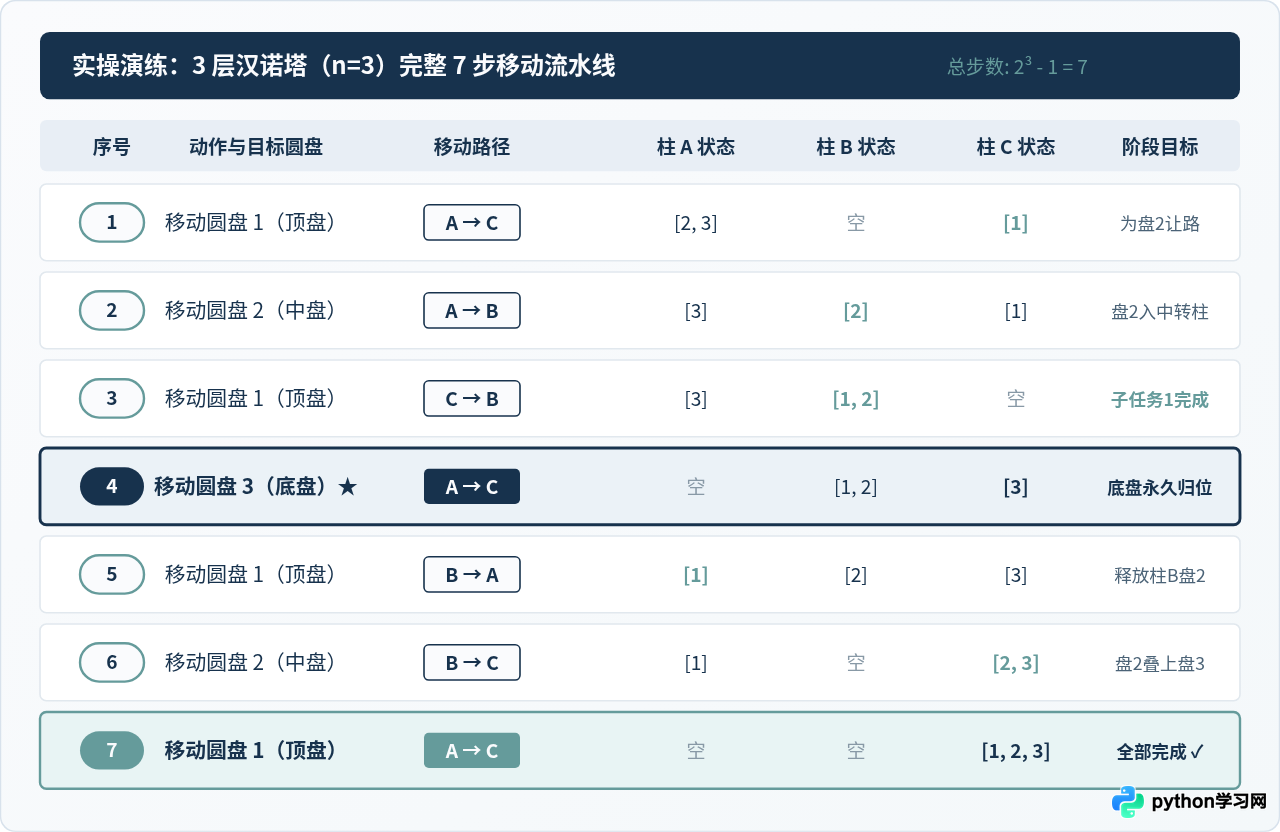
从上面的时序表可以看出:
- 前 3 步完成了步骤 1:成功把圆盘 1 和 2 转移到了柱 B,且盘 1 依然在大盘 2 上方;
- 第 4 步完成了步骤 2:把最大的盘 3 从 A 移到了 C;
- 后 3 步完成了步骤 3:把柱 B 上的圆盘 1 和 2 完整重构到了柱 C 的底盘 3 之上。
五、递归调用树与栈帧执行机制
为了看清 Python 解释器在内存中是如何调度这些函数的,我们可以将递归过程绘制为一棵二叉树。每一个非叶子节点都代表一次规模为 k 的 hanoi(k) 调用,它会向下分叉出两个 hanoi(k-1) 子节点,并在中间执行一次 print。
函数的实际执行顺序严格遵循深度优先遍历(中序遍历):左侧子树全部执行完毕并出栈后,才打印中间的大盘移动,随后再进入右侧子树。
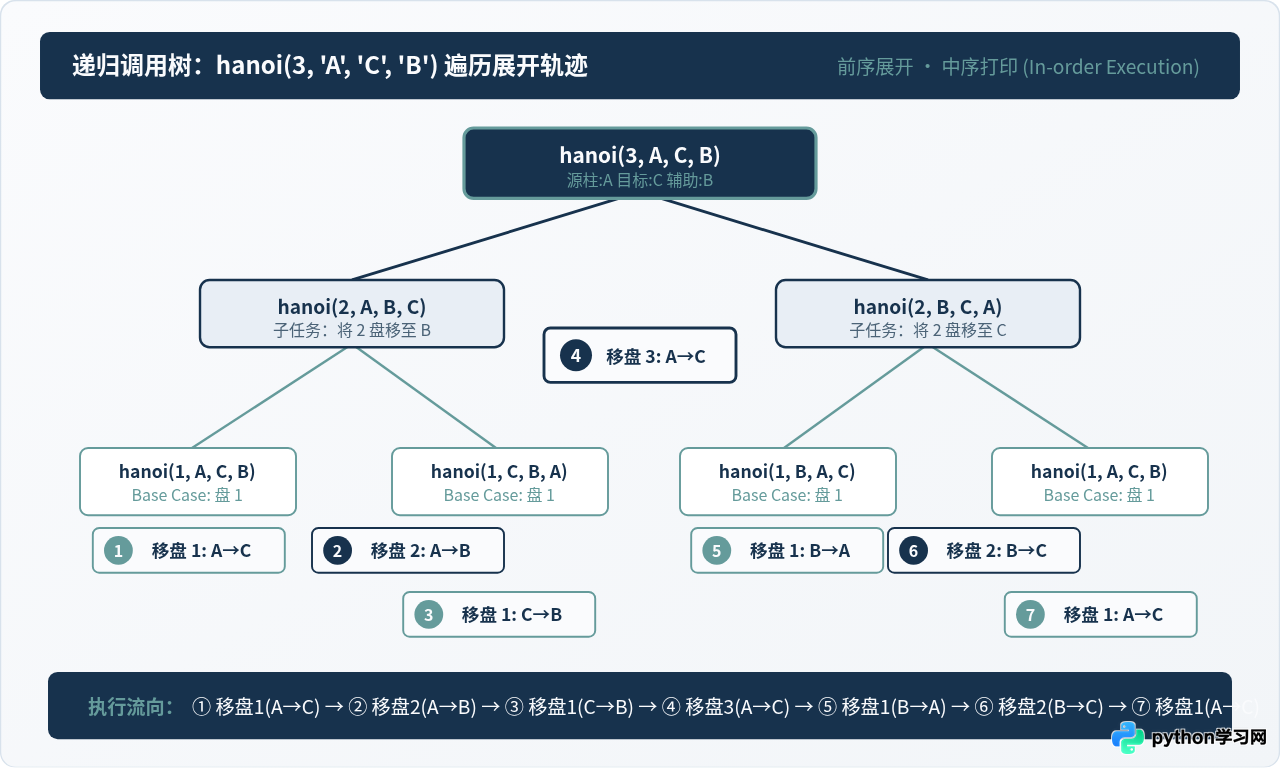
在系统底层,每一次调用都会向调用栈(Call Stack)压入一个栈帧,保存当前的 n、source、target 与 auxiliary 局部变量。当子函数返回后,栈帧弹出,程序恢复上层调用的现场。
六、复杂度分析与工程边界
汉诺塔问题不仅是递归算法的经典范例,也是指数级时间复杂度的典型代表。
1. 时间复杂度:O(2ⁿ)
设移动 n 个圆盘需要的操作次数为 T(n)。根据代码结构,可得递推公式:
T(1) = 1
T(n) = 2 * T(n - 1) + 1
两边同时加 1,可得 T(n) + 1 = 2 * (T(n-1) + 1)。这是一个以 T(1)+1 = 2 为首项、公比为 2 的等比数列。因此:
T(n) = 2ⁿ - 1
当 n 线性增加时,运算次数呈指数级暴增。这意味着该算法的时间复杂度为 O(2ⁿ)。
2. 空间复杂度:O(n)
虽然总步数高达 2ⁿ - 1,但算法在任意时刻占用的内存空间仅仅等于调用栈的深度。从调用树中可以看出,从根节点下探到最深叶子节点,栈中最多同时并存 n 个栈帧。因此算法的辅助空间复杂度仅为 O(n)。
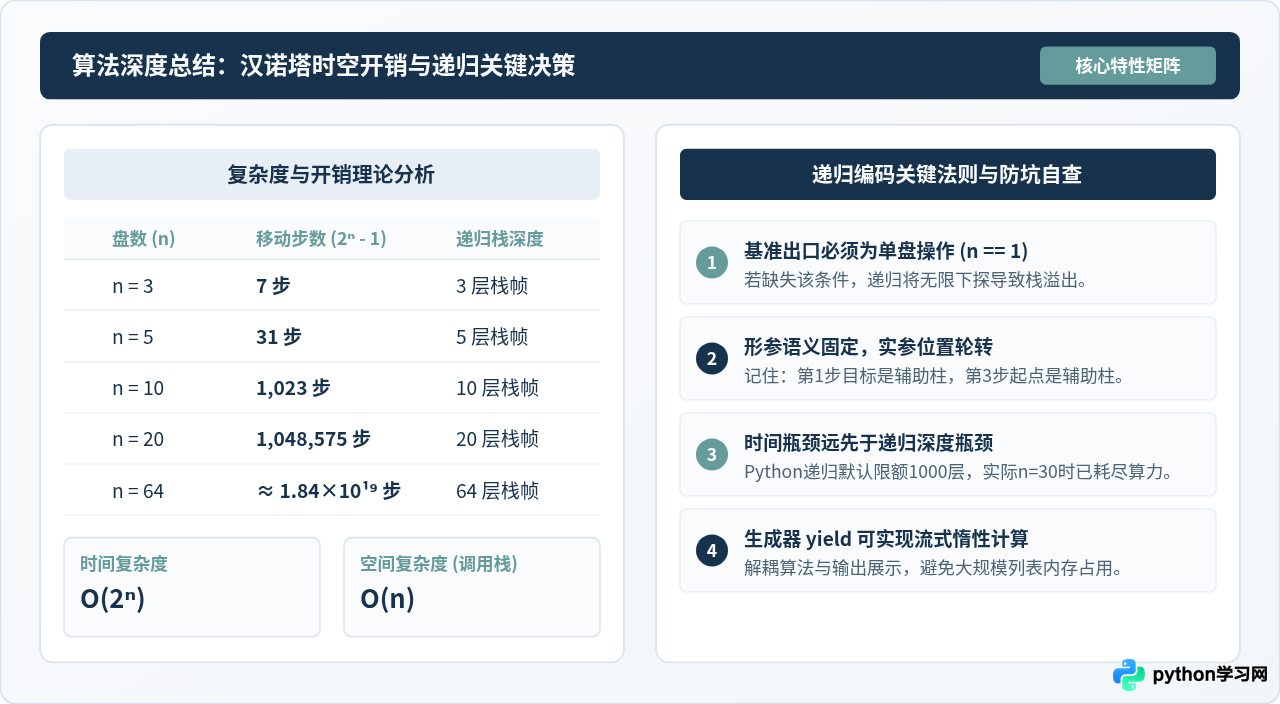
Python 的默认递归深度限制为 1000(可通过 sys.getrecursionlimit() 查询)。很多读者初学递归时会担心汉诺塔导致栈溢出。但实际上,当 n=30 时,步数已超过 10 亿次,在普通计算机上需要运行数分钟;当 n=64 时,需要 1.84×10¹⁹ 次操作,即使超级计算机也无法在人类有生之年跑完。因此,汉诺塔的限制是由于时间上的指数级爆炸,在达到 1000 层的空间限制前,物理耗时就已经不可承受。
七、常见误区与排错建议
初学者在编写和调试汉诺塔递归时,常在以下三个细节出现失误:
| 常见错误 | 典型表现与后果 | 正确修正方案 |
|---|---|---|
| 参数位置颠倒 | 在子调用中将 auxiliary 与 target 位置搞错,导致盘子移动路径混乱,违背“大盘不压小盘”规则。 |
谨记口诀:第一步“由源去辅(C作陪)”,第二步“源去目标”,第三步“由辅去终(A作陪)”。 |
| 缺失出口或 n<=1 判定不当 | 缺少 n == 1 或误写成 n == 0 但未处理返回值,引发 RecursionError: maximum recursion depth exceeded。 |
确保在函数开头有确定的 if n == 1: return 基准分支,并对非正整数做防御性退出。 |
| 强行维护全局状态列表 | 试图在递归外部用复杂的栈或列表追踪每根柱子的当前切片,导致逻辑耦合严重,出现越界异常。 | 相信递归定义本身:只要数学证明了三步分解是合法的,直接打印路径即可,无需手工模拟物理堆叠。 |
八、工程扩展:使用生成器(yield)实现流式解法
在实际业务开发中,直接在算法内部 print 是一种典型的反模式,它将计算逻辑与 UI 展示强耦合。如果需要将移动指令交给前端渲染动画或记录至数据库,使用 Python 的 yield 生成器是更优雅、内存开销极小的实现方式:
from typing import Generator, Tuple

def hanoi_generator(n: int, source: str, target: str, auxiliary: str) -> Generator[Tuple[int, str, str], None, None]:
    """
    流式生成汉诺塔移动指令,解耦算法与输出
    :return: 每次 yield 返回 (圆盘编号, 起始柱, 目标柱)
    """
    if n <= 0:
        return
    if n == 1:
        yield (1, source, target)
        return

    # 递归生成子序列
    yield from hanoi_generator(n - 1, source, auxiliary, target)
    yield (n, source, target)
    yield from hanoi_generator(n - 1, auxiliary, target, source)

# 使用示例
if __name__ == "__main__":
    step_count = 0
    for disk, src, dst in hanoi_generator(3, 'A', 'C', 'B'):
        step_count += 1
        print(f"步骤 {step_count}: 移动圆盘 {disk} [{src} -> {dst}]")
借助生成器,调用方可以按需消费移动步骤,甚至随时暂停、回滚动画,真正做到了算法核心与展示逻辑的高内聚、低耦合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















