


Python字符串切片索引越界会报错吗
深入解答Python字符串切片索引越界是否会报错。系统解析单索引访问与切片截取的本质区别、切片自动截断(Clamping)机制、典型越界场景与实际开发防坑指南。
s[i])越界会抛出 IndexError 不同,切片操作(s[start:stop:step])设计有内置的边界自动截断(Clamping)机制,超出字符串长度范围的索引会自动限制到实际合法边界,返回有效子串或空字符串 ""。
许多初学 Python 的开发者在处理文本截取时,常常担心传入过大的下标会导致程序崩溃,从而写出许多多余的 min(len(s), end) 防护代码。本文将从具体现象对比、底层截断原理、常见越界场景以及开发防坑建议四个方面,彻底讲透 Python 字符串切片索引越界的问题。
一、现象对比:单索引报错 vs 切片安全
要理解切片为什么不报错,首先需要明确 Python 中“单元素索引访问”与“区间切片截取”这两种语法的根本差异。
当我们使用单索引访问字符串中某一位置的字符时,Python 执行的是“精确定位”逻辑。若给定的索引不在当前字符串的合法下标范围 [-len, len - 1] 内,Python 无法找到对应的字符,就会立即抛出 IndexError: string index out of range。
# 示例 1:单索引访问越界
s = "Python"  # 长度为 6,合法正索引范围为 0 到 5

# 正常访问
print(s[2])   # 输出: 't'

# 越界访问:抛出异常
print(s[10])  # IndexError: string index out of range
然而,当我们使用切片语法 s[start:stop] 时,Python 执行的是“窗口提取”或“区间相交”语义。切片的含义是:“提取指定区间与当前字符串实际范围相交重叠的那部分内容”。如果指定的区间超出边界,超出部分将被自动截断;如果完全没有重叠,则返回空字符串 "",程序始终平稳运行。
# 示例 2:切片操作越界
s = "Python"

# 右侧越界:截取到末尾,绝不报错
print(repr(s[2:10]))    # 输出: 'thon'

# 左右完全越界:超出整个范围,安全返回空串
print(repr(s[10:20]))   # 输出: ''

# 左侧向左反向越界:自动从开头 0 处截取
print(repr(s[-100:3]))  # 输出: 'Pyt'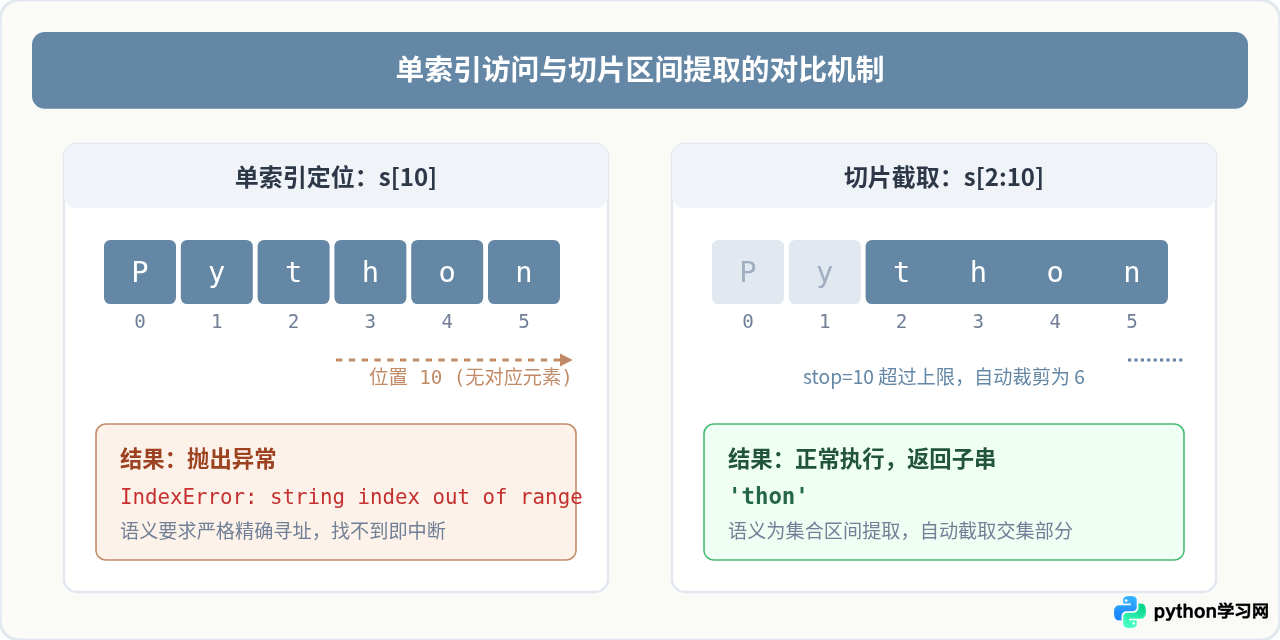
二、底层原理:切片的边界裁剪(Clamping)机制
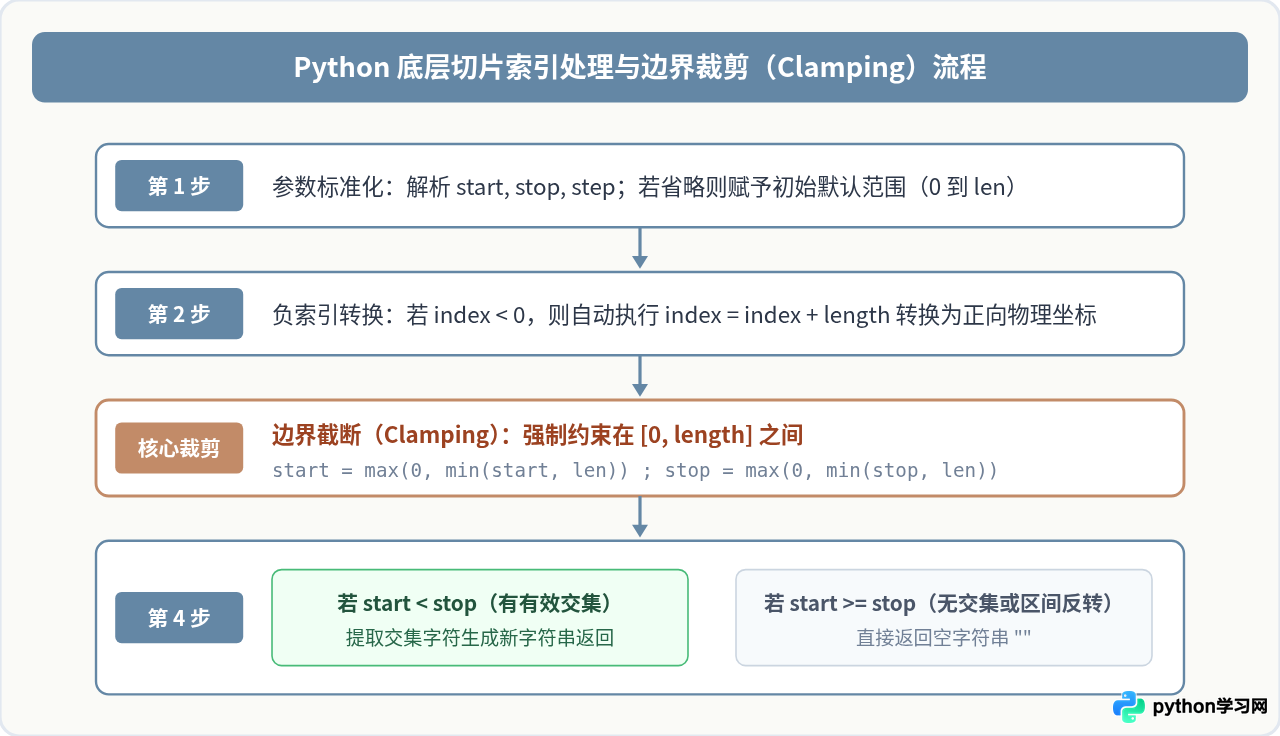
Python 解释器在执行切片时,底层会调用 CPython 核心函数 PySlice_GetIndicesEx(或对应的切片解包逻辑)。该算法会对用户传入的 start、stop 和 step 进行标准化的三步换算:
- 处理默认缺省值:若
step > 0,缺省的start默认为 0,缺省的stop默认为字符串长度length;若step < 0,缺省的start默认为length - 1,缺省的stop默认为-1。 - 负索引换算:如果传入的索引为负数,底层会执行
index = index + length,将其转换为以 0 为起点的非负相对位置。 - 边界收敛截断(Clamping):对于正步长(
step > 0)场景:- 如果计算后的
start < 0,将其截断重置为0;如果start > length,重置为length。 - 如果计算后的
stop < 0,将其截断重置为0;如果stop > length,重置为length。
- 如果计算后的
经过上述裁剪后,实际计算的有效区间必定落在 [0, length] 范围内。若裁剪后满足 start >= stop(步长为正时),循环区间为空,Python 直接构造并返回空字符串 ""。整个过程完全由解释器内置逻辑平滑处理,根本不会产生抛出异常的分支条件。
三、典型切片越界场景与具体表现
在日常编码中,常见的切片越界可以划分为以下四种典型场景:
1. 结束索引(stop)单侧越界
这是最常见的情况。例如当我们只想截取最多 10 个字符,但字符串只有 4 个字符时:
text = "Data"
result = text[0:10]
print(result)  # 输出: "Data"
此时 stop=10 超出了长度 4,底层将其裁剪为 4,效果等价于 text[0:4],安全返回全串内容。
2. 起始索引(start)与结束索引完全超界
当起始下标已经超出字符串总长度时,区间完全无法与字符串产生交集:
text = "Python"
result = text[10:20]
print(repr(result))  # 输出: '' (空字符串)
底层将 start 和 stop 均裁剪为字符串长度 6,此时区间变为 text[6:6],因为满足 start >= stop,直接返回空字符串。
3. 负索引极端反向越界
传入极大的负数索引(如 -999)时,负数转换规则会产生一个远小于 0 的值:
text = "Python"
result = text[-999:4]
print(result)  # 输出: 'Pyth'
-999 + 6 = -993。由于 -993 < 0,底层 Clamping 逻辑会将其重置为 0,因此 text[-999:4] 等价于 text[0:4]。
4. 负步长(逆序)切片的边界推演
当 step < 0 时,切片从右向左移动。此时如果 start 超过右侧边界,会被裁剪为最大有效索引 length - 1;如果 stop 超过左侧,会被约束到有效边界:
text = "ABCDE"
# 从索引 100 逆向切到 -100
print(text[100:-100:-1])  # 输出: 'EDCBA' (等价于整个字符串逆序 text[::-1])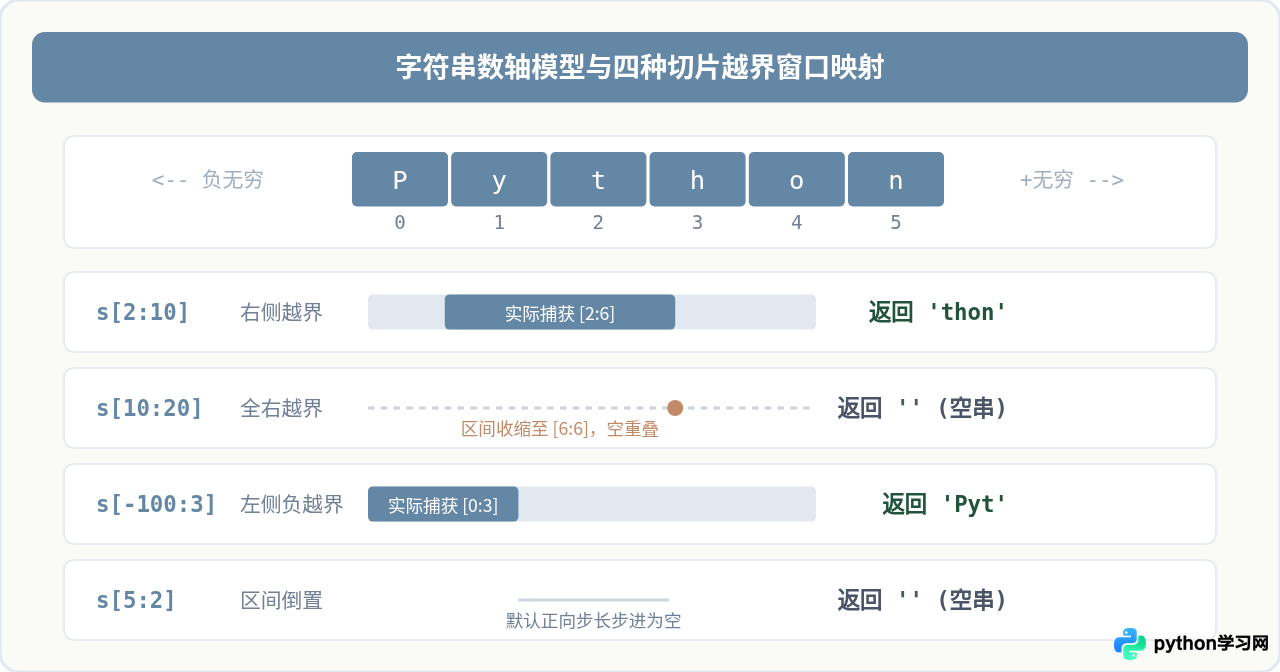
四、开发实践:切片越界的优势与潜在陷阱
切片不报错的特性给日常开发带来了极大的便利,但如果在特定业务场景下理解不当,也可能带来难以排查的“静默故障”。
1. 正确利用特性:编写极简且安全的代码
当你的目标是“尽可能取到指定长度的前缀或后缀”时,直接切片是最优雅的写法,无需任何多余的前置长度校验:
# 推荐做法:直接切片
def get_preview(text, max_len=100):
return text[:max_len] # 即使 text 长度不足 100,也能原样安全返回,无需 if len(text) < max_lenpacket[10:14] 在字段缺失时可能返回 "AB" 甚至是 "",若下游逻辑没有判空,就会带着残缺的数据继续流转。
2. 何时必须进行显式长度检查?
如果业务规则对于“数据长度”或“特定位置字符的存在性”有硬性约束,就绝不能仅依赖切片返回,必须搭配显式检查:
def parse_fixed_code(code_str):
    # 若业务要求必须有至少 6 位编码
    if len(code_str) < 6:
        raise ValueError(f"编码长度不足 6 位,当前为 {len(code_str)} 位")

    # 确认长度足够后,再安全提取对应子串
    return code_str[2:6]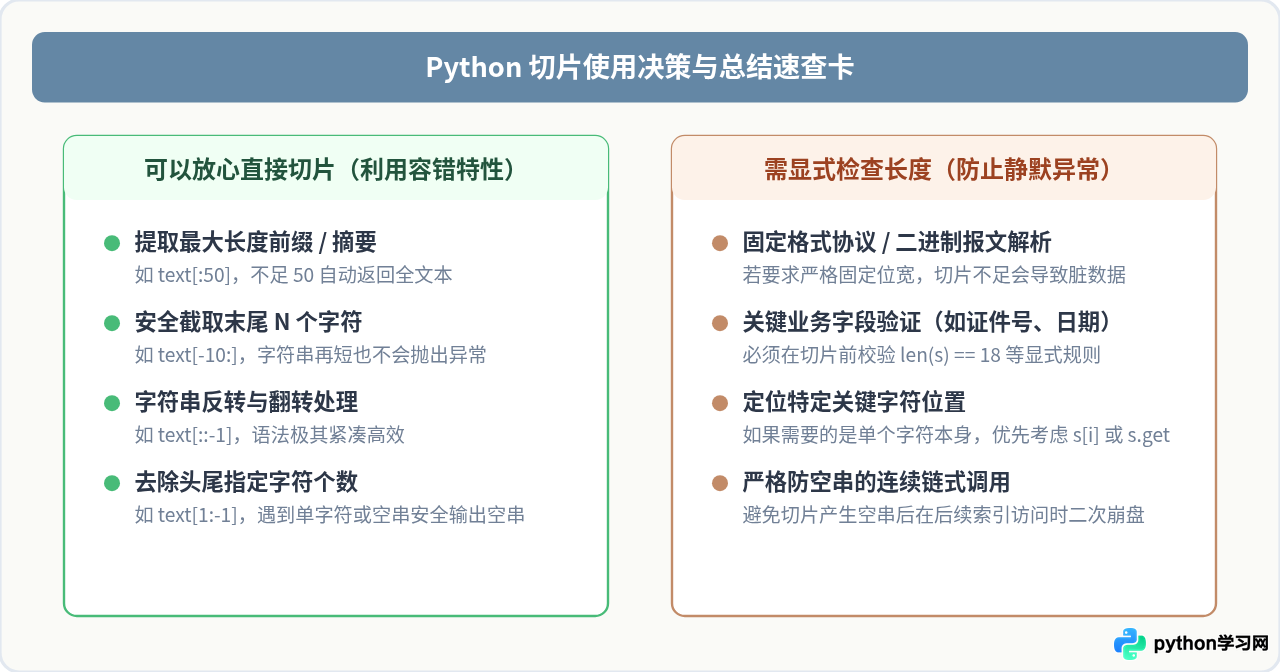
五、总结
回到最初的问题:Python 字符串切片索引越界会报错吗?答案是明确的:不会。
Python 设计哲学的巧妙之处在于区分了“精准访问”与“区间提取”。单索引 s[i] 追求确定性与存在性,越界抛出 IndexError;而切片 s[start:stop] 则追求容错与优雅的交集匹配,借助内置的边界裁剪(Clamping)逻辑保证程序平稳运行。在日常编程中,我们可以放心地利用切片做宽容截取,而在严肃的协议解析场景中,配合显式的 len() 校验,即可兼顾代码的稳健与优雅。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















