


Python遍历字典时怎么控制输出格式和对齐

在写脚本或调试时,经常需要把字典的内容打印出来查看。直接用 print 输出字典,键和值挤在一起,长短不一,很难一眼看出对应关系。假设你有一份存储了服务器信息的字典,键是主机名,值是 IP 地址,五六条记录打出来参差不齐,排查起来相当费眼。这篇文章就来解决这件事:怎样在遍历字典时让输出整齐、易读、格式可控。
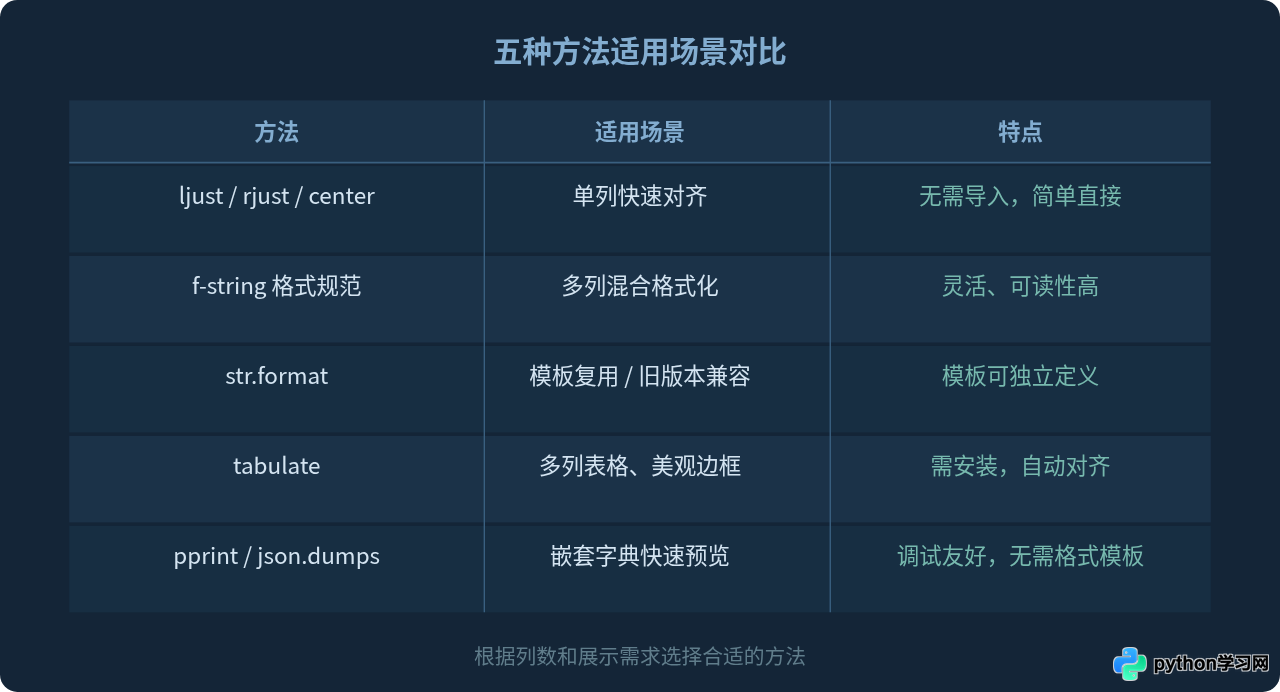
Python 提供了多种方式来控制字符串的对齐和格式,从最基础的字符串方法到 f-string 的格式规范,再到第三方库 tabulate,可以根据场景复杂度选择合适的方案。下面按照由简到繁的顺序依次展开。
直接打印的问题
先看一个常见场景。下面的字典记录了几台服务器的状态信息:
servers = {
    "web-01": "192.168.1.10",
    "database-master": "192.168.1.20",
    "cache": "192.168.1.35",
    "load-balancer-01": "192.168.1.2",
}

for name, ip in servers.items():
    print(name, ip)
输出示例:
web-01 192.168.1.10
database-master 192.168.1.20
cache 192.168.1.35
load-balancer-01 192.168.1.2
键的长度不同,值的列没有对齐,信息量一多就很难快速比对。接下来看怎么解决。
方法一:用字符串的 ljust、rjust、center 对齐
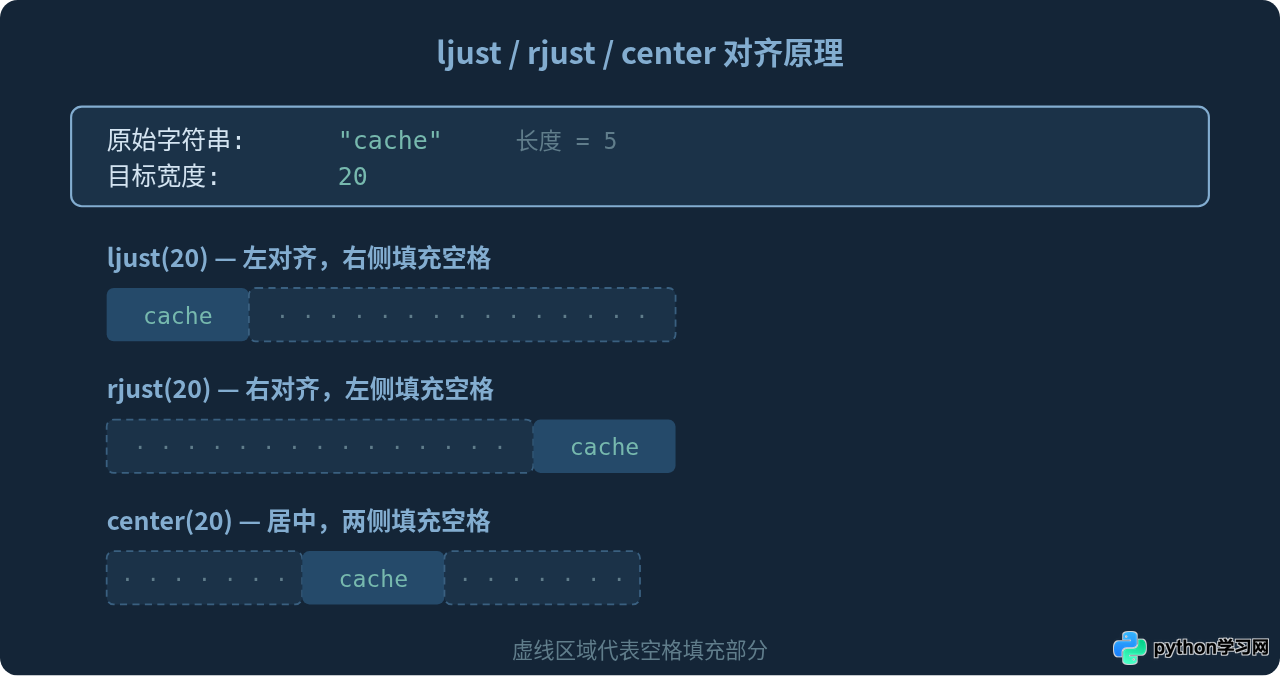
Python 字符串自带三个对齐方法,分别负责左对齐、右对齐和居中对齐。它们的第一个参数是目标宽度,不足的部分用空格(或指定字符)填充。
servers = {
    "web-01": "192.168.1.10",
    "database-master": "192.168.1.20",
    "cache": "192.168.1.35",
    "load-balancer-01": "192.168.1.2",
}

for name, ip in servers.items():
    print(name.ljust(20), ip)
输出示例:
web-01               192.168.1.10
database-master      192.168.1.20
cache                192.168.1.35
load-balancer-01     192.168.1.2
这里 ljust(20) 将键扩展到 20 个字符宽度,不够的右侧补空格。这样值的列就对齐了。如果希望宽度自动适应最长的键,可以先算出最大长度:
max_len = max(len(k) for k in servers)
for name, ip in servers.items():
    print(name.ljust(max_len + 2), ip)
rjust 适合数字列右对齐的场景,center 则用于标题居中。三个方法都支持第二个参数指定填充字符,比如 "5".rjust(4, "0") 得到 "0005"。
方法二:用 f-string 格式规范
Python 3.6 以上可以在 f-string 的花括号内使用格式规范,语法是 {变量:对齐符号宽度}。对齐符号有三种:< 左对齐、> 右对齐、^ 居中。
servers = {
    "web-01": "192.168.1.10",
    "database-master": "192.168.1.20",
    "cache": "192.168.1.35",
    "load-balancer-01": "192.168.1.2",
}

for name, ip in servers.items():
    print(f"{name:<20} {ip:>15}")
输出示例:
web-01               192.168.1.10
database-master      192.168.1.20
cache                192.168.1.35
load-balancer-01       192.168.1.2
这里 {name:<20} 表示左对齐、宽度 20,{ip:>15} 表示右对齐、宽度 15。IP 地址右对齐后,小数点的位置基本统一,更容易比较。宽度也可以用变量指定:
w = max(len(k) for k in servers) + 2
for name, ip in servers.items():
    print(f"{name:<{w}} {ip}")
f-string 还能同时完成类型格式化。比如值是数字时,可以用 {value:>10.2f} 同时控制宽度和小数位数。
方法三:用 str.format 方法
如果需要兼容 Python 3.5 及更早版本,或者想把格式字符串存到变量里复用,可以用 str.format:
template = "{:<20} {:>15}"
for name, ip in servers.items():
    print(template.format(name, ip))
效果和 f-string 完全相同。format 的优势是模板可以提前定义,在循环外只写一次,循环内反复调用。
多列对齐:字典值本身也是字典或元组
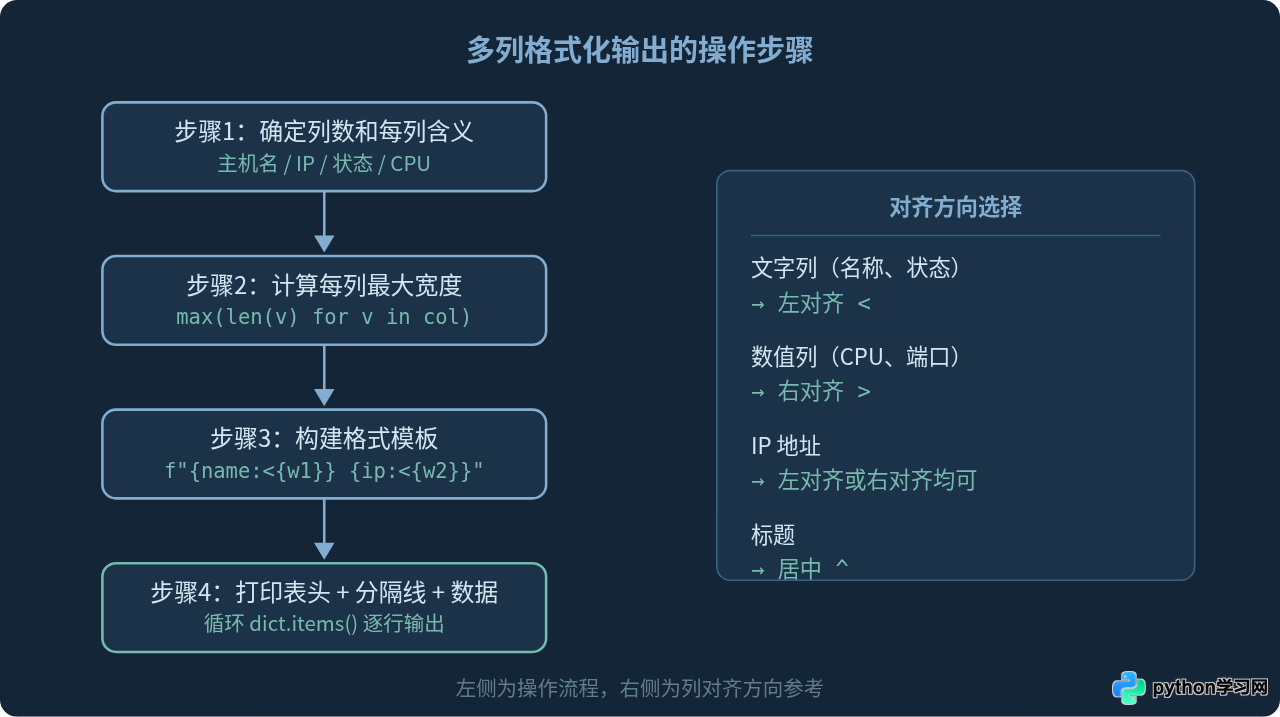
实际项目中,字典的值往往不是单个字符串,而是包含多个字段。比如下面的服务器字典同时记录了 IP、状态和 CPU 使用率:
servers = {
    "web-01":           {"ip": "192.168.1.10", "status": "running", "cpu": 34.5},
    "database-master":  {"ip": "192.168.1.20", "status": "running", "cpu": 78.2},
    "cache":            {"ip": "192.168.1.35", "status": "stopped", "cpu": 0.0},
    "load-balancer-01": {"ip": "192.168.1.2",  "status": "running", "cpu": 12.8},
}

print(f"{'主机名':<20} {'IP地址':<16} {'状态':<10} {'CPU%':>6}")
print("-" * 56)
for name, info in servers.items():
    print(f"{name:<20} {info['ip']:<16} {info['status']:<10} {info['cpu']:>6.1f}")
输出示例:
主机名               IP地址           状态         CPU%
--------------------------------------------------------
web-01               192.168.1.10     running        34.5
database-master      192.168.1.20     running        78.2
cache                192.168.1.35     stopped         0.0
load-balancer-01     192.168.1.2      running        12.8
要点有三个:在循环前先打印表头,让读者知道每列是什么;用分隔线区分表头和数据;数值列右对齐,文字列左对齐。
len() 只算一个。如果表头用了中文,实际对齐效果可能不如预期。可以用 unicodedata.east_asian_width() 判断字符实际宽度,也可以只在表头用英文或手动微调宽度值。
方法四:用 tabulate 库输出表格
当列数较多或需要更美观的边框时,手动拼格式会越来越繁琐。第三方库 tabulate 可以一行代码生成整齐的表格:
# 安装:pip install tabulate
from tabulate import tabulate

servers = {
    "web-01":           {"ip": "192.168.1.10", "status": "running", "cpu": 34.5},
    "database-master":  {"ip": "192.168.1.20", "status": "running", "cpu": 78.2},
    "cache":            {"ip": "192.168.1.35", "status": "stopped", "cpu": 0.0},
    "load-balancer-01": {"ip": "192.168.1.2",  "status": "running", "cpu": 12.8},
}

rows = [[name, info["ip"], info["status"], info["cpu"]]
        for name, info in servers.items()]
print(tabulate(rows, headers=["主机名", "IP地址", "状态", "CPU%"], tablefmt="grid"))
输出示例:
+------------------+---------------+---------+-------+
| 主机名           | IP地址        | 状态    |   CPU% |
+==================+===============+=========+=======+
| web-01           | 192.168.1.10  | running |  34.5 |
+------------------+---------------+---------+-------+
| database-master  | 192.168.1.20  | running |  78.2 |
+------------------+---------------+---------+-------+
| cache            | 192.168.1.35  | stopped |   0   |
+------------------+---------------+---------+-------+
| load-balancer-01 | 192.168.1.2   | running |  12.8 |
+------------------+---------------+---------+-------+
tablefmt 参数可以切换风格,常用值包括 "plain"(无边框)、"simple"(简单线条)、"grid"(完整网格)、"pipe"(Markdown 表格格式)、"github"(GitHub 风格)。tabulate 会自动处理列宽和对齐,数值列默认右对齐,文字列默认左对齐。
方法五:用 pprint 和 json.dumps 快速查看嵌套字典
如果不需要表格形式,只想让嵌套字典的结构清晰可读,pprint 和 json.dumps 是两个快速方案:
import pprint
import json

data = {
    "web-01": {"ip": "192.168.1.10", "status": "running"},
    "cache":  {"ip": "192.168.1.35", "status": "stopped"},
}

# pprint 自动缩进
pprint.pprint(data, width=60)

# json.dumps 输出标准 JSON 缩进格式
print(json.dumps(data, indent=2, ensure_ascii=False))
pprint 的 width 参数控制每行最大宽度,超过时自动换行。json.dumps 的 indent 参数设置缩进层级,ensure_ascii=False 保证中文正常显示。两者都不需要手动拼格式,适合调试阶段快速查看。
格式规范速查:对齐符号与常用格式
f-string 和 format 共用同一套格式规范语法,完整形式是:
{变量:填充字符 对齐符号 宽度.精度 类型}几个常用组合:
{x:<20}— 左对齐,宽度 20,空格填充{x:>10}— 右对齐,宽度 10{x:^15}— 居中,宽度 15{x:*^15}— 居中,宽度 15,用*填充{x:>10.2f}— 右对齐,宽度 10,保留 2 位小数{x:>10,}— 右对齐,宽度 10,千分位逗号{x:0>5}— 右对齐,宽度 5,用0填充(常用于编号)
填充字符默认是空格,可以换成任何单个字符。对齐符号必须紧跟在填充字符后面(如果指定了填充字符)。
实战场景:遍历字典生成对齐的配置报告
把前面的方法组合起来,写一个打印配置报告的函数:
def print_report(config: dict):
    """将字典以对齐的键值对形式打印"""
    if not config:
        print("(空字典)")
        return
    max_key = max(len(str(k)) for k in config)
    print("=" * (max_key + 30))
    print(f"{'配置项':<{max_key + 4}} 值")
    print("-" * (max_key + 30))
    for key, value in config.items():
        key_str = str(key)
        val_str = str(value)
        print(f"{key_str:<{max_key + 4}} {val_str}")
    print("=" * (max_key + 30))

# 使用
app_config = {
    "app_name": "my-service",
    "version": "2.4.1",
    "port": 8080,
    "debug": False,
    "max_connections": 500,
    "log_level": "INFO",
}
print_report(app_config)
输出示例:
==============================================
配置项                    值
----------------------------------------------
app_name                  my-service
version                   2.4.1
port                      8080
debug                     False
max_connections           500
log_level                 INFO
==============================================
这个函数自动计算键的最大长度,所以不管字典内容怎么变化,输出总是对齐的。加上分隔线和表头后,即使在日志文件里也很容易定位。
常见问题
中文和英文混排时对不齐怎么办?
Python 的格式化按字符数计算宽度,但终端显示时中文通常占两个字符位。解决办法是写一个计算显示宽度的辅助函数,用它替代 len() 来决定填充量:
import unicodedata

def display_width(s):
    """计算字符串在终端中的显示宽度"""
    width = 0
    for ch in s:
        eaw = unicodedata.east_asian_width(ch)
        width += 2 if eaw in ("F", "W") else 1
    return width

def pad_to(s, target_width):
    """将字符串填充到指定显示宽度(左对齐)"""
    current = display_width(s)
    return s + " " * max(0, target_width - current)

# 使用
items = {"名称": "主服务器", "IP": "10.0.0.1", "状态": "运行中"}
tw = max(display_width(k) for k in items) + 4
for k, v in items.items():
    print(f"{pad_to(k, tw)} {v}")
字典的遍历顺序可以控制吗?
Python 3.7 以上,字典保持插入顺序。如果需要按键排序后输出,用 sorted() 即可:
for key in sorted(servers):
    print(f"{key:<20} {servers[key]}")
按值排序则需要指定 key 参数,例如按 CPU 降序:
for name, info in sorted(servers.items(), key=lambda x: x[1]["cpu"], reverse=True):
    print(f"{name:<20} {info['cpu']:>6.1f}%")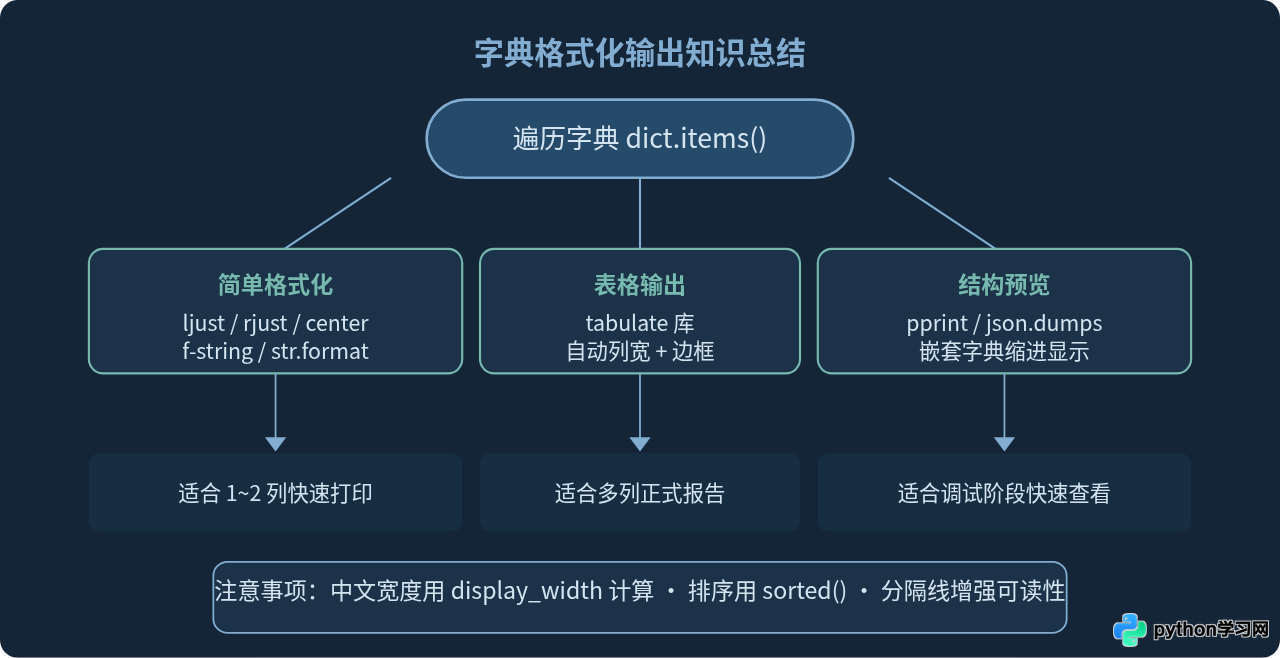
掌握以上几种方法后,无论是简单的键值打印、多列数据表格,还是嵌套结构的快速预览,都可以让字典的输出整齐可读。日常使用中,f-string 格式规范覆盖绝大多数场景,遇到复杂多列需求再引入 tabulate,调试时直接用 pprint 或 json.dumps。根据实际需求选择合适的方式,避免在简单场景引入不必要的复杂度。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















