


Python为什么要用类?类与普通函数的区别及应用场景

很多初学 Python 的开发者在掌握了 def 函数语法后,面对 class 往往会产生困惑:既然函数能解决计算、逻辑分支与数据处理,为什么还要引入语法更繁琐的“类”?答案的核心在于:函数负责表达“动作”与“流动”,而类负责维护“状态”与“实体”。如果你的程序只是接收输入、执行计算并返回输出,普通函数是最简洁高效的选择;但当业务数据需要在多次操作之间持续保持、需要限制修改规则并具备明确身份时,类能将分散的数据与行为紧密聚合,避免全局变量泛滥与数据结构被随意篡改。
一、为什么需要类:从“状态管理困局”说起
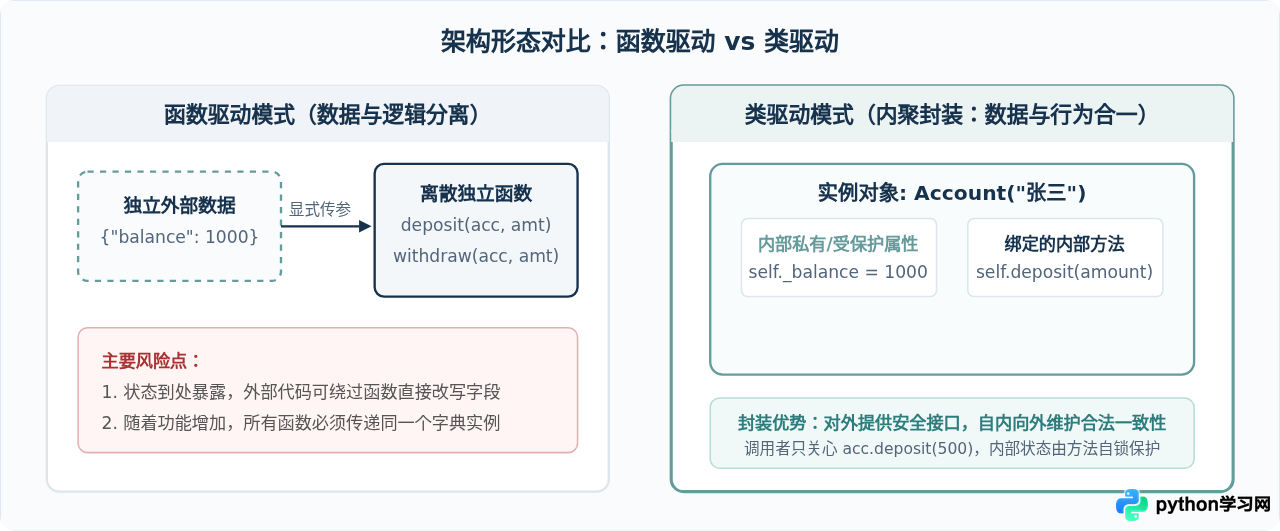
编程中最棘手的问题之一是状态(State)的管理。所谓状态,就是程序运行期间在内存中保留的变量值(例如用户登录信息、银行账户余额、购物车商品列表)。我们先看一个只用普通函数管理银行账户的典型例子:
# 做法一:使用全局变量与普通函数
balance = 1000

def deposit(amount):
    global balance
    if amount > 0:
        balance += amount
    return balance

def withdraw(amount):
    global balance
    if 0 < amount <= balance:
        balance -= amount
return balance这种写法在只有一个账户时尚能运转,但一旦系统需要同时管理张三、李四、王五成千上万个账户,global 变量就彻底失效了。初学者接下来的自然反应是用字典(dict)传递数据:
# 做法二:用字典传递数据,函数处理逻辑
def create_account(name, balance):
    return {"name": name, "balance": balance}

def deposit(account, amount):
    if amount > 0:
        account["balance"] += amount
    return account["balance"]

acc1 = create_account("张三", 1000)
acc2 = create_account("李四", 2000)

deposit(acc1, 500)
# 隐患:外部代码可以毫无约束地破坏数据结构
acc1["balance"] = -999999  # 绕过任何业务校验
acc1["balanse"] = 500 # 拼写错误导致结构损坏,解释器不会立即报错这种模式的问题在于数据与操作数据的函数处于剥离状态。字典只是一个松散的键值容器,任何一段代码都能随意增删改其中的键值;各个函数也必须时刻把 account 作为参数来回传递。当系统规模变大,你很难保证所有修改都经过了合法的检查。
而类(Class)正是为解决这一困局而生:它把数据(属性)和处理该数据的函数(方法)打包进同一个密闭单元,由实体自己负责维护自身的完整性。
二、从普通函数到类的推导步骤:代码的自然演进
为了让理解更具体,我们以一个“下载任务调度器”为例,看一下代码是如何从普通函数一步步被“逼”成类的。这个推导过程揭示了类的真正成因。
步骤一:单函数与多参数爆炸
最初,我们只需要一个函数下载文件:
import time

def download(url, retry=3, timeout=10):
    print(f"正在从 {url} 下载数据(重试次数:{retry},超时:{timeout}s)...")
    time.sleep(0.5)
    return "文件内容"
当需求增加时,我们需要统计该任务的已下载大小、耗时、状态,并在失败时暂停重试。此时函数参数开始迅速膨胀,调用方每次调用都必须带上一大堆状态参数。
步骤二:用字典打包数据(结构仍然脆弱)
def create_task(url):
    return {"url": url, "progress": 0, "status": "pending", "retry_count": 0}

def step_download(task, chunk_size):
    task["progress"] += chunk_size
    task["status"] = "running"
    if task["progress"] >= 100:
task["status"] = "finished"这缓解了参数过长的问题,但带来新的隐患:task 字典没有任何类型约束和保护屏障。别的模块代码可能手误写出 task["statu"] = "done",直到几小时后业务崩溃,你才会在日志里艰难排查为什么状态不是 finished。
步骤三:提取为类,实现“数据与行为绑定”
class DownloadTask:
    def __init__(self, url, max_retries=3):
        self.url = url
        self.max_retries = max_retries
        self.progress = 0
        self.status = "pending"
        self._retry_count = 0

    def step(self, chunk_size):
        """执行单步下载并安全自增进度"""
        if self.status == "finished":
            return
        self.progress += chunk_size
        self.status = "running"
        if self.progress >= 100:
            self.progress = 100
            self.status = "finished"

    def retry(self):
        """受控的重试逻辑"""
        if self._retry_count < self.max_retries:
            self._retry_count += 1
            self.status = "retrying"
            return True
        self.status = "failed"
        return False

# 外部调用变得清晰自然且安全
task = DownloadTask("https://example.com/data.zip")
task.step(40)
print(task.progress, task.status)  # 40 running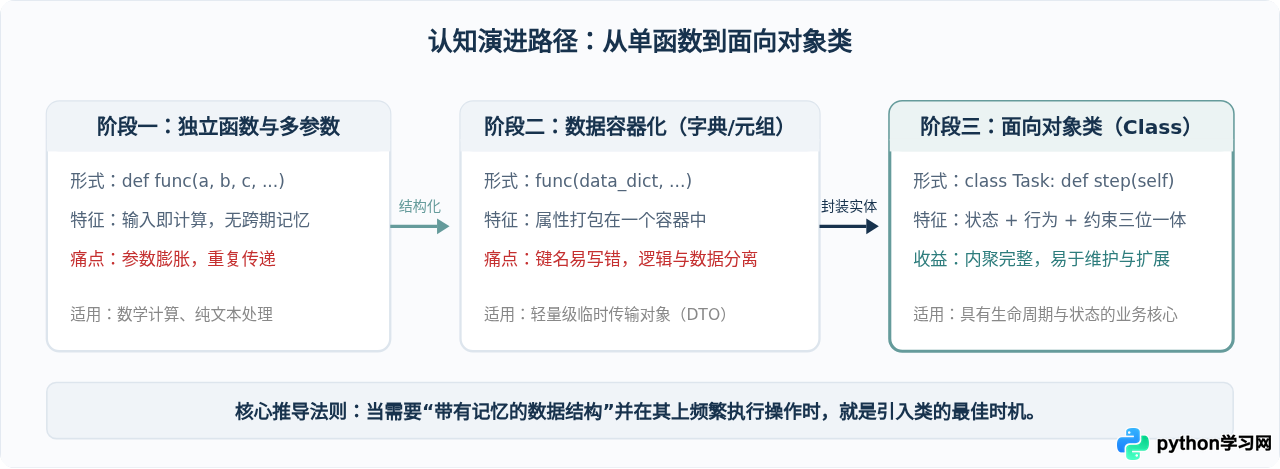
三、类与普通函数的核心区别:全维度对照
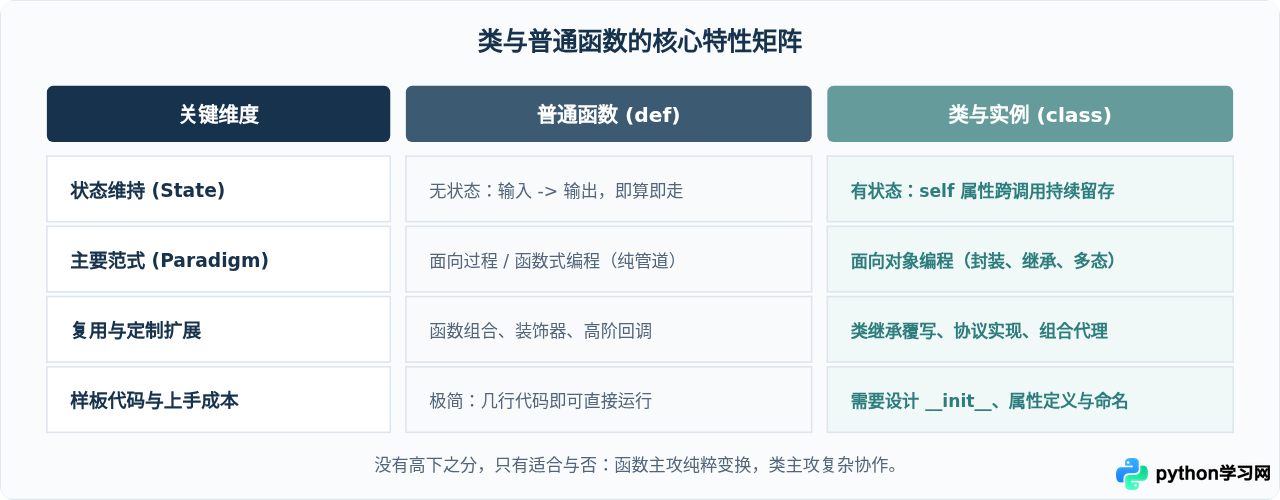
为了在实际写代码时不纠结,我们需要从底层机制与工程设计两个维度理清两者的本质差异:
| 对比维度 | 普通函数(Function) | 类与实例(Class & Instance) | 工程决策指导 |
|---|---|---|---|
| 本质定位 | 操作过程、动作指令、数据管道 | 实体模板、状态容器、数据与行为的集合 | “做某件事”选函数,“代表某个东西”选类 |
| 状态保留(State) | 无状态(Stateless)。每次调用相互独立,执行完毕局部变量即销毁 | 有状态(Stateful)。通过 self 在内存中持久驻留专属数据 |
如果下次操作依赖上次操作的结果,优先考虑类 |
| 调用方式 | result = func(x, y) |
obj = MyClass()result = obj.method() |
类多了实例化这一环节,提供专属命名空间隔离 |
| 代码复用与扩展 | 通过函数嵌套、高阶函数、管道组合(Composition) | 通过继承(Inheritance)、多态(Polymorphism)、对象组合 | 函数复用偏向“变换流”;类复用偏向“结构重用”与“定制覆写” |
| 内存与执行开销 | 极低,函数对象全局唯一定义,执行栈随用随清 | 每次实例化都会分配新对象内存与属性字典(__dict__) |
高并发超轻量任务不要滥用未优化的重型类 |
| 测试与维护 | 纯函数单元测试极为容易,输入相同则输出必定相同 | 测试时需要构造特定初始状态,依赖上下文 | 核心数学计算与文本转换尽可能写成纯函数 |
四、实际应用场景:什么时候用函数,什么时候用类?
很多开发者在学完面向对象后,容易走向极端——不管什么功能都必须套个 class。这在 Python 社区中被称为“Java 风格后遗症”。Python 是一门多范式语言,选择的关键在于场景特征:
1. 坚决使用普通函数的典型场景
- 纯数学计算与算法处理:例如计算两点距离、校验身份证格式、哈希字符串。输入确定,输出唯一,内部绝无副作用。
def calculate_distance(x1, y1, x2, y2): return ((x2 - x1) ** 2 + (y2 - y1) ** 2) ** 0.5 - 独立数据流转换管道(ETL):从 CSV 读取数据、清洗字段、输出 JSON。每个环节都是一个接收数据并返回新数据的独立函数,非常易于串联和写单元测试。
- 一次性小脚本或 CLI 入口:只有几十行逻辑的自动化脚本,写函数清晰直白,不需要画蛇添足地写一个只调用一次的类。
2. 应当果断使用类的典型场景
- 管理具有生命周期的外部资源:例如数据库连接池、网络通信会话(Session)。连接需要初始化(
__init__)、维持心跳状态、执行查询,最后释放断开(__enter__/__exit__)。class DatabaseClient: def __init__(self, host, port): self.host = host self.port = port self.connection = None def connect(self): self.connection = f"Connected to {self.host}:{self.port}" def query(self, sql): if not self.connection: raise RuntimeError("请先连接数据库!") return f"Result of {sql}" def close(self): self.connection = None - GUI 桌面或游戏实体开发:按钮、窗口、玩家角色、怪物,每个实体都有坐标(x, y)、血量、皮肤属性,以及点击、移动、受击等方法。
- 通过多态(Polymorphism)消除大量 if-else 分支:比如对接微信支付、支付宝支付、PayPal 支付。定义统一的基类接口,各平台子类分别实现自己的
pay()方法,调用方完全无需关心具体实现细节。
警惕反模式:只有一个方法的“伪类”
如果在代码中看到类似下面的结构,说明过度设计了:
# 糟糕的写法:除了 __init__ 外只有一个方法的类
class StringFormatter:
    def __init__(self, prefix):
        self.prefix = prefix
    def format(self, text):
        return f"{self.prefix}: {text}"

# 优雅的 Python 风格:直接使用函数或闭包/偏函数
def format_string(text, prefix="INFO"):
    return f"{prefix}: {text}"
在 Python 中,如果一个类内部既没有复杂状态演变,也没有多个方法相互协作,那么它几乎总是应该被重构为一个简单的普通函数。
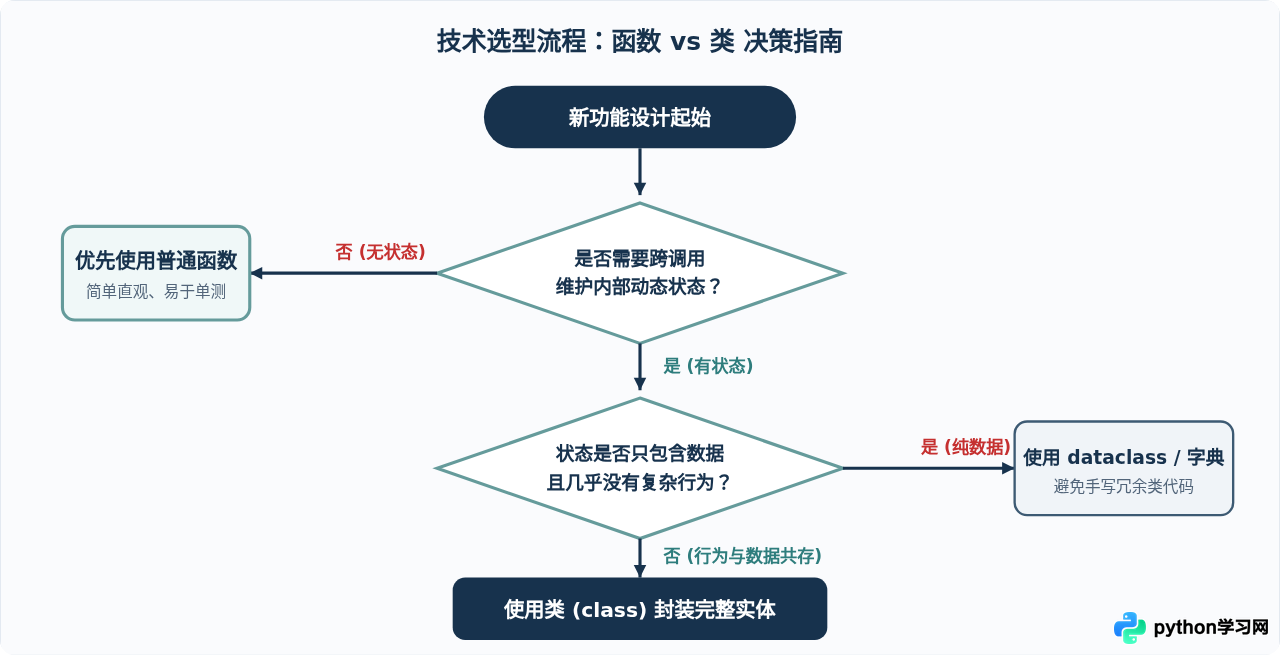
五、技术选型决策树
当你拿到一个具体的开发需求,在敲下第一行代码前,可以通过下图的选型路径进行快速判断:
六、总结:编写清晰代码的平衡艺术
在 Python 的世界里,函数与类并不是替代关系,而是相辅相成的两件利器:
- 动词优先考虑函数:当逻辑的核心在于“变换”或“处理”时(如
filter_users()、parse_json()),普通函数最轻巧也最诚实。 - 名词优先考虑类:当逻辑的核心在于“实体”与“归属”时(如
User、DatabaseConnection、OrderSession),类能把散落的属性聚拢在命名空间内,让业务边界变得坚固可靠。
掌握这种权衡,不盲目套用面向对象设计模式,也不一味拒绝封装带来的秩序感,才能写出真正符合 Pythonic 精神、优雅且易于长期维护的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















