


Python正则表达式最简单的三个步骤:定义、匹配与提取

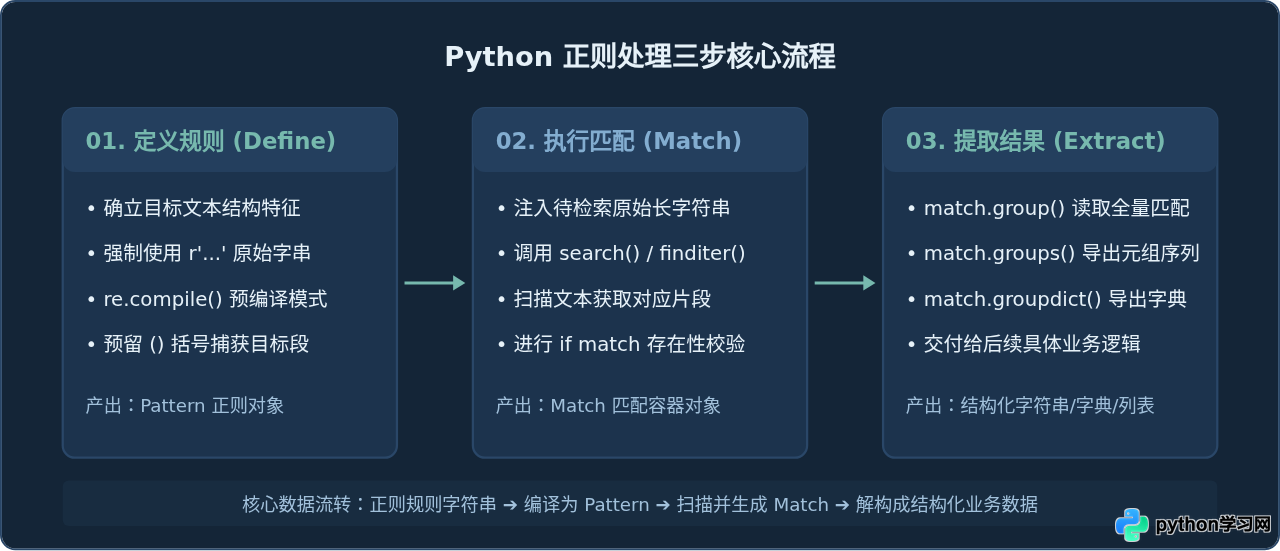
在日常文本处理中,我们经常遇到需要从杂乱字符中筛选目标信息的场景:例如从服务器访问日志中分离请求 IP 与响应耗时,或者从一段用户填写的地址中抽离出手机号码与邮政编码。许多刚接触 Python re 模块的开发者常常被繁复的符号和密密麻麻的 API 困扰,但实际上,不论文本多复杂,使用 Python 处理正则表达式的标准流程永远只有清晰的三个步骤:定义规则、执行匹配与提取结果。理清这条主线后,正则处理就会变成一条标准的装配流水线。
一、核心思路:理清正则处理的“流水线”逻辑
很多代码之所以混乱且难以排错,是因为开发者试图在同一行代码里同时完成模式构建、数据查找与字段截取。在 Python 官方标准库 re 中,合理的分工让各阶段的职责非常明确:第一步规划你要找的模式,第二步将模式应用于真实文本并取得匹配对象,第三步从匹配对象中按需解构出干净的数据。
二、第一步:定义规则(Pattern 与原始字符串)
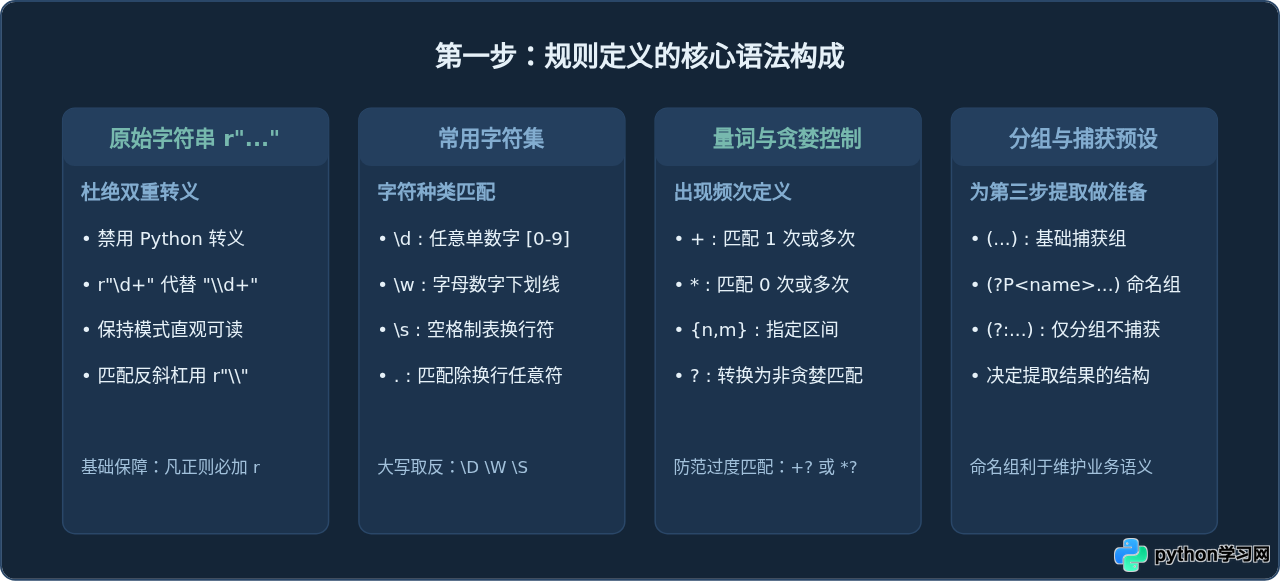
定义规则的目的,是告诉 Python 解释器“我要找的内容长什么样”。在这一步中,核心任务有两个:使用原始字符串(Raw String)书写模式,以及使用括号划定未来需要抽取的关键字段。
1. 为什么必须加 r 前缀
在普通 Python 字符串中,反斜杠 \ 是转义符(例如 \n 代表换行)。而正则表达式中同样大量使用反斜杠表示特殊字符集(例如 \d 代表数字)。如果不加 r 前缀,Python 解释器会先尝试转义一次,导致传递给底层正则引擎的内容发生形变,甚至报错。加上 r(例如 r"\d+")可以关闭 Python 本身的字符串转义,让反斜杠原封不动传递给正则引擎。
2. 使用 re.compile() 预编译
虽然 re.search(r"...", text) 也可以工作,但在正规开发中,建议优先使用 re.compile() 生成预编译对象。预编译有两个直接好处:首先,若在循环或高频函数中处理多行文本,预编译可以避免重复解析规则的开销;其次,它将“规则设计”与“数据执行”在代码结构上彻底拆开,方便单独对规则进行单元测试与维护。
下面是一个标准的规则定义示例:我们希望从一段订单描述中抽取订单编号(6 位数字)与金额(浮点数字)。
import re

# 第一步:定义规则
# 使用 r 前缀,并通过 (?P<name>...) 定义命名捕获组
pattern = re.compile(r"订单号:\s*(?P<order_id>\d{6})\s*金额:\s*(?P<amount>\d+\.\d{2})元")
三、第二步:执行匹配(检索定位与获取 Match 对象)
规则定义完毕后,第二步是将规则放入待处理的字符串中执行。在执行匹配时,开发者最常踩的坑是对匹配函数的选用不当,以及遗漏空值检查。
1. 常用匹配方法的选择依据
re 模块提供了几个看似相近的匹配方法,其应用场景差异十分明确:
re.search():在整段文本中从左往右扫描,找到第一处满足条件的片段就立即停止并返回。最适合在长文本中定位单一目标。re.match():严格只从文本的第一个字符开始对齐,如果开头不满足就直接宣告失败。通常用于格式校验(如判断输入是否是合法的手机号格式)。re.finditer():遍历整段文本,找到所有匹配片段,并以迭代器形式逐个返回Match对象。在需要逐行处理大文本且内存受限时最为推荐。
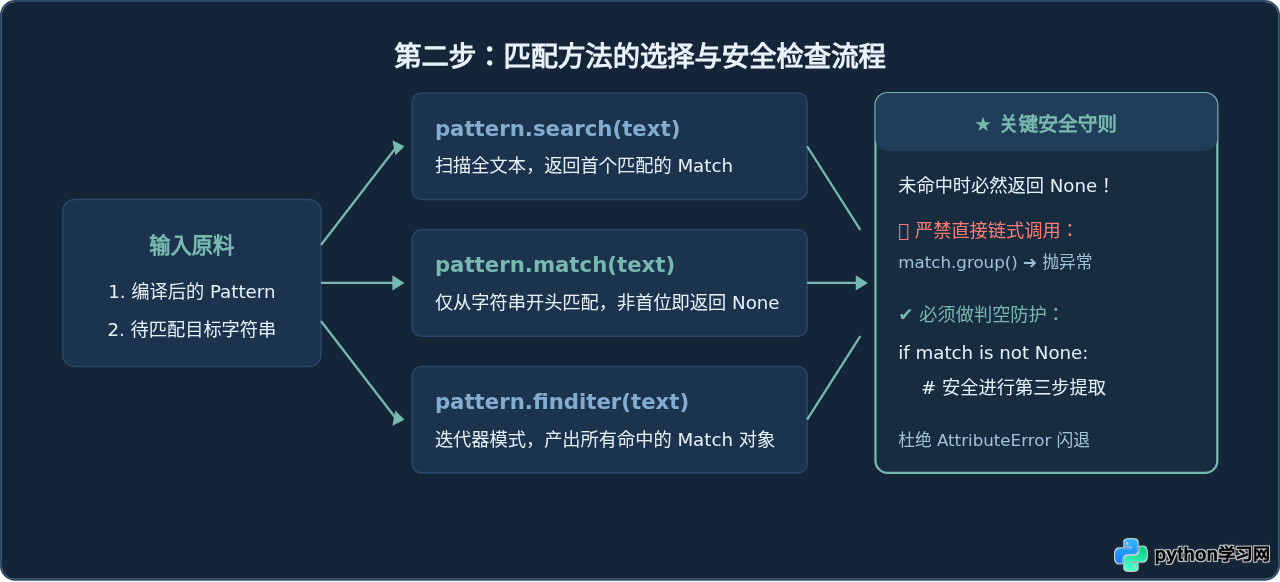
高频避坑提醒:re.search() 和 re.match() 一旦没有在字符串中找到符合的内容,返回值是 Python 的 None。如果此时直接写 re.search(...).group(1),程序会立刻抛出 AttributeError: 'NoneType' object has no attribute 'group'。因此,任何健壮的代码在执行匹配后,都必须显式执行 if match: 校验。
承接第一步定义的模式,执行匹配的代码如下:
raw_text = "通知:用户张三于昨日完成支付,订单号: 839201 金额: 129.50元,请仓库及时发货。"

# 第二步:执行匹配
match_result = pattern.search(raw_text)

# 必须先确认匹配成功,再进入提取
if match_result is None:
    print("未能从文本中匹配到符合规范的订单数据")
    # 执行对应的告警或兜底逻辑
四、第三步:提取结果(从捕获组到结构化数据)
只要确认第二步获取到了合法的 Match 对象,我们就可以进入最后一步:把文本碎片提取出来,转换为 Python 能够直接计算和存储的数据类型。
1. 提取的几种常规姿势
match.group()或match.group(0):返回整条正则表达式命中的完整文本片段。match.group(1),match.group(2):按圆括号从左往右出现的顺序,依次提取第 1、第 2 个捕获组。match.groups():将所有捕获组的内容组装为一个tuple(元组)一次性返回,适合解构赋值。match.groupdict():将所有命名捕获组(?P<name>...)以dict(字典)形式返回。这是生产环境中最推荐的做法,因为基于键名提取字段不仅易读,而且未来调整正则中字段的前后顺序时,提取逻辑完全无需修改。
2. 三步法完整实战串联
我们把定义、匹配、提取整合为一个端到端的实际案例:从一段服务器 Nginx 风格的访问日志中解析出访问者 IP、HTTP 请求动作、访问路径和状态码。
import re

# 假定从日志文件读取到的一行数据
log_line = '192.168.1.105 - - [20/Oct/2026:14:28:10] "POST /api/v1/checkout HTTP/1.1" 200 4096'

# 【第 1 步:定义规则】
# 使用命名捕获组明确各字段含义,提高后续业务代码可读性
log_pattern = re.compile(
    r'(?P<client_ip>\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3})\s+-\s+-\s+'
    r'\[(?P<access_time>[^\]]+)\]\s+'
    r'"(?P<method>GET|POST|PUT|DELETE)\s+(?P<path>/[^\s]*)\s+HTTP/[0-9.]+"\s+'
    r'(?P<status_code>\d{3})'
)

# 【第 2 步:执行匹配】
match = log_pattern.search(log_line)

# 【第 3 步:提取结果】
if match:
    # 直接提取成字典结构
    record = match.groupdict()
    print("提取成功,解析结果如下:")
    print(f"客户端 IP : {record['client_ip']}")
    print(f"请求时间   : {record['access_time']}")
    print(f"请求方法   : {record['method']}")
    print(f"访问路径   : {record['path']}")
    print(f"HTTP状态码 : {int(record['status_code'])}")
else:
    print("日志格式不符合规范,匹配失败")
通过这种三步切分,代码结构井井有条:第一部分负责严密的规则设计,第二部分负责安全的搜索定位,第三部分则以标准的字典输出直接对接数据库入库或统计分析模块。
五、全文核心总结与避坑速查
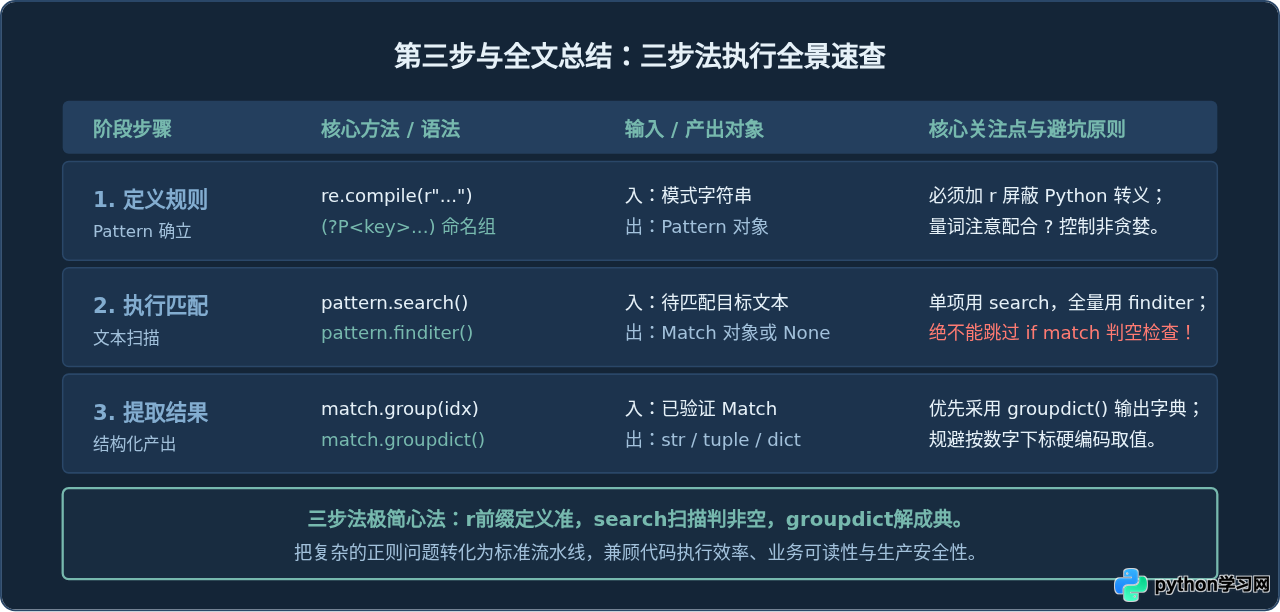
只要读者在以后的开发中坚持“定义规则 ➔ 执行匹配 ➔ 提取结果”这条三步法主线,正则表达式就不再是一团混乱的符号,而是一个输入明确、过程可控的数据加工工具。
实战避坑三原则
- 严禁省略
r前缀:无论正则是否包含\,统一加上r"...",彻底杜绝转义解析不一致的问题。 - 严禁未判空直接提取:牢记
search()与match()在未命中时返回None,提取前务必执行if match:保护分支。 - 多字段提取优先使用命名捕获组:用
(?P<name>...)代替纯括号(...),提取阶段使用.groupdict(),让代码脱离脆弱的数组下标索引,直接对接业务逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















