


为什么大型网站选择Python做后端?

一、认知误区:语言运行速度决定网站规模吗?
在讨论技术选型时,常有开发者将语言的基准测试吞吐量等同于大型网站的支撑上限。常见的疑问是:Python 具有全局解释器锁(GIL),且属于动态解释型语言,单核 CPU 计算速度明显低于 C++、Go 或 Java,为什么 Instagram、YouTube、Reddit、Pinterest、Dropbox 等数亿级月活用户的大型平台仍然重度依赖 Python?
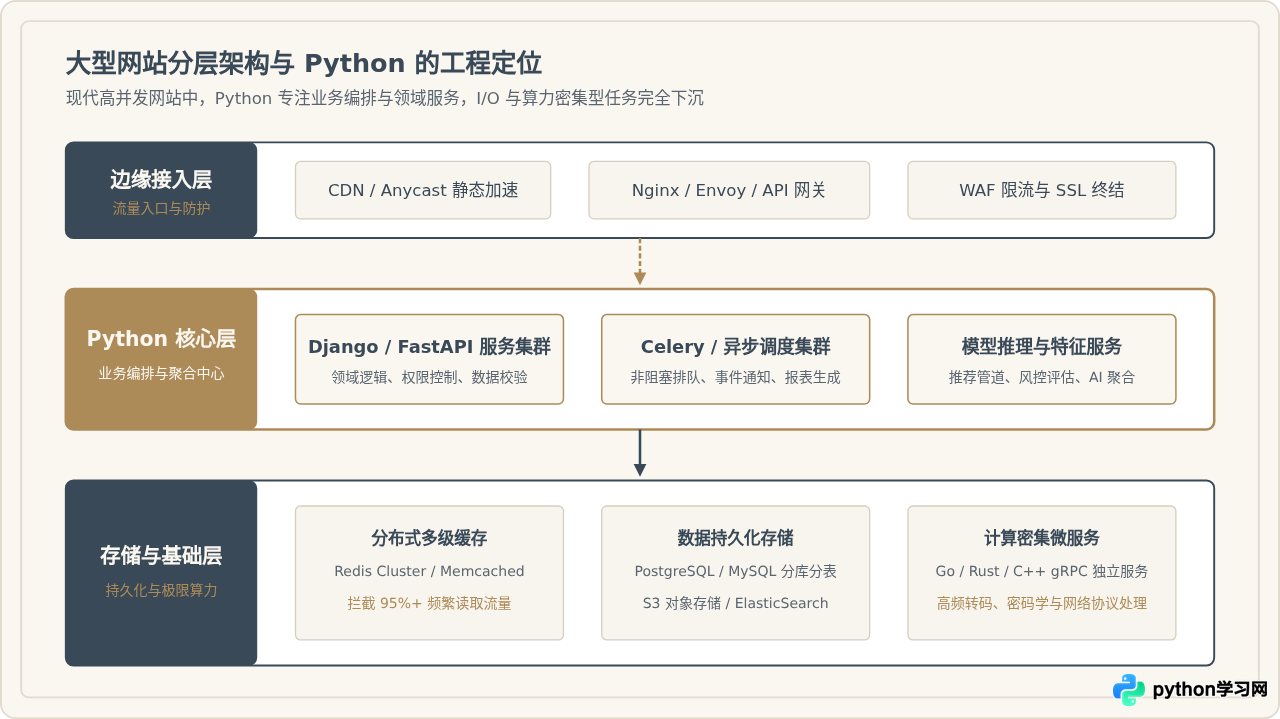
要解答这个问题,必须先还原现代大型网站后端的真实耗时结构。在一个典型的分布式 Web 请求链路中,用户请求依次经过 CDN、全局负载均衡器(Nginx / Envoy)、API 网关到达后端业务应用。在应用处理期间,系统耗时主要分布在:
- 网络 I/O 往返:跨机房数据同步、内部 RPC 调用、第三方接口交互(通常耗时 5ms 至 50ms)。
- 存储层 I/O 读写:分布式缓存 Redis 查询(0.5ms 至 2ms)、关系型数据库或文档存储磁盘与索引扫描(5ms 至 30ms)。
- 序列化与数据组装:JSON / Protobuf 解析与字段转换(通常仅占 0.5ms 至 2ms)。
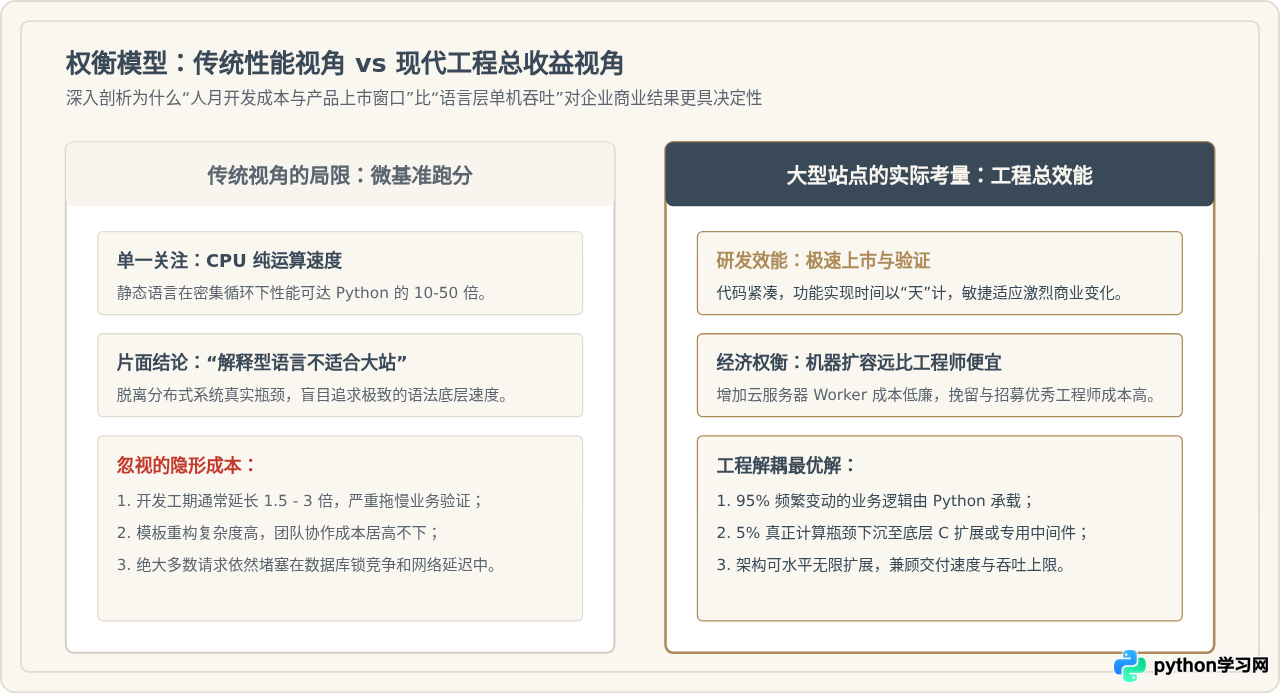
可以看到,整个请求生命周期中 90% 以上的时间消耗在 I/O 等待上,CPU 执行解释器指令的时间往往只占毫秒甚至微秒级。通过单纯更换语言将语言层的 2ms 缩短到 0.5ms,对整体 40ms 的请求延迟影响极小,却可能带来开发周期倍增、调试难度上升与团队协作成本激增。
二、核心驱动力:大型网站选择 Python 的关键工程收益
对于需要快速响应市场竞争的大型互联网业务而言,系统能否活到“需要承受亿级流量”的那一天,取决于初期的研发交付效率;而在业务规模扩张后,系统能否维持低缺陷率与低维护成本,取决于代码表达的清晰度与框架生态的成熟度。
1. 工程师生产力与开发速度的绝对优势
软件工程中著名的“布鲁克斯法则”指出:增加人力并不一定能线性缩短工期,因为人员间的沟通成本以二次方增长。Python 具备接近伪代码的简洁语法与强大的自省机制,这使得团队能够用更少的人力、编写更少的代码行数实现相同的商业逻辑。
在大型分布式团队中,代码阅读与交接的频次远高于代码编写。Python 强制缩进、语法明晰、不依赖复杂的模板元编程或过度抽象的设计模式,显著降低了新成员的接手门槛,大幅减少了由于隐式类型转换或晦涩指针操作带来的缺陷。
2. 经过工业规模验证的成熟 Web 生态
以 Django、Flask 与新兴的 FastAPI 为代表的 Python 框架,历经数十年的大规模实战检验,提供了开箱即用的工业级能力:
- 确定性的 ORM 与迁移系统:Django ORM 提供了极其健壮的数据库 Schema 自动化版本迁移管理,避免大型团队多人协作时出现数据库结构混乱。
- 内建安全防御:默认抵御常见的 Web 攻击向量,包括 SQL 注入、跨站脚本(XSS)、跨站请求伪造(CSRF)与点击劫持。
- 丰富的集成生态:从任务调度(Celery、Huey)、系统监控(Sentry、Prometheus Client)到服务注册发现,均有极其成熟的开源组件。
3. AI、数据科学与业务后端的同构一体化
现代大型网站(如短视频、社交、电商平台)的核心盈利模式越来越依赖于个性化推荐、风险控制与智能搜索。Python 在人工智能与数据分析领域拥有垄断地位(PyTorch、TensorFlow、Scikit-learn、Pandas、Polars)。
如果后端业务系统同样采用 Python 构建,算法工程师训练出的模型、特征工程逻辑能够与 Web 后端工程无缝协同,消除了在离线训练阶段(Python)与在线服务阶段(如 C++ 或 Java)之间反复对齐数据解析逻辑的转换成本。
三、架构实践:大型网站如何化解 Python 的性能挑战?
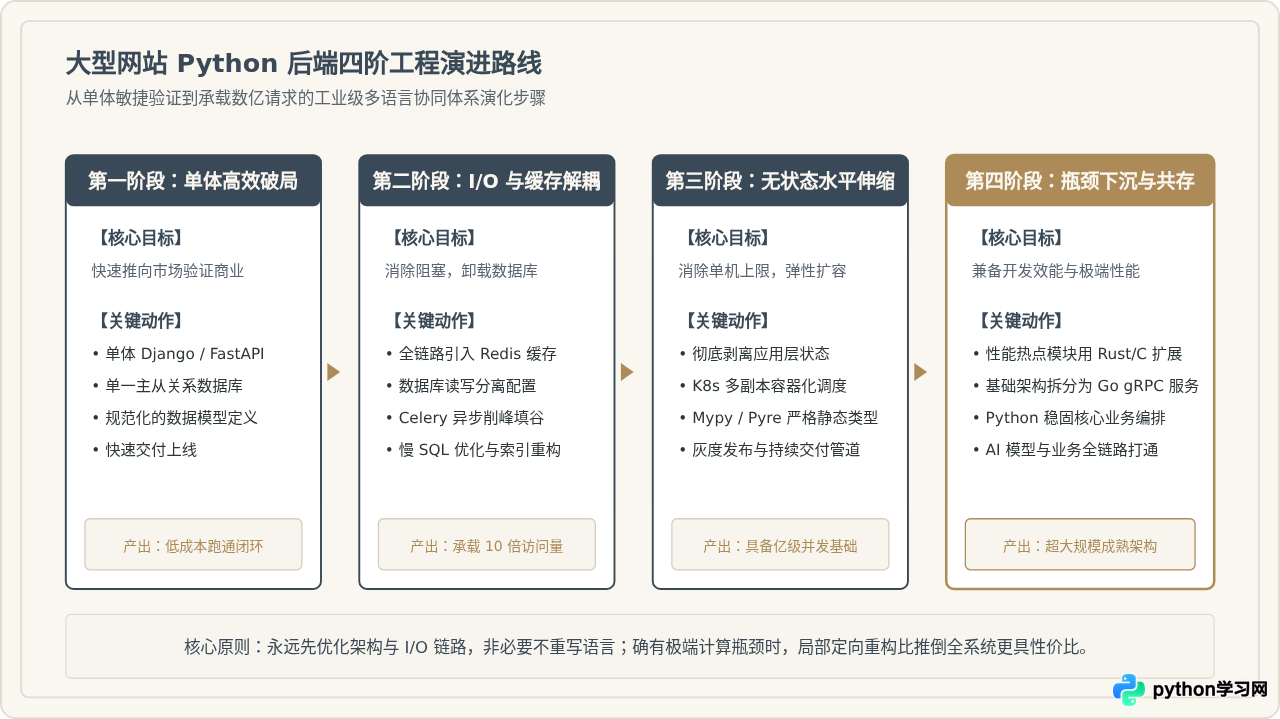
在系统访问量呈指数级增长时,单纯依靠 Python 单机执行显然无法应对海量请求。大型网站能够长期稳定运行在 Python 之上,依赖于一套高度成熟且标准化的系统工程演进路径。
步骤 1:构建纯无状态计算层(Stateless Web Workers)
由于 Python 原生存在 GIL,单进程无法充分利用多核 CPU。大型网站的标准做法是**彻底剥离应用层状态**:
- 所有用户 Session、登录态、临时缓存均存入高可用 Redis 集群。
- 采用 Gunicorn、uWSGI 或 ASGI 容器(如 Uvicorn),以多进程并发(Process-based concurrency)运行实例,进程数根据 CPU 核心数按
(2 * 核心数) + 1严格配置。 - 在容器编排层(Kubernetes)中运行数十至数千个完全平等的 Pod 副本,上游通过负载均衡器分发流量,需要扩容时只需调整副本数量。
步骤 2:异步并发与非阻塞 I/O 架构
对于涉及长轮询、实时通知或大量并发下游调用(如微服务聚合接口)的场景,传统同步阻塞模型会导致工作进程被迅速耗尽。
现代 Python 通过 async / await 语法与事件循环驱动(基于 uvloop,由 libuv 实现的高性能事件循环库),实现单进程承载上万并发连接:
import asyncio
import httpx
from fastapi import FastAPI

app = FastAPI()

@app.get("/api/v1/user-dashboard/{user_id}")
async def get_user_dashboard(user_id: str):
    """
    异步并发向三个内部微服务发起调用
    总耗时等于耗时最长的单个下游接口,而非线性相加
    """
    async with httpx.AsyncClient(timeout=2.0) as client:
        profile_task = client.get(f"http://user-service/profile/{user_id}")
        orders_task = client.get(f"http://order-service/orders/{user_id}")
        recommend_task = client.get(f"http://recommend-service/feed/{user_id}")

        profile_res, orders_res, recommend_res = await asyncio.gather(
            profile_task, orders_task, recommend_task, return_exceptions=True
        )

    return {
        "user_id": user_id,
        "profile": profile_res.json() if hasattr(profile_res, 'json') else None,
        "orders": orders_res.json() if hasattr(orders_res, 'json') else [],
        "feeds": recommend_res.json() if hasattr(recommend_res, 'json') else []
}工程注意点:异步代码严禁在协程函数中混入耗时过长的同步阻塞调用(如大文件读写、密文散列计算),否则会锁住当前进程的整个事件循环。CPU 密集任务必须丢入 run_in_executor 线程池或 Celery 异步队列。
步骤 3:数据访问层的主从分离与多级缓存体系
大型网站将 95% 以上的高频读取流量通过缓存解决。Python 框架通过配置多数据库路由与缓存装饰器,保证写请求发往主库(Primary),高并发读请求分散至多个只读副本库(Read Replicas),且热点数据直接在 Redis 或本地进程缓存(LRU Cache)命中返回,数据库层面几乎不承受高并发点查压力。
步骤 4:核心瓶颈定向下沉(80/20 法则落地)
对于特定计算密集型逻辑(例如高频图像缩放、音视频切片、超大尺寸 JSON 解析、密码哈希计算),大型网站遵循“Python 编排,下沉执行”的策略:
- 使用底层由 C/C++ 编写的高性能第三方库(如
orjson代替标准库json,解析提速 5-10 倍;使用Pillow-SIMD进行硬件级图像处理)。 - 对于专属业务算法,通过 Cython、C 扩展或 Rust(通过 PyO3 绑定)重写核心循环,性能直接达到原生机器码级别,而对外接口依然保持 Python 优雅调用。
- 若模块边界清晰,直接拆分为独立的 Go 或 Rust gRPC 微服务。
四、行业标杆:头部网站的真实 Python 实践
考察技术选型的生命力,最客观的标准是观察处于全球流量顶端的企业如何应对实际挑战。
1. Instagram:全球最大规模的 Django 实践者
Instagram 从数名工程师创立初期到如今服务数十亿月活用户,始终维持着由 Python / Django 驱动的庞大单体(Monolith)架构。Instagram 技术团队曾在官方技术博客中明确指出:
- 生产力至上:他们坚信“工具的最大价值在于让工程师最快把创意变成线上服务”。Python 让他们仅用极精简的工程团队就支撑了现象级增长。
- 禁用 Python 垃圾回收(GC 优化):Instagram 曾公布过一项著名的内存优化方案——由于他们的多进程 Worker 采用 Pre-fork 机制,为了最大化共享内存(Copy-on-Write),他们直接禁用了 CPython 的循环引用垃圾回收器,使得每台机器的内存使用量降低数千兆字节,整体吞吐提升近 10%。
- 自研 Pyre 静态类型检查器:面对上千万行 Python 代码的大型仓库,他们通过全量推行类型注解(Type Annotations)与自研的高性能静态检查工具,让动态语言在大型团队协作中具备了与 Java / C++ 相当的重构安全感。
2. Dropbox:推动 Python 语言现代化的核心驱动者
云存储巨头 Dropbox 早期服务端与桌面客户端全部使用 Python 编写,管理着百亿级文件元数据。为了解决千万行代码工程的安全重构与性能瓶颈,Dropbox 招聘了 Python 创始人 Guido van Rossum 等核心开发者,资助并深度孵化了现代 Python 的核心基础设施:
- 推动 Type Hints 与 Mypy 成熟:使静态类型推断成为现代 Python 标准库核心特性。
- 服务粒度下沉:对于核心磁盘底层块存储(Storage Engine),Dropbox 使用 Go 与 Rust 编写;而元数据逻辑、用户权限、API 路由与共享控制等复杂核心业务,依然稳健运行在 Python 体系中。
3. YouTube:承载全球最大视频内容网络的调度中枢
YouTube 成立之初完全由 Python 驱动。视频文件的解码转码等繁重工作交由 C/C++ 底层库完成,而视频元数据检索、评论交互、账户鉴权与页面渲染全部由 Python 完成。YouTube 工程师的评价是:“Python 拥有极速的开发与调试周期,让我们可以用最敏捷的方式击败竞争对手。”
五、选型决策指南与适用边界
尽管 Python 在大型网站后端具备极大优势,但没有任何一种技术选型是万能银弹。技术团队应当根据自身的业务特征客观评估:
何时坚定选择 Python 作为后端?
- 业务逻辑复杂度高且迭代频繁:例如企业级 SaaS、复杂的电商流程、内容社区或协同办公平台。
- 团队重视敏捷交付与全员全栈能力:需要工程师跨越前端接口、后端逻辑、自动化测试与数据看板,Python 的低心智负担能最大化个人输出。
- 紧密结合算法、数据分析与 AI:业务强依赖内容推荐、智能检索或大模型上下文调度,同构 Python 栈能带来极高的集成效率。
何时需要审慎引入或拆解隔离?
- 纯计算密集型吞吐系统:如纯视频流转码处理节点、高频量化交易系统、网络协议隧道服务(此类任务应直接采用 Rust / C++ / Go)。
- 超长驻留单机超大内存操作:Python 的对象开销相对原生内存布局更大,在必须精确控制内存对齐与零拷贝的底层网络驱动层不是最佳选择。
总结
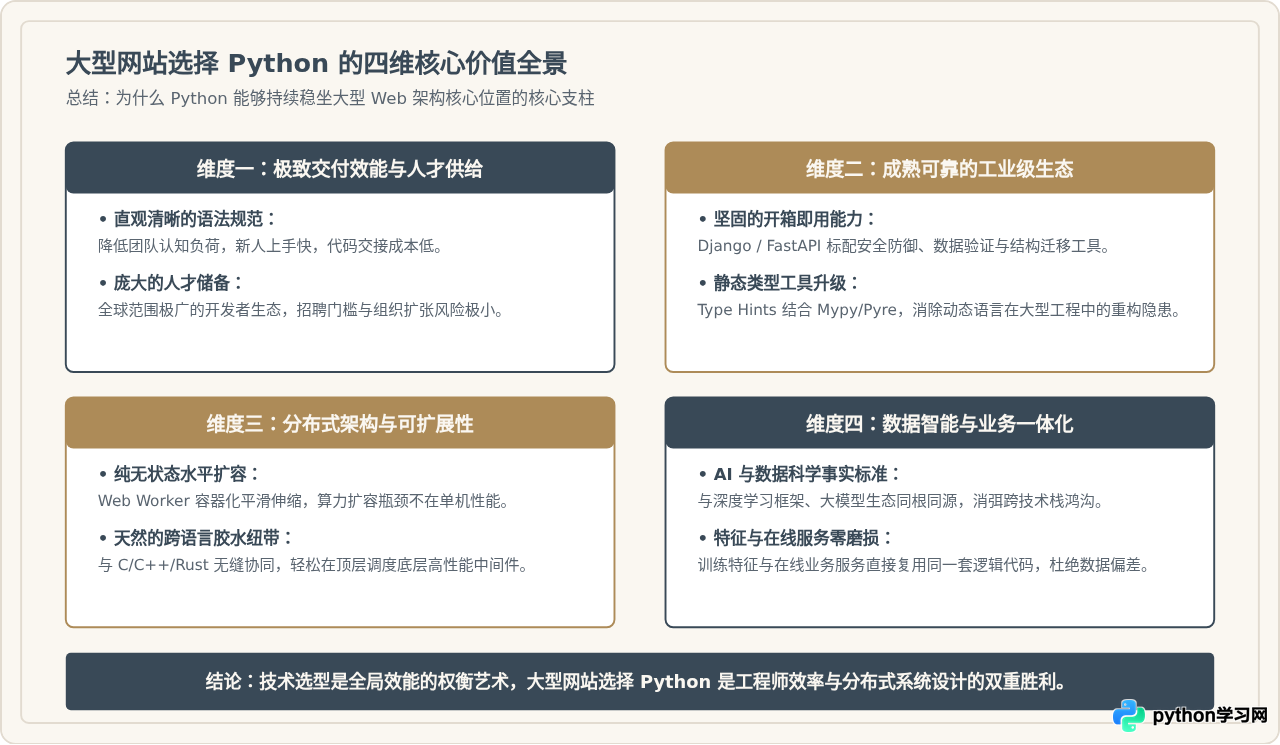
大型网站选择 Python 作为后端核心,从来不是源于盲目的性能盲信,而是源于极其务实的工程理性。在现代成熟的软件架构体系中,没有哪门语言能仅靠单机解释速度赢得整场战役。
Python 将开发者的精力和心智解放出来,全速推进商业逻辑创新与用户体验打磨;与此同时,分布式的无状态扩展能力、多级缓存机制以及清晰的混合微服务架构,赋予了系统从容应对上亿级流量的坚实底座。这正是 Python 历经互联网数轮技术迭代,依然在全球顶级大型网站中占据不可替代地位的根本原因。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















