


Python字符串格式化怎么做?f-string、format与%操作符对比
str() 强转数据类型,还会导致代码冗长脆弱。在 Python 中,解决这一需求的核心方法共有三种:% 操作符、str.format() 方法与 f-string(格式化字符串字面量)。现代 Python 项目中推荐优先选用 f-string,但在动态模板与日志收集场景下,另外两种方案仍有特定用途。
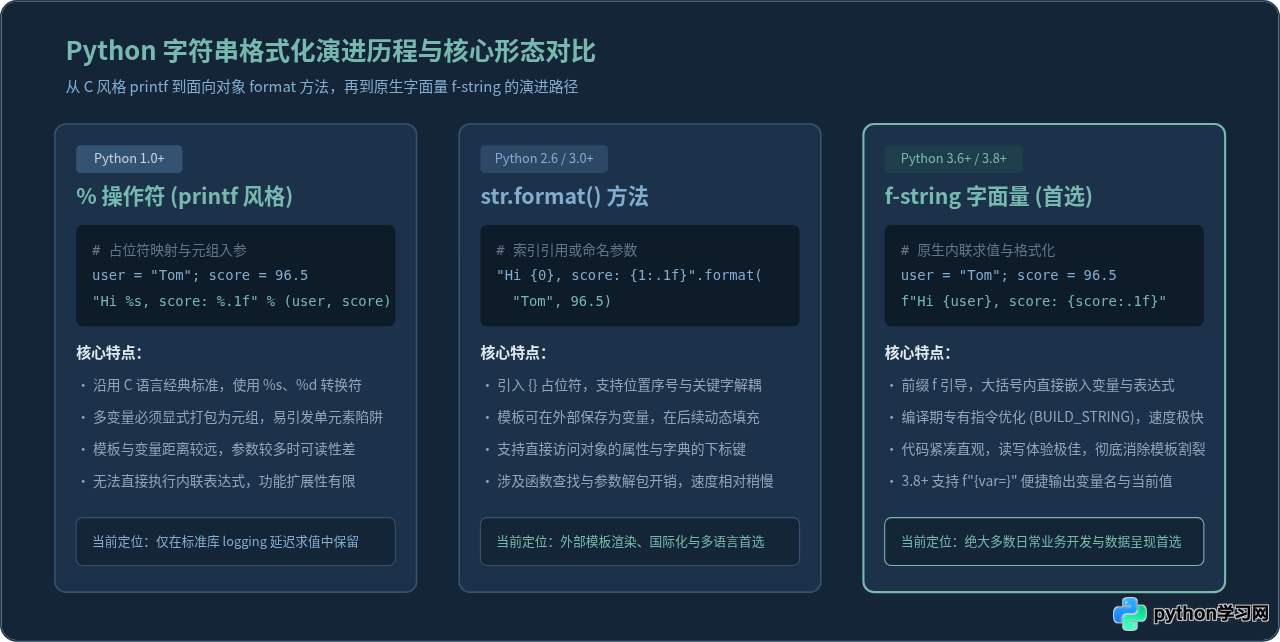
一、Python 字符串格式化的演进与三大方式核心形态
字符串格式化(String Formatting)是指将变量值、运算结果按照指定的排版规则(如对齐方式、小数位数、进制转换等)嵌入到文本模板中。随着 Python 语言版本的迭代,格式化机制经历了三次重大技术演进:
- % 操作符(Python 1.0+ 起始):沿袭 C 语言标准库中的
printf语法风格,依赖类型说明符。 - str.format()(Python 2.6 / 3.0 引入):转为面向对象方法设计,引入
{}占位符体系,支持按顺序和命名传递参数。 - f-string(Python 3.6 引入):语法前缀以
f或F声明,允许在花括号内直接嵌入原生变量与任意 Python 表达式,由底层字节码指令直接加速。
二、% 格式化操作符:原理与使用边界
% 操作符是最早期的字符串处理工具。其左侧为带有转换规范符的格式化字符串,右侧为填充数据。如果只有一个参数,可以直接提供单个对象;如果有多个参数,必须使用元组(tuple)包装。
1. 常见转换说明符
%s:调用str()转换为字符串输出。%d或%i:转换为有符号十进制整数。%f:转换为浮点数,支持%.2f等方式指定保留小数位数。%x/%X:转换为无符号十六进制整数(小写/大写)。
# 基础使用示例
name = "Alice"
age = 28
salary = 12500.567

info = "姓名: %s, 年龄: %d, 月薪: %.2f" % (name, age, salary)
print(info)
# 示例输出: 姓名: Alice, 年龄: 28, 月薪: 12500.57
2. % 操作符的致命短板
虽然 % 操作符语法简单,但在实际开发中存在明显的局限:
- 单元素元组解包陷阱:当待格式化的数据本身是一个元组时,如果不额外加一层括号,Python 会尝试将其解包为多个参数,从而抛出
TypeError: not all arguments converted during string formatting。 - 参数顺序不可错乱:位置参数严格按先后顺序对应,变量过多时极易错位。
- 维护成本高:当修改了中间某处占位符后,必须同步核对右侧元组的对应索引位置,极易引入隐蔽 Bug。
三、str.format() 方法:更具弹性的面向对象格式化
针对 % 操作符的痛点,Python 2.6 推出了 str.format() 方法。它彻底将占位符统一为 {},并赋予了更加灵活的参数寻址能力。
1. 位置参数与关键字参数
# 1. 自动顺序与显式索引
res1 = "{} 正在处理任务 {}".format("worker-1", 1024)
res2 = "{1} 完成后将交由 {0} 汇总".format("master", "worker-1")

# 2. 命名关键字传参
res3 = "节点: {node}, 状态: {status}".format(node="node-03", status="RUNNING")
2. 解构容器与对象属性
str.format() 允许在占位符内部直接索引字典的 Key 或访问对象的属性,无需在外部预先提取变量:
point = {"x": 12.5, "y": 45.0}
message = "目标坐标: X={p[x]}, Y={p[y]}".format(p=point)
print(message)
# 示例输出: 目标坐标: X=12.5, Y=45.0str.format() 最大的优势是模板与数据完全分离。如果你的输出文案来自外部配置文件、数据库或多语言翻译文件(i18n),此时字符串模板在运行时才会被读取,str.format() 依然是极为合适的选择。
四、现代首选:f-string 的深度解析与高级实战
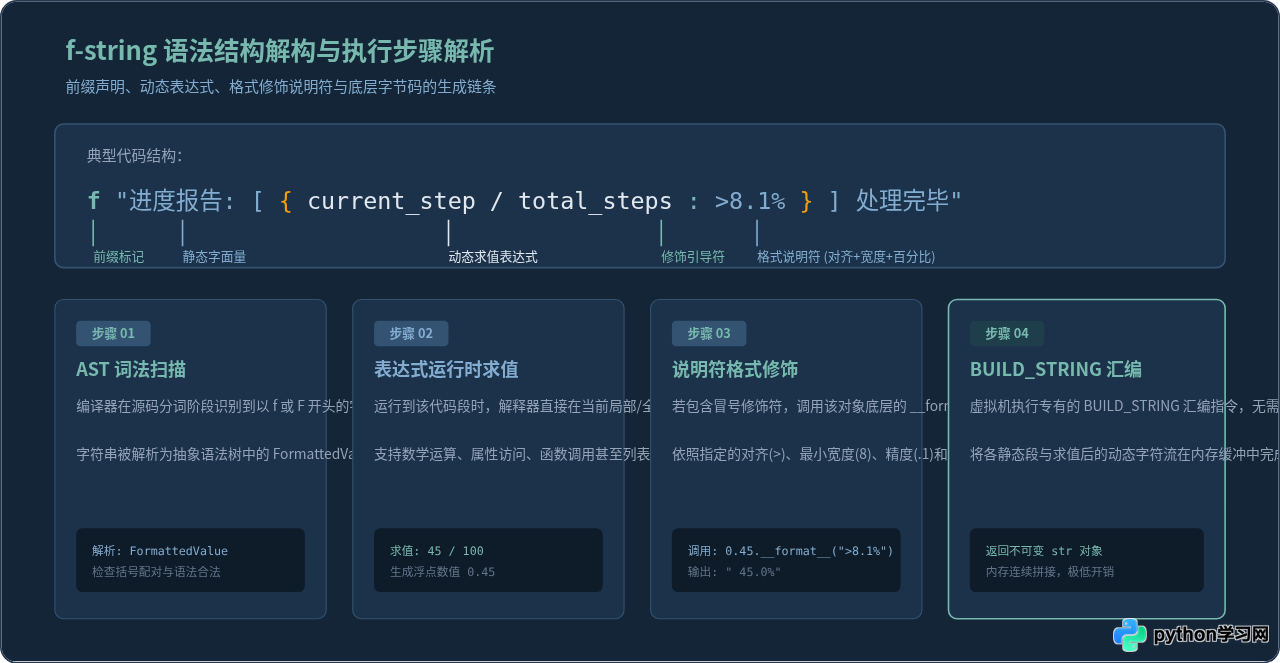
f-string(Formatted string literals)由 PEP 498 规范定义,是目前现代 Python(Python 3.6+)最推荐的字符串格式化机制。它将表达式解析直接移至编译期,不仅书写最为简洁自然,还提供了极其强大的内联修饰符。
1. 动态表达式与函数调用
在 f-string 中,花括号内部不仅可以写变量名,还可以书写任何合法的 Python 表达式,例如四则运算、方法调用或字典操作:
items = ["Apple", "Banana", "Orange"]
report = f"清单首项: {items[0].upper()}, 总计数量: {len(items)}"
print(report)
# 示例输出: 清单首项: APPLE, 总计数量: 3
2. 常用格式说明符(Format Specifier)清单
在变量或表达式后添加冒号 :,即可指定各种输出规范:
| 目标需求 | 代码示例 | 示例输出 | 说明 |
|---|---|---|---|
| 保留指定位小数 | f"{3.1415926:.2f}" |
"3.14" |
四舍五入并保留两位小数 |
| 数字千分位分隔符 | f"{1234567890:,}" |
"1,234,567,890" |
大数字按千分位加逗号 |
| 百分比格式输出 | f"{0.856:.1%}" |
"85.6%" |
自动乘以 100 并附带百分号 |
| 左对齐 / 右对齐 / 居中 | f"{'Python':*^14}" |
"****Python****" |
总宽14字符,用 * 填充并居中 |
| 数字补零对齐 | f"{42:05d}" |
"00042" |
限制宽度为5,不足以0补齐 |
| 时间日期指定格式 | f"{now:%Y-%m-%d %H:%M}" |
"2026-10-14 14:30" |
支持直接调用 strftime 指令 |
3. Python 3.8+ 调试神器:f"{variable=}"
在日常排查故障与调试打印日志时,通常需要打印变量名及其对应的值。从 Python 3.8 开始,f-string 支持在变量后直接追加等号 =,它会自动连同表达式文本一起输出:
user_id = "usr_98124"
status_code = 200
response_time = 0.0384

# 使用等号语法调试输出
print(f"{user_id=}, {status_code=}, {response_time=:.2f}s")
# 示例输出: user_id='usr_98124', status_code=200, response_time=0.04s
4. 容易踩坑的语法细节
- 花括号转义:如果需要在 f-string 中输出真实的花括号字符,需要写双花括号。例如
f"{{'status': 'ok'}}"输出{'status': 'ok'}。 - 引号冲突:表达式内部的引号不能与最外层的引号完全冲突。例如外层用双引号
f"..."时,内层字典的 Key 建议使用单引号{data['key']}。 - 表达式内禁止反斜杠(Python 3.12 之前):在 Python 3.12 之前,花括号内部不能直接书写
\n等转义字符,必须先将换行符保存在外部变量中再引入(Python 3.12 已经解除了该限制)。
五、三大方案全维度横向对比
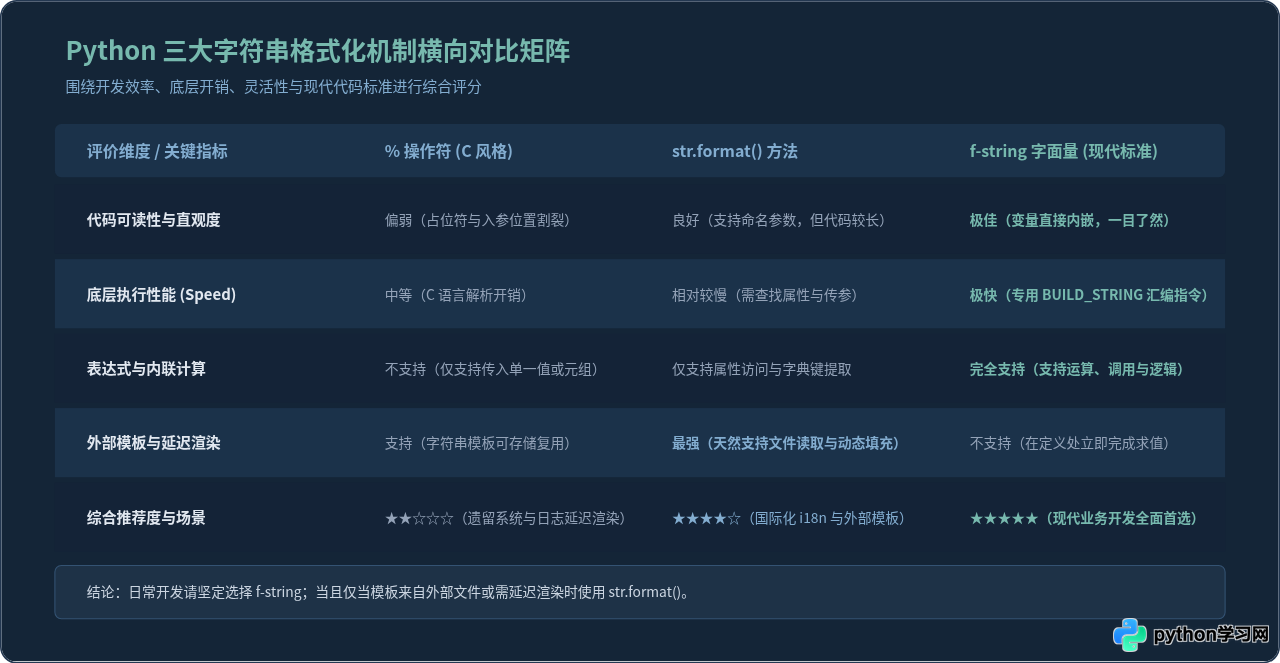
为了让读者更清晰地了解每种方式的优缺点与运行特征,下面从可读性、执行性能、语法灵活性及安全考量等多维度展开对比。
性能差异的原理解释
为什么 f-string 会比 str.format() 和 % 更快?
对于 str.format(),Python 解释器在运行时必须首先执行两次字典查找:先查找到字符串对象的 format 方法属性,再建立常规函数调用栈帧,随后对传入的元组或字典参数进行解包校验,最后在 C 语言层拼接字符串。
而对于 f-string,Python 编译器在语法分析阶段就将其识别为专用的 AST 结构,生成的字节码直接使用 FORMAT_VALUE 和 BUILD_STRING 指令。它避开了方法查找与函数调用开销,直接在底层 C 数组级别分配并填充字符串,因此通常比 format() 快 2 到 3 倍。
六、工程选型指南与决策流程
在实际项目架构与日常编码中,面对这三种格式化机制,应当遵循清晰的技术决策路径:
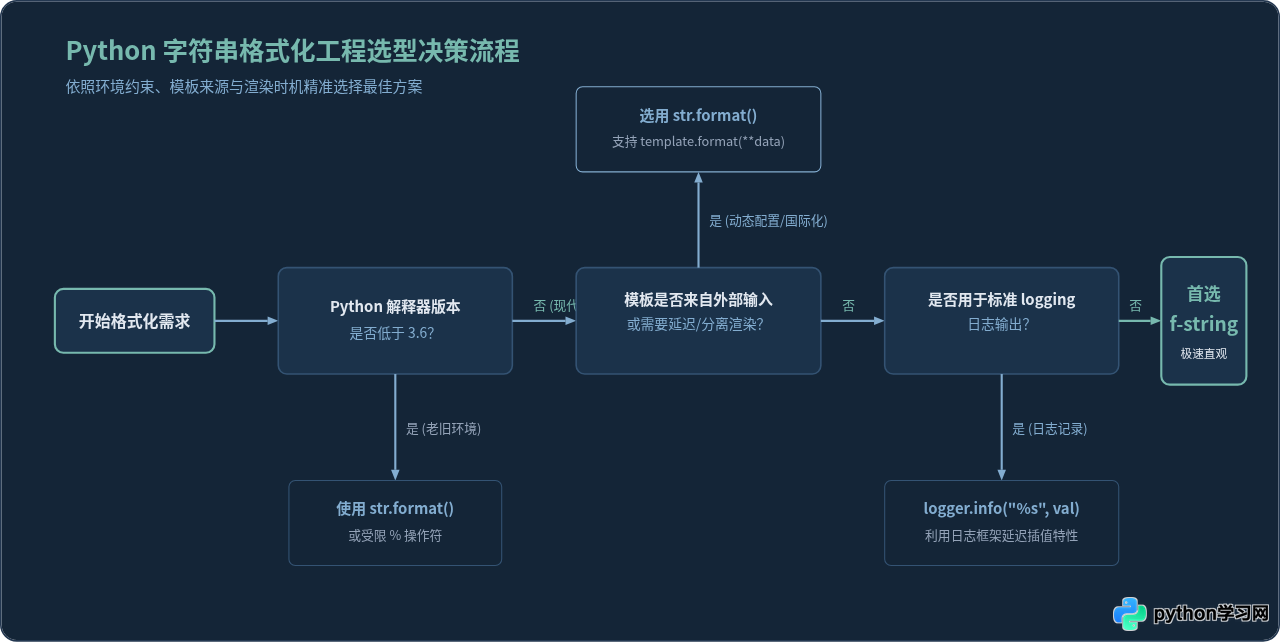
1. 常规业务逻辑:坚定使用 f-string
在任何日常脚本、Web 控制器逻辑、数据清洗或控制台输出中,无需犹豫,直接使用 f-string。它能提供最优的阅读体验和执行速度。
2. 日志系统 logging:谨慎使用 f-string
这是一个非常容易被忽视的工程细节。在使用 Python 标准库 logging 时,不推荐直接在入参写 f-string:
# 不推荐:即使日志级别高于 DEBUG,f-string 也会在传参前立刻执行求值与拼接
logger.debug(f"正在处理庞大数据集: {expensive_compute()}")

# 推荐:使用 logging 内部基于 % 的延迟机制,仅在当前级别生效时才执行格式化
logger.debug("正在处理庞大数据集: %s", expensive_compute_result)
因为日志系统具备级别过滤机制。如果日志级别被设为 INFO,所有 DEBUG 级别的日志行都会被丢弃。如果写成 f-string,Python 会在进入 logger.debug() 函数前就完成字符串计算,造成不必要的 CPU 与内存浪费。
3. 安全红线:禁止使用任何字符串格式化拼接 SQL
无论是 %、format() 还是 f-string,都绝对不能用来拼接 SQL 查询语句,否则会导致灾难性的 SQL 注入漏洞。
# 极度危险:SQL 注入高危代码
cursor.execute(f"SELECT * FROM users WHERE name = '{user_input}'")

# 安全做法:使用数据库驱动的原生参数化查询(Parameterization)
cursor.execute("SELECT * FROM users WHERE name = %s", (user_input,))
注意:数据库驱动中的 %s 或 ? 只是占位协议,底层由数据库客户端单独转义入参,绝非 Python 自身的字符串 % 替换。
七、常见问题与避坑解答
Q1: 如何在多行字符串(Docstring 或大段文本)中优雅使用 f-string?
可以使用三重引号 f"""...""",也可以利用 Python 自动拼接相邻字符串字面量的特性,将多行写在括号内以保持代码缩进整洁:
host = "10.0.0.8"
port = 8080
timeout = 30

# 括号内隐式换行拼接,避免每行产生多余缩进空格
config_text = (
    f"Host: {host}\n"
    f"Port: {port}\n"
    f"Timeout: {timeout}s"
)
Q2: 遇到用户不可信输入的外部模板时,该用什么?
如果你需要让用户自定义输出模板(例如邮件通知模板),str.format() 可能会暴露内部属性(如 {user.__class__.__init__})。针对不信任输入的动态场景,建议使用标准库自带的 string.Template,它仅支持简单的 $variable 占位符替换,具备极高的安全性。
八、总结回顾
回顾 Python 字符串格式化的演变历程,可以总结为三条简洁的实践法则:
- 编写新代码与日常开发:无脑选择 f-string,兼顾极致的运行性能与最清晰的代码可读性;
- 外部动态模板或多语言翻译:采用 str.format(),保留模板定义与数据填充的解耦特性;
- 使用 logging 输出调试信息:沿用日志框架推荐的参数传递方式,利用延迟计算节约性能开销。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















