


Python多线程爬虫数据竞争怎么解决?Queue队列线程安全用法
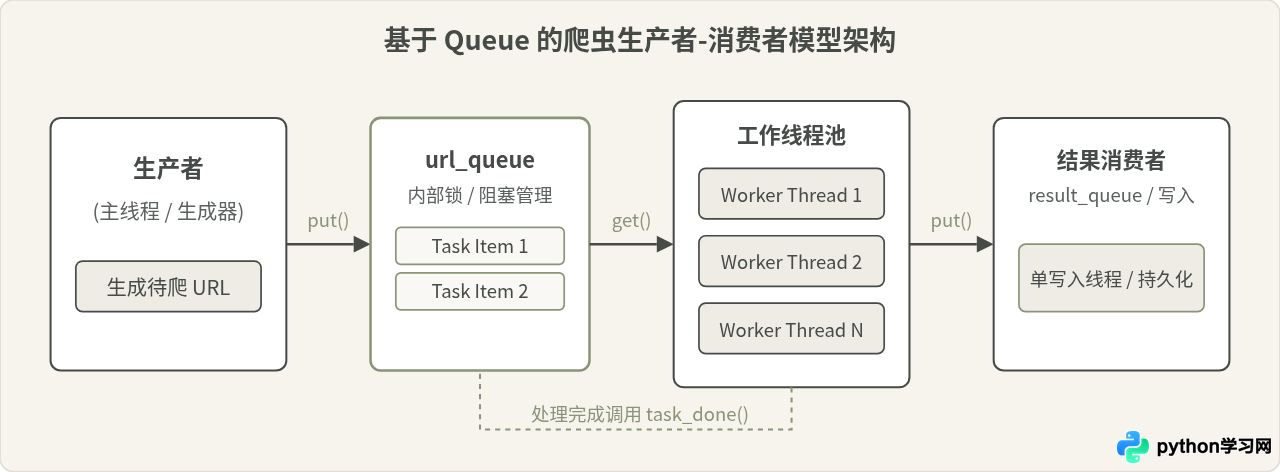
在编写Python多线程爬虫抓取网页时,多个线程同时向共享列表追加结果、修改请求计数器或提取新链接,往往会导致数据遗漏、重复抓取或状态统计异常,这类现象本质上就是数据竞争(Race Condition)。解决这一问题最优雅且标准的方式,是使用Python标准库提供的 queue.Queue 先入先出队列。通过把爬虫任务解耦为标准的生产者-消费者模型,让线程间通过线程安全的队列传递URL和抓取结果,彻底消除对非原子性共享变量的并发读写。
一、多线程爬虫中数据竞争的具体表现与根源
许多初学者在刚接触多线程爬虫时,通常习惯定义一个全局普通列表(如 results = [])或全局计数器(如 count = 0),随后启动多个工作线程直接在函数内部执行 results.append(item) 或 count += 1。虽然Python有GIL(全局解释器锁),但GIL仅保证单个字节码指令的原子执行,并不保证高级语言层面的复合操作具有原子性。
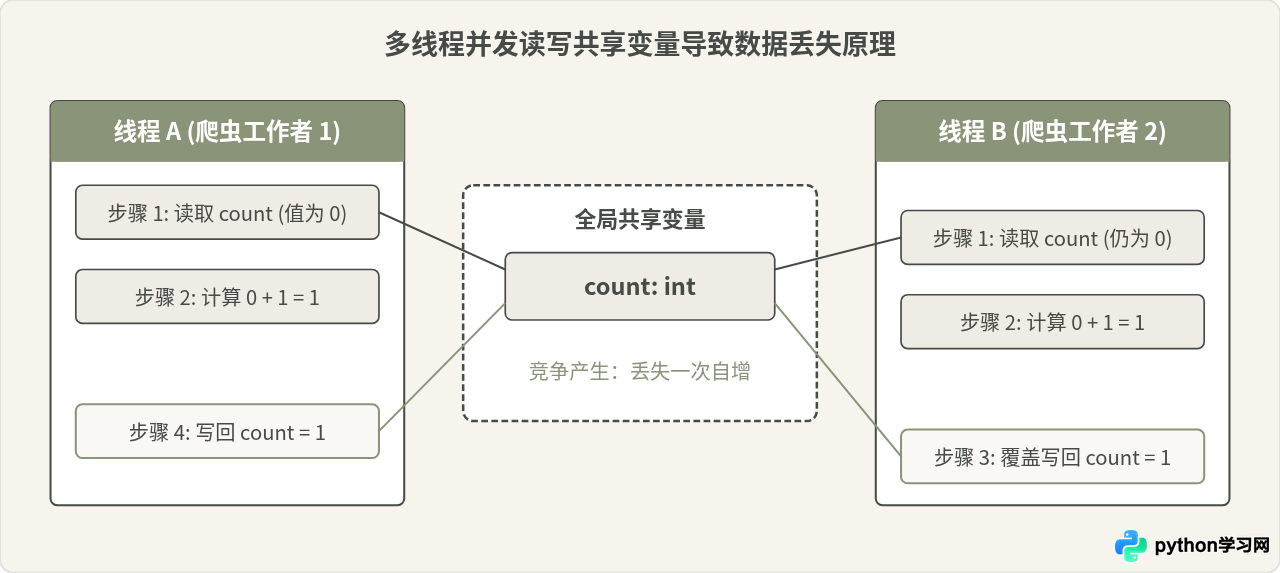
以爬虫中最典型的“下载计数器” count += 1 为例,该操作在Python虚拟机底层至少被拆解为四步:读取全局变量 count、加载常量1、执行加法计算、将结果写回全局变量 count。当两个爬虫线程几乎同时读取到相同的初始值时,二者分别计算并在写回时相互覆盖,最终实际下载了2个网页,计数器却只增加了1。
二、常见认知辨析:GIL与内置list是否万无一失?
常见说法辨析:有人认为“Python有全局解释器锁(GIL),而且 list.append() 是原子操作,因此多线程爬虫直接用共享列表收集数据不会有问题”。
这种说法在特定且非常局限的条件下是成立的:在官方CPython实现中,list.append() 和 list.pop() 确实对应单条底层字节码,直接追加通常不会导致底层列表内存结构破坏。但在真实爬虫项目中,这并不能保证业务安全,主要有以下三点致命缺陷:
- 非原子性的业务逻辑:爬虫往往需要“检查后执行(Check-Then-Act)”,例如
if url not in visited: visited.append(url)。检查与追加分属多条字节码,多个线程可能同时通过not in检查,导致URL被重复抓取数十次。 - 任务调度与协调混乱:普通列表无法在为空时自动阻塞等待新任务,线程只能依赖
while True和time.sleep()轮询,浪费CPU资源且容易出现线程退出不同步。 - 内存与异常扩散:如果直接对共享数据容器进行复杂的切片、弹出或过滤,多线程并发迭代时极易抛出
RuntimeError: list changed size during iteration。
三、核心解法:Queue队列的线程安全机制
Python标准库提供了 queue 模块,其中的 Queue 类专门设计用于多线程环境下的安全通信。其内部通过底层互斥锁(threading.Lock)与条件变量(threading.Condition)封装了所有的入队、出队操作,所有公共方法在调用时均自动完成加锁与解锁。
在爬虫架构中,Queue 为我们带来以下三项原生安全保障:
- 原子性操作:无论是
put()还是get(),均在内部锁保护下完成,杜绝多个线程在入队或出队时造成数据覆盖。 - 内置阻塞与挂起通知:当任务队列为空时,工作线程调用
get()会自动进入休眠等待,不会空转消耗CPU;当有新任务通过put()压入时,系统自动唤醒等待的线程。 - 精确的任务生命周期管理:配合
task_done()与join()方法,主线程可以精确挂起并等待队列中所有已接收的任务彻底处理完毕。
四、实战演练:规范的多线程安全爬虫实现步骤
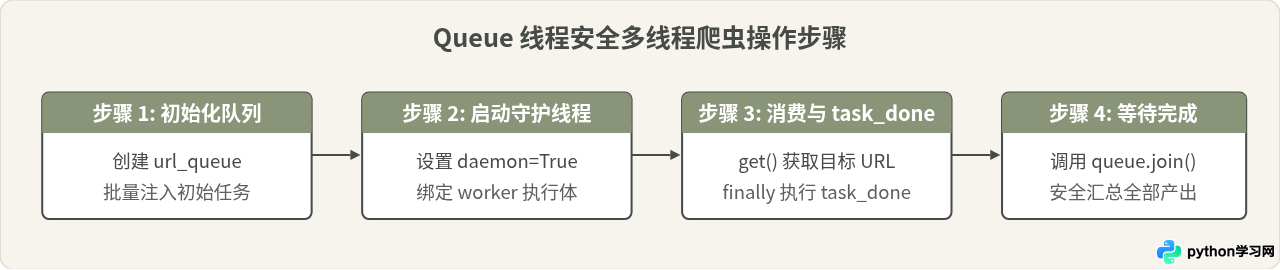
要构建一个无数据竞争、退出干净的爬虫程序,通常分为四个步骤执行。下面展示完整实现流程与代码。
完整可执行代码示例
环境说明:Python 3.8+ 标准环境,无需安装第三方高危锁依赖,直接使用标准库 queue 与 threading。
import threading
import queue
import time
import urllib.request

# 1. 初始化任务队列与结果队列
url_queue = queue.Queue()
result_queue = queue.Queue()

# 示例爬取任务源
SAMPLE_URLS = [
    f"https://httpbin.org/delay/1?id={i}" for i in range(10)
]

def crawler_worker():
    """工作线程:循环从 url_queue 获取任务并执行抓取"""
    while True:
        url = url_queue.get()
        try:
            # 执行网络请求(I/O密集型任务释放GIL)
            req = urllib.request.Request(
                url,
                headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
            )
            with urllib.request.urlopen(req, timeout=5) as response:
                status_code = response.getcode()
                result_queue.put({"url": url, "status": status_code, "ok": True})
        except Exception as e:
            # 异常处理:即使请求失败也安全入队错误信息
            result_queue.put({"url": url, "error": str(e), "ok": False})
        finally:
            # 必须调用 task_done 告知队列当前出队任务已终结
            url_queue.task_done()

def main():
    # 填充初始任务
    for url in SAMPLE_URLS:
        url_queue.put(url)

    # 启动固定数量的工作线程
    worker_count = 4
    threads = []
    for _ in range(worker_count):
        t = threading.Thread(target=crawler_worker, daemon=True)
        t.start()
        threads.append(t)

    print(f"[*] 已启动 {worker_count} 个工作线程,开始抓取任务...")

    # 阻塞主线程,直至 url_queue 中的所有任务均被 task_done 确认
    url_queue.join()

    # 收集并打印结果
    print("[*] 所有抓取任务完成,正在导出结果:")
    while not result_queue.empty():
        item = result_queue.get()
        print(f"  - 结果: {item}")

if __name__ == "__main__":
    main()
代码运行输出示例:
[*] 已启动 4 个工作线程,开始抓取任务...
[*] 所有抓取任务完成,正在导出结果:
  - 结果: {'url': 'https://httpbin.org/delay/1?id=0', 'status': 200, 'ok': True}
  - 结果: {'url': 'https://httpbin.org/delay/1?id=1', 'status': 200, 'ok': True}
  - 结果: {'url': 'https://httpbin.org/delay/1?id=2', 'status': 200, 'ok': True}
  - ... (共10条完整数据,无任何丢失或并发覆盖)
五、关键细节与避坑指南
在实际开发中,仅知道调用 put() 和 get() 往往是不够的,还需要注意以下几个容易导致程序假死或数据泄漏的细节:
1. task_done() 必须置于 finally 块中
url_queue.join() 本质上维护了一个未完成任务计数器。每次 put() 计数器加1,每次 task_done() 计数器减1。如果网络请求超时报错导致代码中途抛出异常,未能执行 task_done(),计数器将永远无法归零,主线程的 join() 将陷入永久假死状态。因此,务必将 task_done() 放置在 try...finally 结构的最末尾。
2. 守护线程(daemon=True)与退出机制
工作线程在 while True 中不断阻塞等待新任务。将工作线程设置为守护线程(daemon=True),主线程在执行完 url_queue.join() 并持久化全部数据后退出时,Python解释器会自动回收所有守护子线程,无需手动向队列塞入终止信号(Poison Pill)。若需要平滑关闭非守护线程,可在任务完成后向每个线程推送一个约定的标记(如 None),当工作线程读到 None 时执行 break 优雅退出。
3. URL去重安全控制
若需要动态在爬虫运行过程中解析页面并添加新URL,去重集合 visited_set 仍然是一个共享资源。不能直接用原生 set() 进行并发读写。推荐两种安全方案:
- 为全局
set增加一个专用锁:with lock: if url not in visited: visited.add(url); url_queue.put(url)。 - 单独启动一个“调度线程”,所有工作线程解析出的新URL一律发回专用的
new_urls_queue,由唯一的调度线程单线程做去重并入队,利用消息传递彻底消除数据共享。
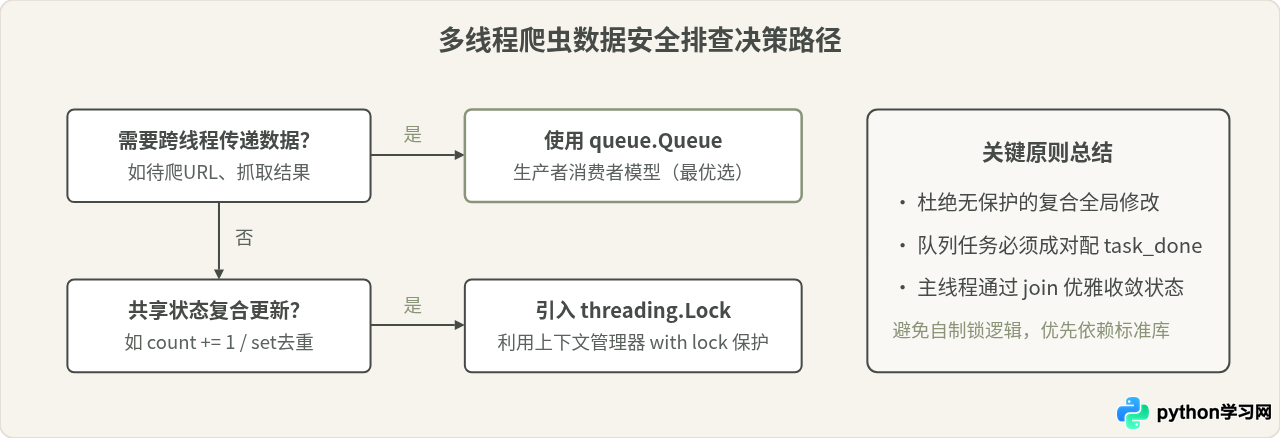
六、总结:多线程安全排查与实践原则
在Python多线程网络编程中,解决数据竞争的核心指导思想是:“不要通过共享内存来通信,而要通过通信来共享内存”。利用 Queue 构建清晰的单向数据流管道,不仅代码结构模块化、易于排查定位,更从底层机制上杜绝了隐蔽的时序竞争问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















