


Python函数为什么要返回元组?
深入解析Python函数在返回多个值时为什么底层选择元组。从语法层面的逗号打包机制、数据不可变的契约安全性、内存布局与性能优化,到序列解包的对称设计全面剖析。
在Python中编写 return a, b 时,表面上看函数仿佛拥有同时返回多个独立变量的能力,但底层实际上只返回了一个对象——一个包含这些元素的元组。Python之所以选择元组而非列表或其他结构作为多返回值的底层载体,源于其语法的天然对称性、数据不可变带来的接口安全性,以及紧凑高效的内存运行机制。
一、核心真相:Python函数只能返回一个对象
很多初学者在第一次接触Python时,会被类似下面的代码所迷惑:
def get_user_coordinates():
    x = 10.5
    y = 20.8
    return x, y

result = get_user_coordinates()
print(type(result))  # <class 'tuple'>
print(result) # (10.5, 20.8)从代码形式上看,return x, y 并没有使用任何括号包裹,容易让人误以为解释器在底层支持某种“多值通道”。然而打印 type(result) 就会发现,接收到的返回值是一个确定无疑的 tuple。
在Python语法规范中,真正构造元组的符号是逗号(comma),而不是小括号。小括号在绝大多数场景下仅仅用于消除语法歧义(例如在函数调用参数列表与元组冲突时)。因此,当表达式中出现多个由逗号分隔的数值时,Python解析器会自动将其打包为一个元组。函数返回多值,本质上是“自动元组打包(Tuple Packing)”与后续“序列解包(Sequence Unpacking)”的协作结果。
二、不可变性:提供跨调用边界的安全性契约
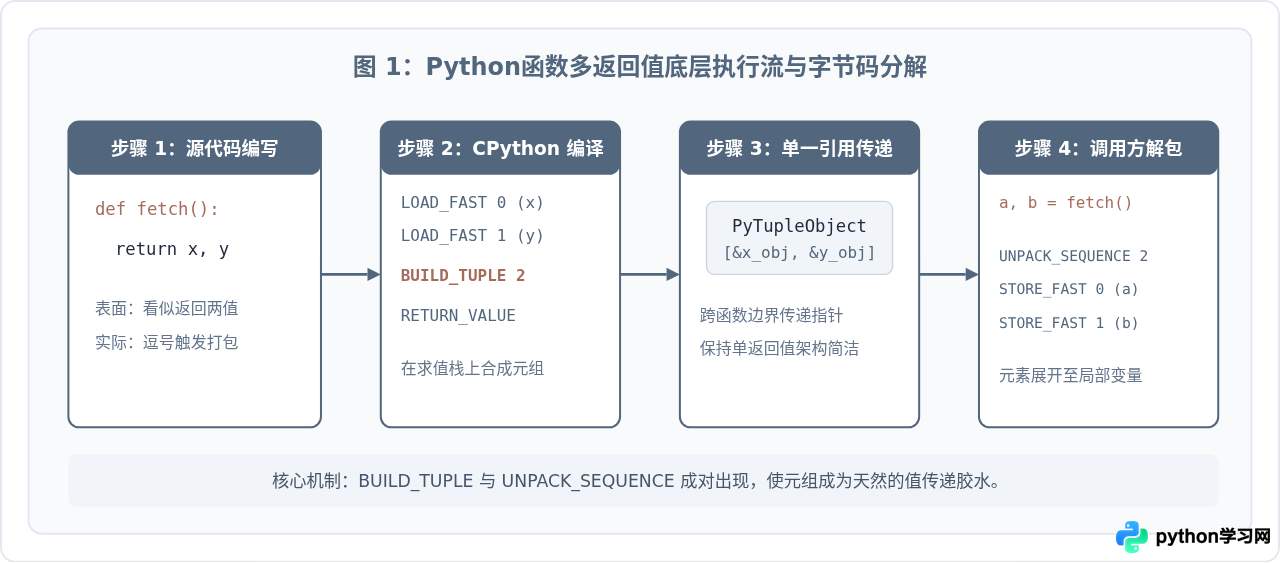
如果只是为了将多个变量捆绑在一起返回,Python的内置数据结构中还有 list(列表)。那么为什么核心语法没有设计成自动返回列表,而是强制返回元组?最首要的原因就是不可变性(Immutability)。
函数调用通常发生在不同的作用域、不同的类方法甚至不同的模块之间。返回值代表了被调用方在某个时间点计算出的“确定性状态快照”。一旦使用可变对象(如列表)作为默认返回值容器,将会引入严峻的副作用隐患:
- 防范意外修改:若返回列表,下游代码在遍历或处理时一旦误调用
result.append()或result.pop(),就会改变这个容器的内容与结构。如果该对象同时被缓存或共享,将引发难以排查的时序缺陷。 - 防御深层泄漏:不可变元组向调用方明确传递了一个契约——“这是只读的结果记录,大小和元素映射关系永久固定”。
三、底层性能与内存开销考量
函数调用是编程语言中最频繁发生的操作之一。如果每次函数返回多个值都需要创建高开销的对象,会严重拖慢整体执行效率。元组在 CPython 底层实现中享有多项特权优化:
1. 紧凑的定长内存结构
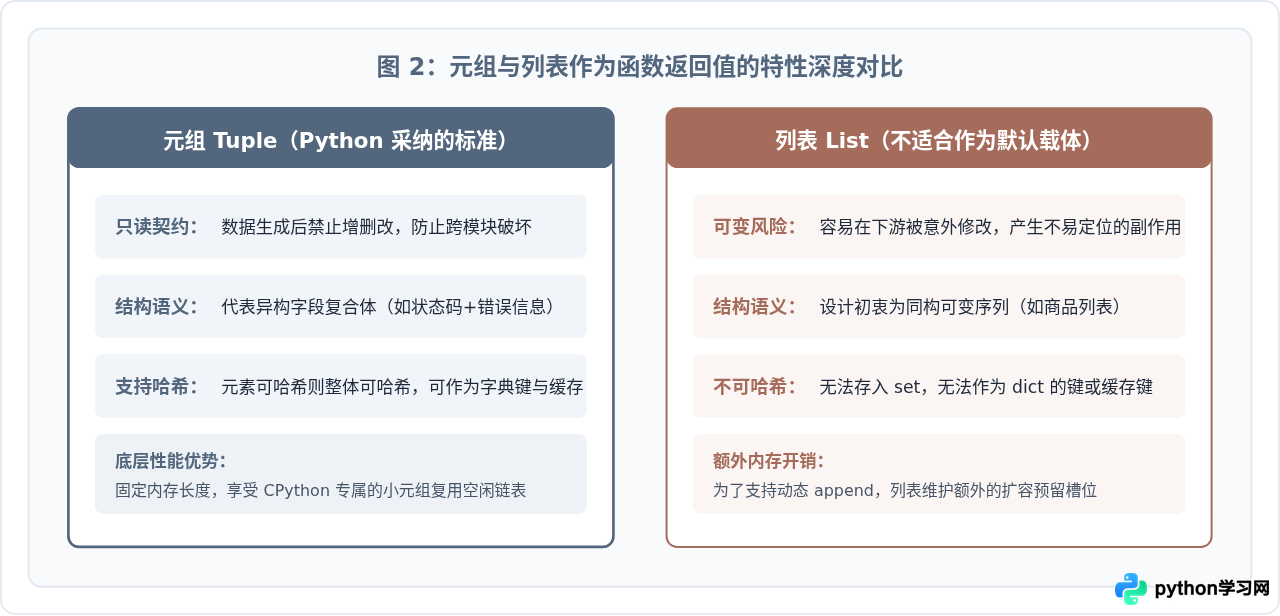
在 CPython 源码中,PyTupleObject 的定义非常精简。它由对象头和一段连续的指针数组构成,数组长度在创建时直接定死。而 PyListObject 除了持有元素数组指针外,还必须维护一个 allocated 字段,用于记录当前已分配的内存容量。为了应对未来的追加操作,列表经常会预先过度分配内存(Over-allocation)。函数返回值往往只需临时容纳计算结果,列表的预分配机制在此处完全属于多余的内存浪费。
2. 小元组空闲链表(Free Lists)缓存池
为了进一步消除频繁调用 malloc 和 free 造成的系统调用开销,CPython 内部实现了一个名为 free_list 的内存池机制。对于长度在 1 到 20 之间的常用元组,当它们被垃圾回收销毁时,其所占用的结构体内存并不会立即退还给操作系统,而是挂入特定长度的空闲链表。当下一次函数再次通过 BUILD_TUPLE 打包返回相同数量的元素时,可以直接从空闲链表中取出现成内存进行复用,极大提升了执行吞吐量。
四、语法对称性:打包与解包的优雅闭环
在语言美学与心智模型上,Python追求“一种明显且唯一的方式(There should be one-- and preferably only one --obvious way to do it)”。元组赋予了多值返回极其自然的语法对称性。
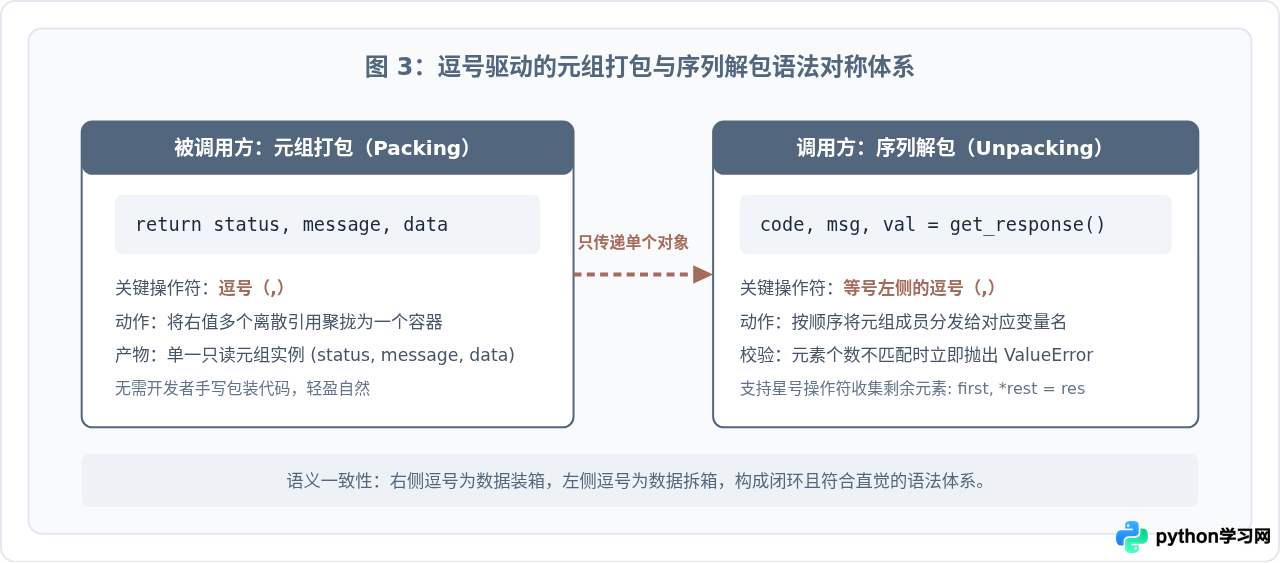
调用方不仅能够按序一一解构,还能配合 Python 强大的解包语法进行更灵活的处理:
def get_network_report():
    return 200, "OK", 0.042, 1024, "192.168.1.1"

# 1. 忽略不需要的返回值
status_code, status_msg, *_ = get_network_report()

# 2. 保留为完整元组整体传递
full_report = get_network_report()
log_to_file(full_report)
五、何时该用元组?多返回值类型的选型边界
虽然返回元组是 Python 的内置默认行为,但在实际工程开发中,盲目返回冗长的元组会造成严重的可维护性灾难。元组依赖位置顺序(Positional Ordering)来区分数据,当返回值超过 3 个时,调用方极易混淆位置,例如将宽与高颠倒、将状态码与耗时传错。
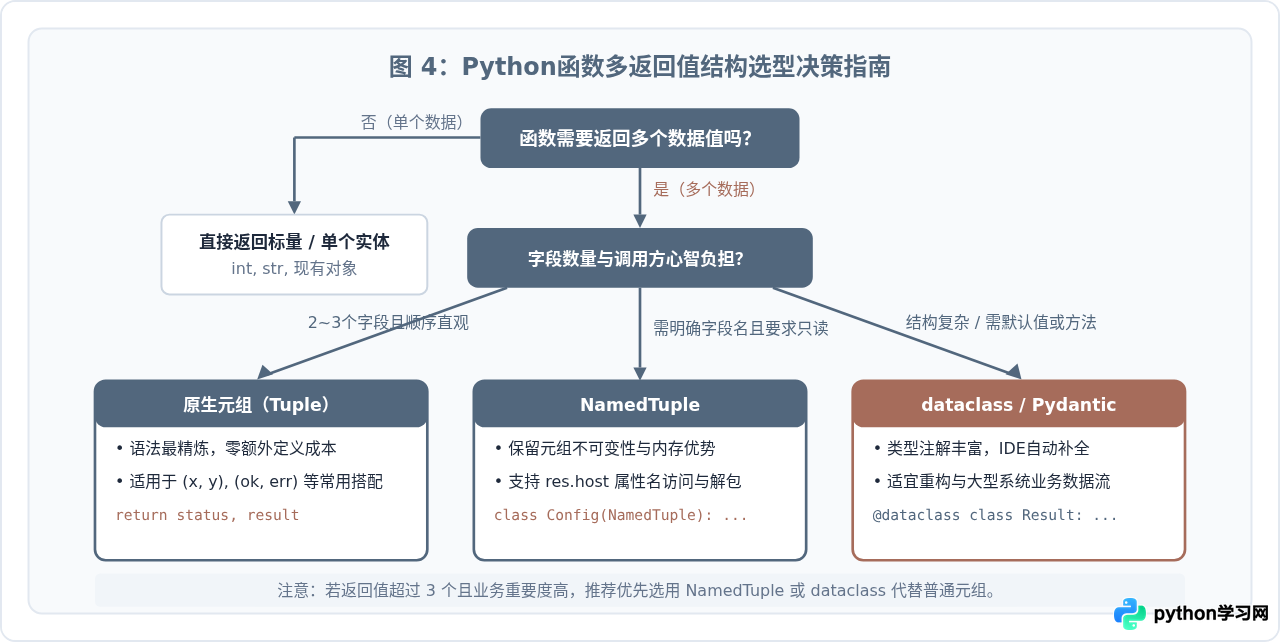
为了直观对比各类方案的适用边界,我们可以参考以下维度清单:
| 选型方案 | 不可变性 | 属性名访问 | 内存消耗 | 典型推荐场景 |
|---|---|---|---|---|
| 原生元组 (tuple) | 是 | 否(仅索引/解包) | 极低(小元组缓存复用) | 2~3 个字段的轻量多返回值,如坐标、状态+结果 |
| NamedTuple | 是 | 是(支持点号语法) | 极低(与普通元组相同) | 3~5 个字段,既要语义字段名又要保持不可变契约 |
| 列表 (list) | 否(可变) | 否 | 较高(扩容预留内存) | 元素数量不确定、同构可变的实体集合 |
| 数据类 (dataclass) | 可选(frozen=True) | 是 | 适中(标准类实例) | 业务核心实体模型、具备复杂方法或字段默认值 |
六、总结
回到最初的问题:“Python函数为什么要返回元组?”其答案并非单一维度的偶然选择,而是语言设计者深思熟虑后的统一体现:
- 机制层面的同一性:Python虚拟机坚持单一返回值的底层设计,通过“逗号打包”将多个对象聚合为单个元组,既维持了调用栈的纯粹与统一,又在语法层面赋予了开发者“多值返回”的优雅体验。
- 数据契约的安全性:元组的不可变性杜绝了跨作用域的意外状态篡改,为函数间的数据传递建立了可靠的只读防线。
- 运行时性能的最优解:紧凑的定长内存结构与 CPython 专属的小元组空闲链表优化,让元组成为高频函数调用场景中开销最小的复合容器。
理解这一点,不仅有助于写出符合 Python 惯用表达(Pythonic)的优雅代码,更能帮助我们在面对复杂业务时,精准做出最适合的接口返回值设计。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















