


Python社区资源怎么加速人工智能技术的迭代与创新?
深入解析Python社区资源如何通过解耦的技术栈、开箱即用的预训练资产、全球协同验证机制及工程化闭环,全方位加速人工智能技术的研发迭代与应用创新。
一、分层解耦的生态架构:消除重复开发与算力割裂
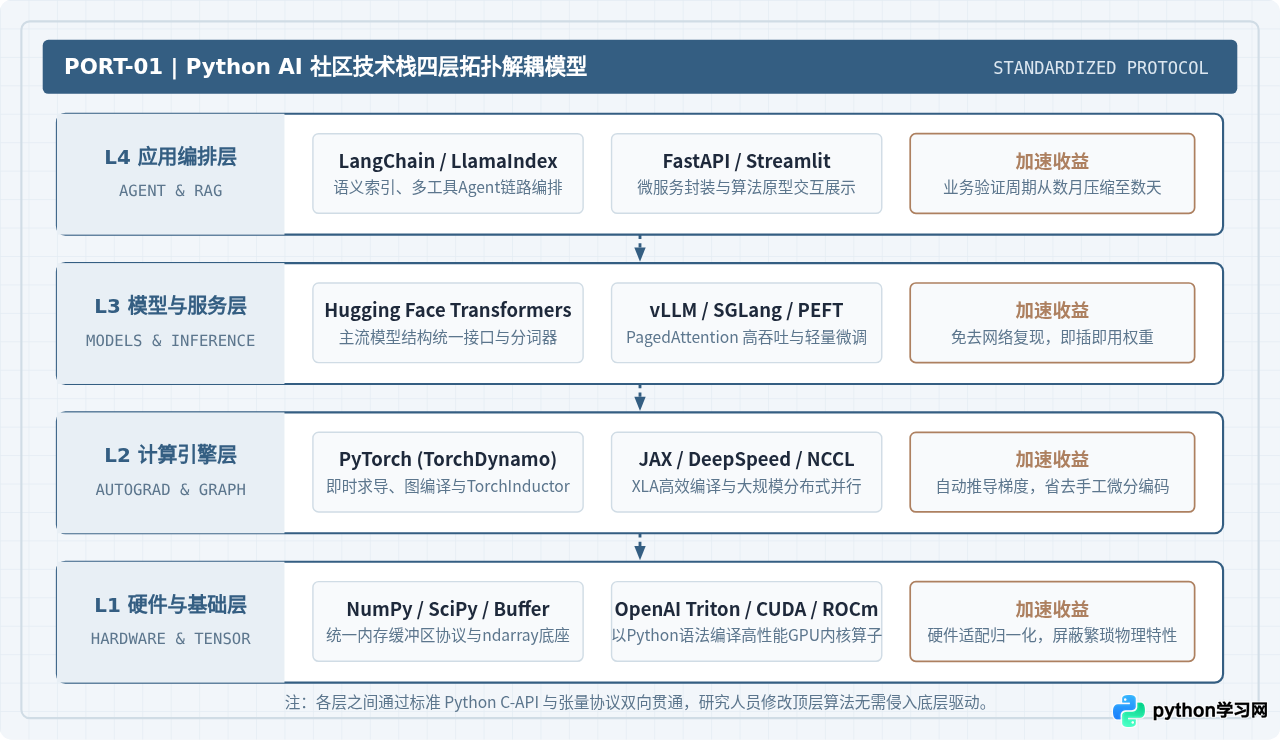
人工智能模型的创新并非空中楼阁,它极度依赖底层线性代数库、并行计算调度与微分求导系统的配合。如果每一项新型网络架构的探索都需要研究者手写CUDA算子、设计反向传播图并手动优化显存分配,算法研发的尝试成本将无法承受。Python社区最核心的价值,在于构建了一套自底向上完全解耦的技术栈。
如下图所示,Python AI生态形成了清晰的分层协作结构。基础层以 NumPy、PyBind11 和 Triton 为代表,规范了多维内存布局与硬件互操作接口;计算引擎层如 PyTorch、JAX 封装了自动微分与图编译调度;高阶模型层如 Transformers 和 vLLM 提供模块化网络构件与吞吐加速;最顶层则通过 LangChain 等工具快速完成智能体场景搭建。各层之间通过标准化契约交互,底层的优化能即刻反哺全行业应用。
二、端到端敏捷闭环:从资产引入到生产演进的标准五步
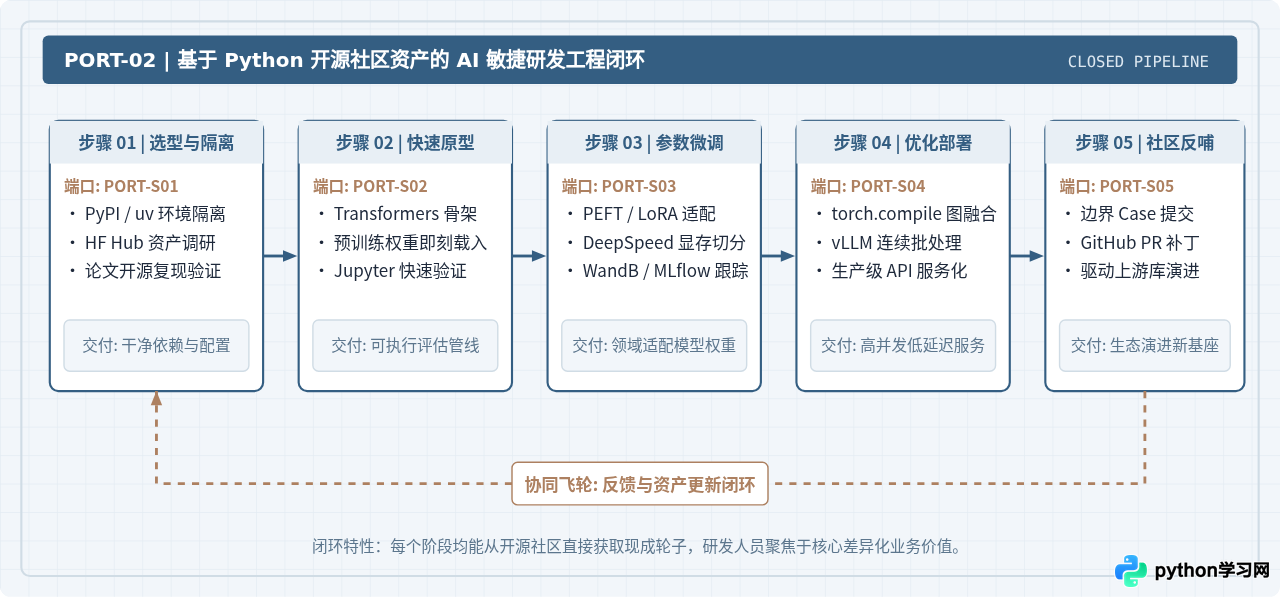
在实际研发中,Python社区资源的加速作用具体体现在“研发流”的缩短。典型的AI技术迭代过程包含五个明确的阶段,形成高度敏捷的迭代闭环:
- 资产选型与依赖锁定(PORT-S01):利用现代包管理器(如
uv或pip-tools)快速构建隔离环境,从 PyPI 与 Hugging Face 模型集市筛选最新基座与对应开源库。 - 标准化模块拼装(PORT-S02):利用
transformers、timm等库在数十行代码内还原学术界前沿架构,消除手写模型定义的排错消耗。 - 轻量化微调与实验(PORT-S03):通过
PEFT、LoRA与DeepSpeed进行低成本适配,无需全参数重训即可完成领域知识注入。 - 编译加速与服务部署(PORT-S04):调用
torch.compile或部署到vLLM,自动应用内核融合与内存优化,将验证模型转为高并发接口。 - 社区协同与反馈回流(PORT-S05):遇到极端算子边界问题时,提交最小复现脚本至 GitHub Issues 或提交流水线 PR,借助社区贡献者快速定位并解决瓶颈。
以模型微调环节为例,借助 peft 库,开发者仅需十余行代码即可在预训练模型上挂载低秩自适应(LoRA)适配器,避免重构张量前向传播的内部逻辑:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import LoraConfig, get_peft_model

# 1. 直接复用社区标准化模型资产与分词器
model_id = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# 2. 声明社区标准化的微调超参数策略
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

# 3. 动态织入适配层,可训练参数量骤降至不足原来的1%
peft_model = get_peft_model(base_model, lora_config)
peft_model.print_trainable_parameters()
# 输出示例: trainable params: 16,384,000 || all params: 7,615,616,512 || trainable%: 0.215
三、全球协同网络:超越单一机构能力的验证与进化
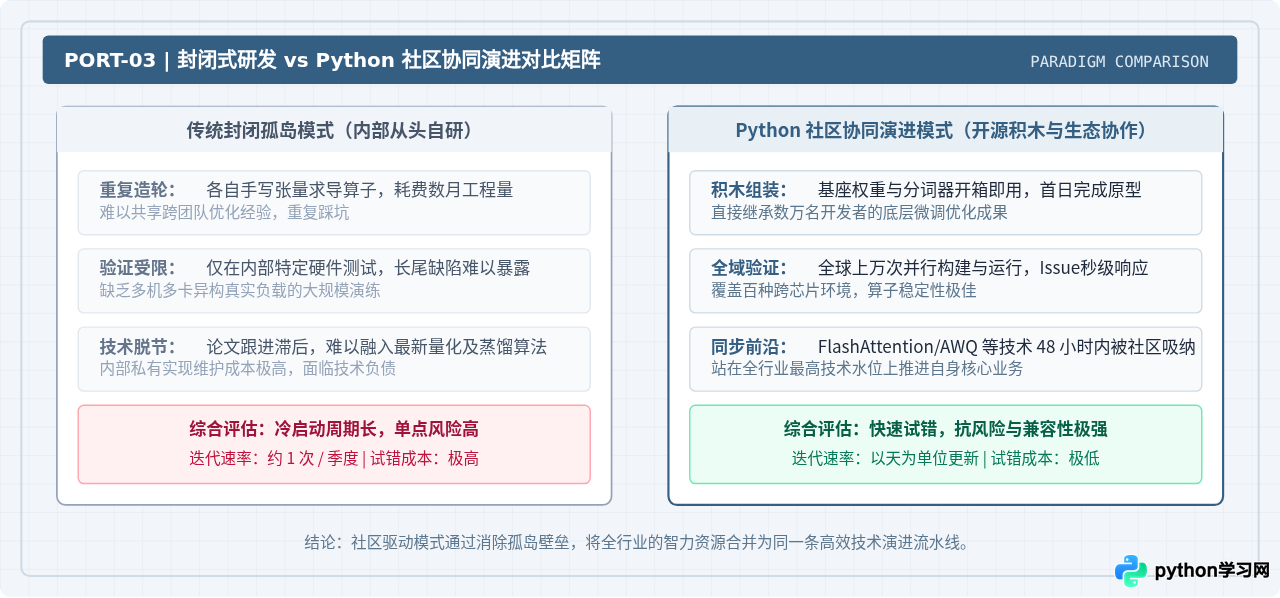
在传统闭门造车的研发模式下,代码缺陷、长尾边界情况以及跨硬件兼容性问题只能由内部小团队逐一排查。当模型规模增长到数十亿甚至千亿参数时,单次测试失误所消耗的算力与时间成本极其高昂。
Python社区构建了全球规模最大的协同测试与同行评议网络。学术论文发布的同时附带可复现的代码仓库(Papers with Code机制),全球开发者在数天之内便会在各种不同的硬件架构(NVIDIA、AMD、Apple Silicon、昇腾等)上进行交叉运行。这种高密度的真实负载测试能以极快速度定位诸如数值溢出、显存碎片化或多机通信死锁等隐蔽Bug。
| 对比维度 | 内部闭门自研路径 | Python 社区资源驱动路径 | 工程效能差异分析 |
|---|---|---|---|
| 前沿算法复现 | 根据论文数学公式推导逐行手写,平均耗时 2~6 周 | 直接引用开源复现仓库或官方库,通常小于 24 小时 | 消除理论与工程实现的落差,大幅缩短验证周期 |
| 硬件加速支持 | 针对特定显卡手写专用汇编或 CUDA 内核 | 使用 Triton、PyTorch 统一调度或硬件厂商提供的 Python 绑定 | 屏蔽硬件微架构差异,实现无缝跨芯片平台迁移 |
| 错误定位效率 | 依赖企业内部少数专家排查底盘异常 | 检索 GitHub Issues 与讨论区,往往已有已知解决方案 | 将隐性知识显性化,降低单点人才依赖风险 |
| 生态工具扩展 | 自行设计可视化、数据管道与日志收集工具 | 接入 WandB、Ray、vLLM 等成熟开源套件 | 专注于业务价值交付,避免非核心功能分散精力 |
四、工程治理指南:避免社区资源引入的常见陷阱
尽管Python社区资源为AI创新提供了充沛的动力,但在实际工程落地的过程中,盲目依赖未经筛选的第三方代码同样会带来安全隐患和稳定性危机。要让社区资源切实发挥加速作用,团队需要建立严谨的工程治理规范:
- 严格的版本锁定与确定性构建:AI依赖链条通常极深,上游基础库(如
torch或triton)微小的次版本升级可能引发算子行为不一致。必须通过requirements.lock、uv.lock或容器化镜像锁定运行环境,杜绝“本地能跑但生产环境报错”的现象。 - 开源许可证与合规性审查:预训练模型权重与训练数据集通常附带特定授权(如 Apache 2.0、MIT、Llama 商业限制协议、CC-BY-NC 等)。在将其应用于商业产品前,必须对模型权重与配套代码的许可证进行隔离审查,避免法律合规风险。
- 社区健康度与代码活跃度评估:在将某个新出现的社区库作为核心依赖前,应检查其维护团队背景、最近提交频率、待解决 Issues 比例以及单元测试覆盖率。优先选择拥有健全治理机制和主流机构背书的项目。
- 积极反哺与上游对齐:当业务内部针对开源库修复了特定漏洞或完成了性能调优时,应尽可能剥离业务敏感信息并向官方提交 Pull Request。保持与上游代码主干一致,可以避免未来升级时付出高昂的分支合并维护代价。
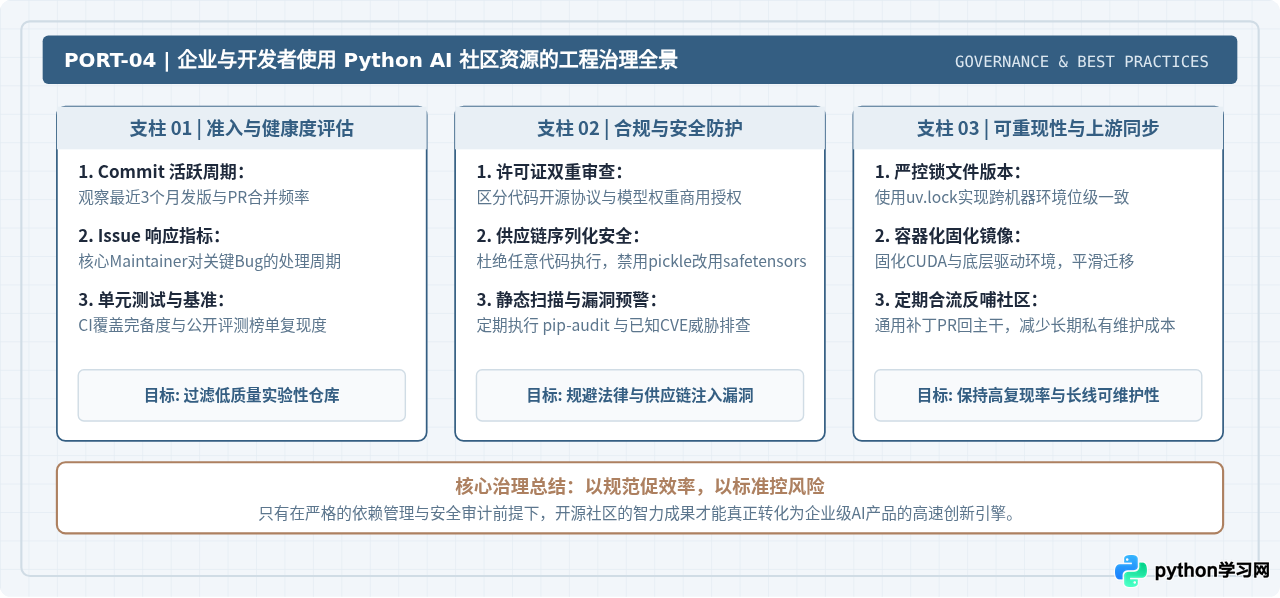
pickle.load() 或加载旧格式的 .bin 文件。应始终优先选用 safetensors 格式,该格式不仅具备零拷贝加载的高吞吐优势,更从根本上杜绝了利用反序列化机制执行恶意系统指令的安全漏洞。
五、总结:站在巨人的肩膀上持续演进
Python社区之所以能够成为全球人工智能创新的策源地与加速器,本质在于它建立了一种高流动性、高度解耦且自我强化的知识工程网络。
从顶层的智能体应用到底层的并行硬件编译,任何一个环节的技术突破,都能在几小时至几天内通过清晰的协议与接口迅速扩展至全行业。对于开发者和企业而言,深刻理解这套资源的组织结构,建立标准化的工程治理流程,善于“借力”而非“从零重复造轮子”,是确保技术研发始终紧跟AI浪潮演进并维持核心竞争力的最有效途径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















