


Python爬虫零基础入门:环境搭建与第一个抓取程序
面向零基础读者的Python网络爬虫入门教程,涵盖运行原理、虚拟环境搭建、依赖库安装、第一个抓取脚本编写、数据解析及常见报错排查。
网络爬虫的核心任务是模拟客户端向指定服务器发送网络请求,获取目标网页的源码,并从中提取出有价值的数据。本文面向没有爬虫开发经验的读者,通过标准步骤完成 Python 运行环境的准备,安装核心库,编写并运行一个最小可用的网页抓取脚本,同时理清基础排错机制与合规边界。
一、网络爬虫的核心机制与请求交互
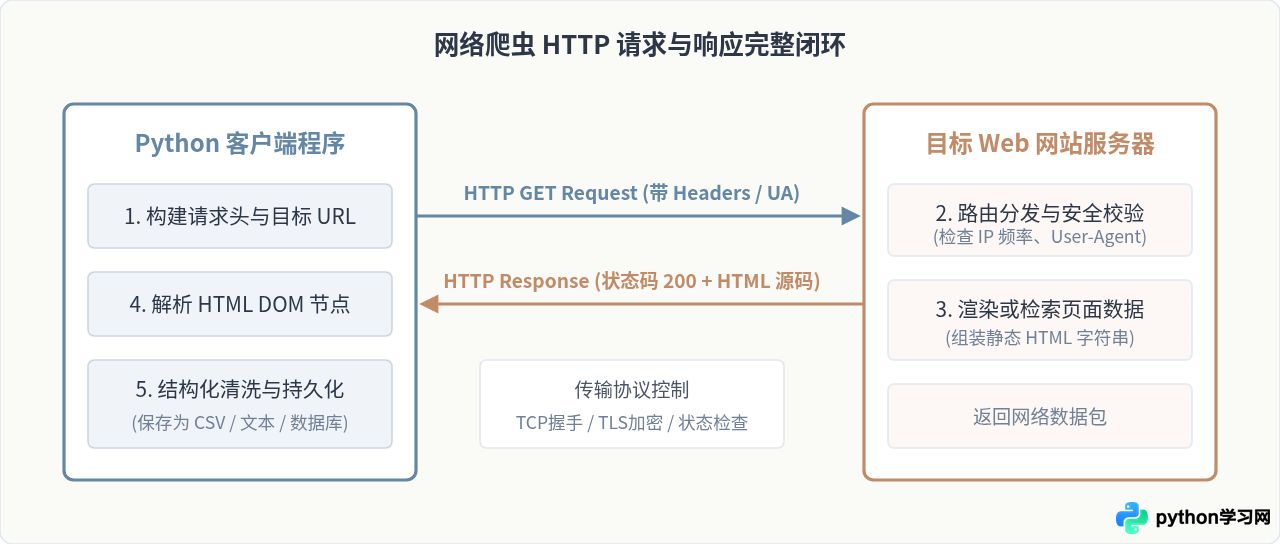
日常在浏览器中输入网址并按下回车时,浏览器会向目标服务器发送一个 HTTP GET 请求;服务器收到请求后返回对应的 HTML 网页代码,浏览器再将其渲染成图文并茂的页面。网络爬虫本质上是用程序替代人工操作,自动执行“发送请求 — 接收响应 — 提取数据”这套流程。
在这个过程中,Python 脚本扮演客户端角色。目标服务器并不直接感知背后是人还是代码,只要请求头、参数和行为特征符合 HTTP 协议规范,服务器就会如常返回网页源码。爬虫程序的关键步骤在于拿到响应文本后,通过文档对象模型(DOM)快速定位目标标签,截取所需字段。
二、开发环境搭建与基础依赖安装
编写爬虫前,需要保证操作系统中安装了 Python(建议 3.8 及以上版本),并在独立的虚拟环境中管理第三方库,防止不同项目的依赖版本相互干扰。
1. 确认 Python 与 pip 安装状态
打开终端(Windows 系统使用 PowerShell 或 CMD,macOS/Linux 使用 Terminal),执行以下命令验证 Python 版本:
python --version
pip --version
如果输出类似 Python 3.10.x 以及 pip 23.x,说明基础解释器与包管理工具已正常可用。
2. 创建隔离的工作虚拟环境
为当前项目新建一个独立的目录,并在其中创建名为 venv 的虚拟环境:
# 创建并进入项目目录
mkdir crawler_demo
cd crawler_demo

# 创建虚拟环境
python -m venv venv

# 激活虚拟环境 (Windows PowerShell)
.\venv\Scripts\Activate.ps1

# 激活虚拟环境 (macOS / Linux)
source venv/bin/activate
3. 安装核心抓取与解析依赖
入门阶段推荐使用两个经典的第三方库:
requests:专门负责发送 HTTP 网络请求,相比 Python 内置的urllib,语法更加直观简炼。beautifulsoup4:用于从返回的 HTML 文本中解析标签、提取文本与属性,适合处理静态网页结构。
pip install requests beautifulsoup4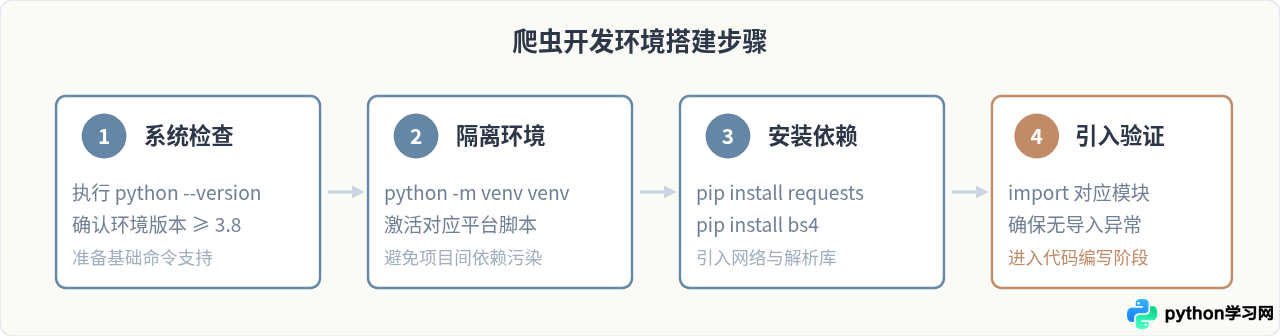
4. 导入测试与连通性验证
安装完成后,在终端中直接运行一行命令检验安装结果:
python -c "import requests, bs4; print('依赖环境安装就绪')"若屏幕打印出 依赖环境安装就绪 且无报错退出,说明基础运行环境已经完全就绪。
三、编写第一个抓取程序:从抓取到解析
为便于合规学习与稳定复现,本文选用专为爬虫教学设计的合规站点 quotes.toscrape.com 作为目标。该站点展示名言名句,结构清晰,非常适合用来掌握提取规则。
1. 目标网页结构拆解
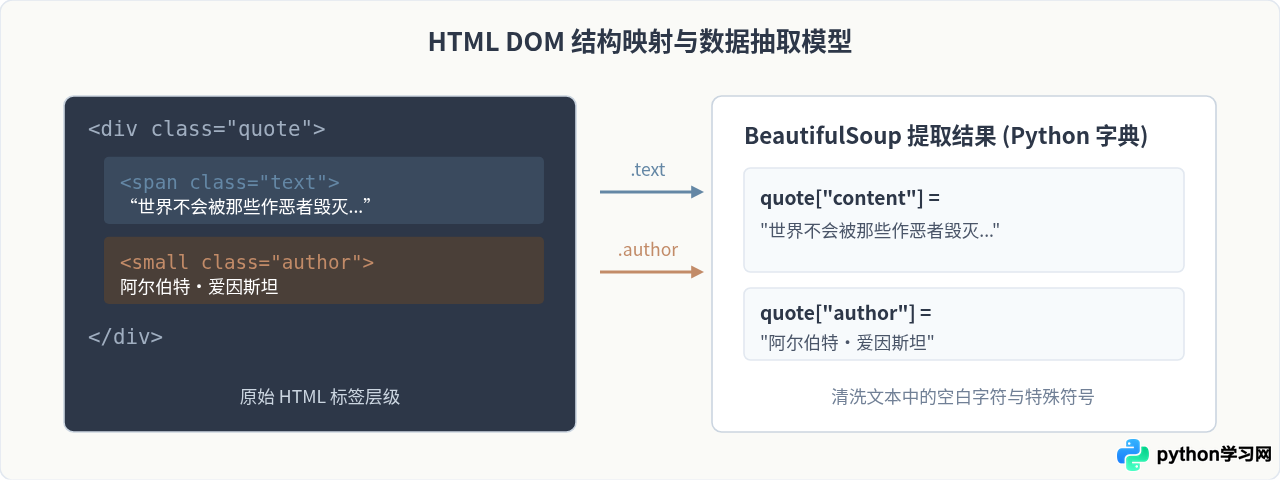
在浏览器中右键审查元素,可以看到每一条名言都包含在一个类名为 quote 的 <div> 容器内。名言文本在 <span class="text"> 中,作者名字在 <small class="author"> 中。
2. 编写完整抓取脚本
在项目目录中新建名为 first_crawler.py 的文件,写入以下完整代码:
import requests
from bs4 import BeautifulSoup

def crawl_quotes():
    # 1. 目标地址
    url = "https://quotes.toscrape.com/"

    # 2. 设置合法的 User-Agent 请求头,表明客户端身份
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/118.0.0.0 Safari/537.36"
        )
    }

    try:
        # 3. 发送网络请求,设置超时时间为 10 秒
        response = requests.get(url, headers=headers, timeout=10)

        # 4. 检查 HTTP 状态码,若非 200 会主动抛出异常
        response.raise_for_status()

        # 显式指定编码,防止中文字符解析乱码
        response.encoding = response.apparent_encoding

        # 5. 实例化 BeautifulSoup 对象
        soup = BeautifulSoup(response.text, "html.parser")

        # 6. 查询所有包含 quote 类名的 div 块
        quote_elements = soup.find_all("div", class_="quote")
        print(f"成功抓取网页,共找到 {len(quote_elements)} 条名言内容:\n")

        # 7. 遍历解析单个块中的文本与作者
        results = []
        for index, item in enumerate(quote_elements, start=1):
            text_el = item.find("span", class_="text")
            author_el = item.find("small", class_="author")

            # 安全取值,避免某些页面缺少字段导致空指针异常
            quote_text = text_el.get_text(strip=True) if text_el else "无内容"
            author = author_el.get_text(strip=True) if author_el else "未知作者"

            results.append({"author": author, "text": quote_text})
            print(f"[{index}] {author}: {quote_text}")

        return results

    except requests.exceptions.Timeout:
        print("错误:请求目标站点超时,请检查网络连接状态。")
    except requests.exceptions.HTTPError as err:
        print(f"错误:HTTP 响应状态码异常 - {err}")
    except requests.exceptions.RequestException as err:
        print(f"错误:请求发生未预期异常 - {err}")
    return []

if __name__ == "__main__":
    crawl_quotes()
3. 执行脚本与输出验证
在终端中直接执行:
python first_crawler.py终端中将输出提取到的名言内容(示例输出格式如下):
成功抓取网页,共找到 10 条名言内容:

[1] Albert Einstein: “The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”
[2] J.K. Rowling: “It is our choices, Harry, that show what we truly are, far more than our abilities.”
[3] Albert Einstein: “There are only two ways to live your life. One is as though nothing is a miracle. The other is as though everything is a miracle.”
...
四、新手常见报错与关键防坑措施
初学者在编写爬虫时经常遇到请求被拒或程序崩溃的情况。理解以下四点可以解决绝大部分入门阻碍:
| 现象 / 报错 | 核心产生原因 | 直接解决措施 |
|---|---|---|
HTTP 403 Forbidden |
服务器检测到 Python 默认的 User-Agent: python-requests/x.x 并直接拦截。 |
在 requests.get() 中传入包含主流浏览器标识的 headers 字典。 |
AttributeError: 'NoneType' object has no attribute 'get_text' |
网页上某个选择器没有匹配到标签,find() 返回了 None,直接调用方法导致崩溃。 |
先判断对象是否为 None,或改用 item.find(...) if ... else ... 三元条件判断。 |
| 抓取内容为乱码(如出现问号或乱字符) | 网页实际编码(如 GBK、GB2312)与 response.text 默认解码方式不一致。 |
在读取 text 前添加 response.encoding = response.apparent_encoding。 |
| 脚本运行长时间无响应并卡住 | 目标服务器无响应或网络丢包,且请求未设置超时上限。 | 调用时务必显式传入超时限制:requests.get(url, timeout=10)。 |
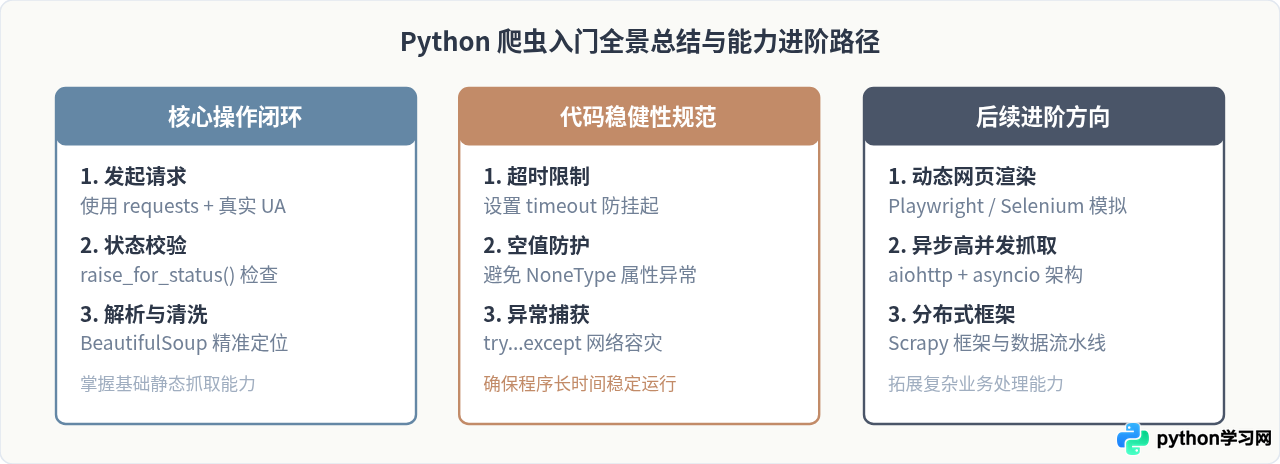
try...except 包裹 requests.exceptions.RequestException。任何网络环境都存在不可控的波动,避免脚本因为单次网络错误导致整个运行中断。
五、知识梳理与爬虫合规建议
完成环境搭建和第一个抓取程序只是爬虫学习的起点。在后续编写更复杂的抓取逻辑时,需要牢记三项基本准则:
- 遵守目标站点的 robots.txt:多数网站在根目录设有
/robots.txt,明确声明了允许与禁止爬取的路径。 - 限制并发与请求频率:切勿使用死循环高频请求服务器。每次请求间使用
time.sleep(1)适当休眠,避免对目标服务器造成过大负载。 - 尊重隐私与数据安全:严禁抓取涉及个人隐私、用户凭据、商业未公开数据或破坏系统鉴权的内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















