


Python常用函数分类详解:字符串、列表与字典操作
全面分类详解Python中字符串、列表与字典三大核心数据类型的常用内置函数与方法,涵盖语法细节、实战代码及常见避坑指南。
一、三类核心容器的本质差异与内存行为
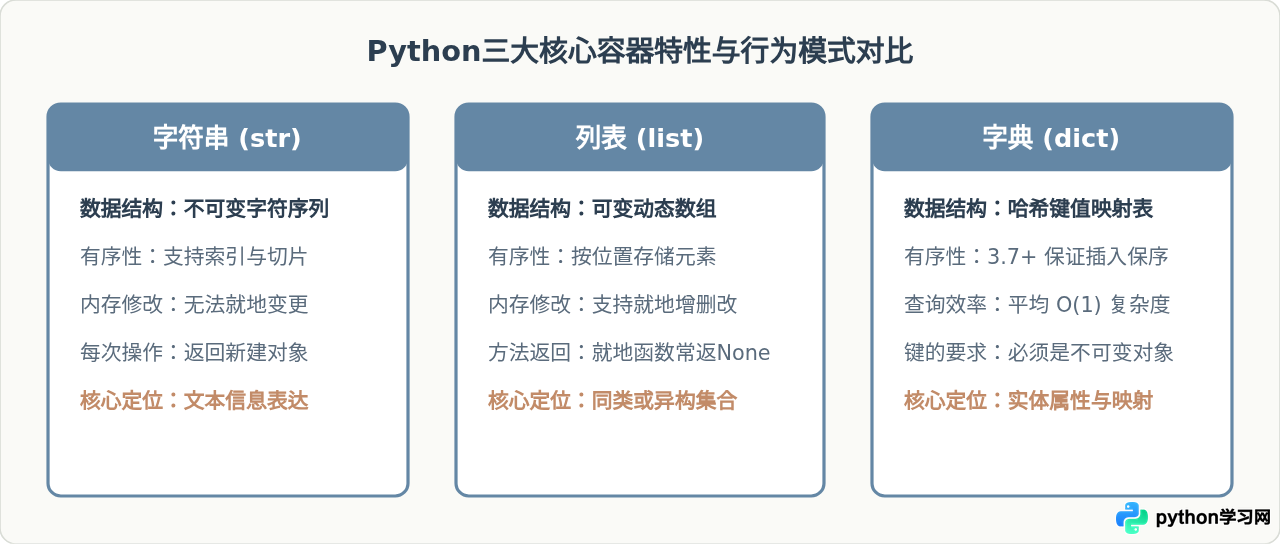
在深入具体函数之前,必须先理解三者在Python底层机制中的定位差异。字符串属于不可变序列,对它的任何变换操作都会生成一个全新的字符串对象;列表属于可变序列,允许在原有内存块上进行就地增删改;而字典则属于可变映射,依赖哈希表实现高效率的键值对检索。
二、字符串(str)常用函数与操作详解
字符串处理是日常清洗数据、解析配置或格式化输出最频繁的工作。根据功能特征,我们可以将其分为修剪清洗、切分拼接、查找替换与状态判断四大类。
1. 修剪与空白清洗:strip()、lstrip()、rstrip()
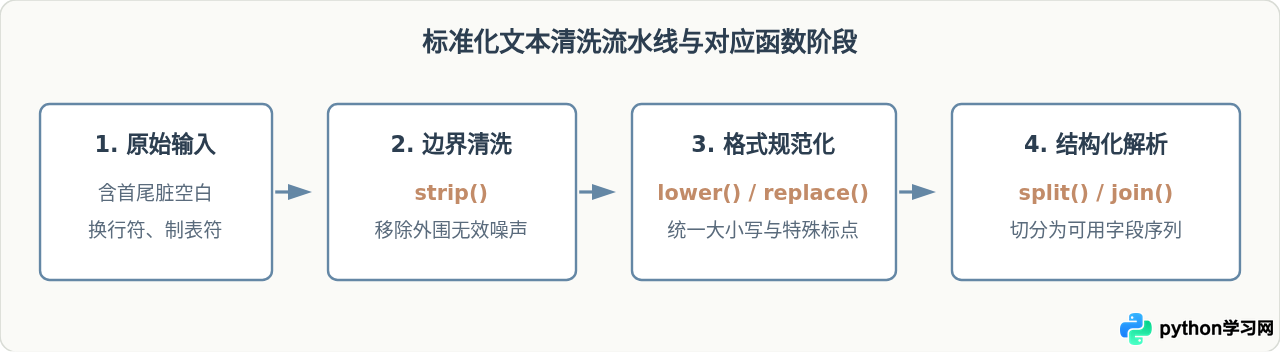
当读取外部文件或用户输入时,开头和结尾常常包含不可见的换行符 \n、制表符 \t 或多余空格。strip() 默认去除首尾所有空白字符。
raw_text = "  \n  Python Programming \t "
clean_text = raw_text.strip()
print(f"清洗结果: '{clean_text}'")  # 输出: 'Python Programming'

# 也可以指定剥除特定字符集合(按字符集匹配,非固定前缀)
url_path = "///api/v1/users///"
print(url_path.strip("/"))         # 输出: 'api/v1/users'
2. 切分与合并:split() 与 join()
split() 用于将字符串按指定分隔符切分为列表;而 join() 则是其反向操作,由分隔符对象调用,将可迭代对象中的字符串合并为单个大字符串。
# 按分隔符切分
tags_str = "python,data,backend,algorithm"
tags_list = tags_str.split(",")
print("切分后的列表:", tags_list)
# 输出: ['python', 'data', 'backend', 'algorithm']

# 使用特定连接符重新合并
rejoined_str = " | ".join(tags_list)
print("合并结果:", rejoined_str)
# 输出: 'python | data | backend | algorithm'+ 运算符反复拼接大量字符串,会导致频繁申请新内存空间(时间复杂度退化至 O(n²))。标准且高效的做法是先将分段存入列表,最后统一调用 "".join(list) 完成拼装。
3. 查找与替换:replace()、find() 与 index()
子串检索主要使用 find() 和 index()。两者的核心区别在于未找到匹配项时的应对方式:find() 返回 -1,而 index() 会抛出 ValueError 异常。内容替换则依靠 replace()。
msg = "Order status: PENDING, Order ID: 1042"

# 查找子串起点索引
pos = msg.find("Order ID")
print("查找结果位置:", pos)  # 输出: 23
print(msg.find("TIMEOUT"))   # 未找到,输出: -1

# 全局替换子串
updated_msg = msg.replace("PENDING", "COMPLETED")
print("更新后:", updated_msg)
# 输出: 'Order status: COMPLETED, Order ID: 1042'
4. 状态判断与大小写转换
常用判断方法包括 startswith()、endswith()、isdigit() 等,返回布尔值。格式归一化通常使用 lower() 和 upper()。
三、列表(list)常用函数与操作详解
列表是可变序列,最核心的操作围绕元素的增、删、改、查以及排序展开。在使用列表方法时,必须格外注意就地修改(In-place)与返回新副本的区别。
1. 元素新增:append()、extend() 与 insert()
append(x):将元素作为整体追加到列表尾部。extend(iterable):逐一解包可迭代对象并将每个元素加入尾部。insert(index, x):在指定索引前插入元素,由于引发后续元素位移,时间复杂度为 O(n)。
nums = [10, 20]
nums.append(30)          # nums 变为 [10, 20, 30]

nums.extend([40, 50])    # nums 变为 [10, 20, 30, 40, 50]
# 注意:如果写 nums.append([40, 50]),尾部会变成一个嵌套子列表

nums.insert(0, 99)       # 在索引0处插入,nums 变为 [99, 10, 20, 30, 40, 50]
print("操作后列表:", nums)
2. 元素删除:pop()、remove()、clear() 与 del
| 操作方式 | 作用对象 | 未找到时的行为 | 返回值 |
|---|---|---|---|
pop(index=-1) |
按索引弹出,默认弹出末尾 | 抛出 IndexError |
返回被弹出的元素 |
remove(value) |
按值删除第一个匹配项 | 抛出 ValueError |
返回 None(就地修改) |
clear() |
清空整个列表所有元素 | 安全清空 | 返回 None |
del lst[i] / del lst[a:b] |
按单索引或切片彻底删除 | 越界可能抛出 IndexError |
无返回值(语句) |
queue = ["task1", "task2", "task3"]
done_task = queue.pop(0)    # 弹出队首元素,返回 'task1'
print("已完成:", done_task)  # queue 此时为 ['task2', 'task3']

queue.remove("task2")       # 移除匹配的 'task2'
print("当前队列:", queue)    # queue 此时为 ['task3']
3. 排序与翻转:sort() vs sorted()
初学者极易混淆列表自带的方法 list.sort() 与全局内置函数 sorted():
list.sort(key=None, reverse=False):就地排序,直接重排当前列表,返回值为None。切忌写出res = lst.sort(),这会使res成为None。sorted(iterable, key=None, reverse=False):非就地排序,不改变原容器,生成并返回一个已排序的新列表。
scores = [88, 62, 95, 74]

# 方式一:就地修改原列表
scores.sort(reverse=True)
print("就地排序后:", scores)       # [95, 88, 74, 62]

# 方式二:生成新列表,保留原列表顺序
raw_scores = [88, 62, 95, 74]
sorted_scores = sorted(raw_scores)
print("新生成列表:", sorted_scores) # [62, 74, 88, 95]
print("原始列表未变:", raw_scores)  # [88, 62, 95, 74]
四、字典(dict)常用函数与操作详解
字典是Python中极其高效的关联容器。合理使用字典方法,关键在于提高代码在键缺失时的健壮性,以及高效遍历键值映射。
1. 安全读取:dict[key] 与 dict.get(key, default)
使用方括号直接访问 dict[key] 是最基础的写法,但在键不存在时会直接抛出致命的 KeyError。在键是否存在的场景不确定时,推荐优先使用 get() 方法,并明确提供兜底默认值。
config = {"host": "127.0.0.1", "port": 8080}

# 不安全写法:如果 key 不存在将崩溃
# timeout = config["timeout"]  # 抛出 KeyError: 'timeout'

# 安全写法:指定默认值
timeout = config.get("timeout", 30)
print("配置超时时间:", timeout)  # 键不存在,输出默认值: 30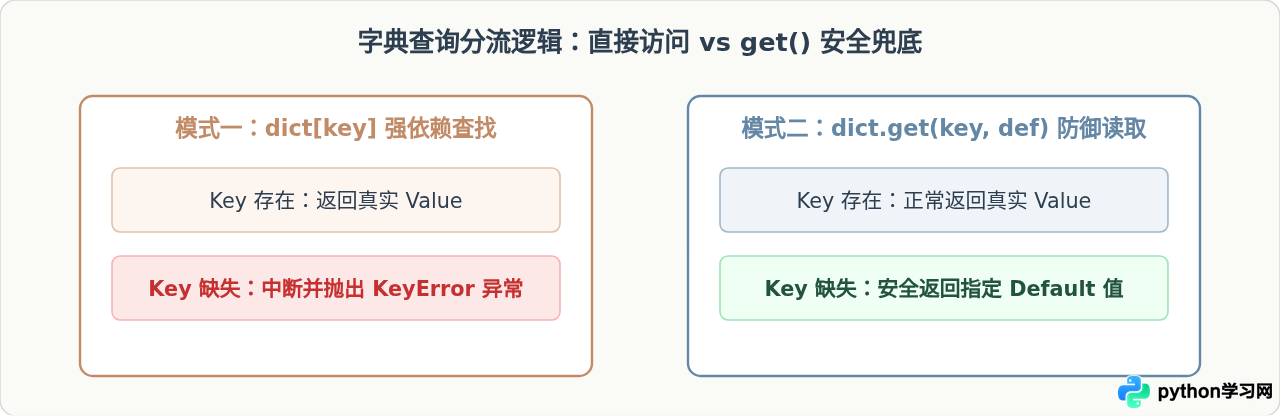
2. 视图与遍历:keys()、values() 与 items()
在遍历字典时,这三个方法返回的是动态视图对象(View Objects),不会在内存中生成新的完整列表,性能极高:
keys():返回键的视图集合。values():返回值的视图集合。items():返回(key, value)元组的视图,常用于同时解包键与值。
user_profile = {"id": 101, "name": "Alice", "role": "Developer"}

# 推荐写法:使用 items() 优雅遍历
for k, v in user_profile.items():
    print(f"字段 [{k}] -> 内容: {v}")
3. 初始化与批量更新:setdefault() 与 update()
setdefault(key, default) 常用于分类统计。如果键已存在,直接返回其对应值;如果不存在,则将该键赋值为 default 并将其返回。
update(other_dict) 用于合并另一个字典或键值对序列。如果有重名键,以传入的新值为准覆盖原值。
# 分组聚合示例
categories = {}
items = [("fruit", "apple"), ("vegetable", "carrot"), ("fruit", "banana")]

for cat, name in items:
    # 如果类别不存在,默认设置空列表,并立即调用 append
    categories.setdefault(cat, []).append(name)

print("分组结果:", categories)
# 输出: {'fruit': ['apple', 'banana'], 'vegetable': ['carrot']}

# 批量更新配置
current_config = {"env": "prod", "debug": False}
patch = {"debug": True, "workers": 4}
current_config.update(patch)
print("更新后配置:", current_config)
# 输出: {'env': 'prod', 'debug': True, 'workers': 4}
五、常见避坑指南与综合对比
在混合操作这三种数据类型时,以下三个经典陷阱是引发线上异常的高发区,需格外留意:
-
不要在遍历列表或字典的同时增删其元素:
直接在for item in my_list:中调用my_list.remove(item)会导致迭代器指针偏移,遗漏部分元素;对字典遍历时直接增删键则会触发RuntimeError: dictionary changed size during iteration。正确方案是遍历其浅拷贝list(my_dict.keys())或使用列表推导式生成新容器。 -
不可将可变对象(如列表)作为函数的默认参数:
Python中函数的默认参数在定义时只求值一次。若写成def append_item(val, target=[]):,多次调用会复用同一个列表对象。正确做法是用target=None作为默认值,函数内部再进行if target is None: target = []的初始化。 -
字典的键必须可哈希(不可变):
列表与字典自身都不能作为字典的键,尝试使用{['id']: 1}会立即引发TypeError: unhashable type: 'list'。若需要复合键,应使用元组(id_val, type_val)代替。
总结
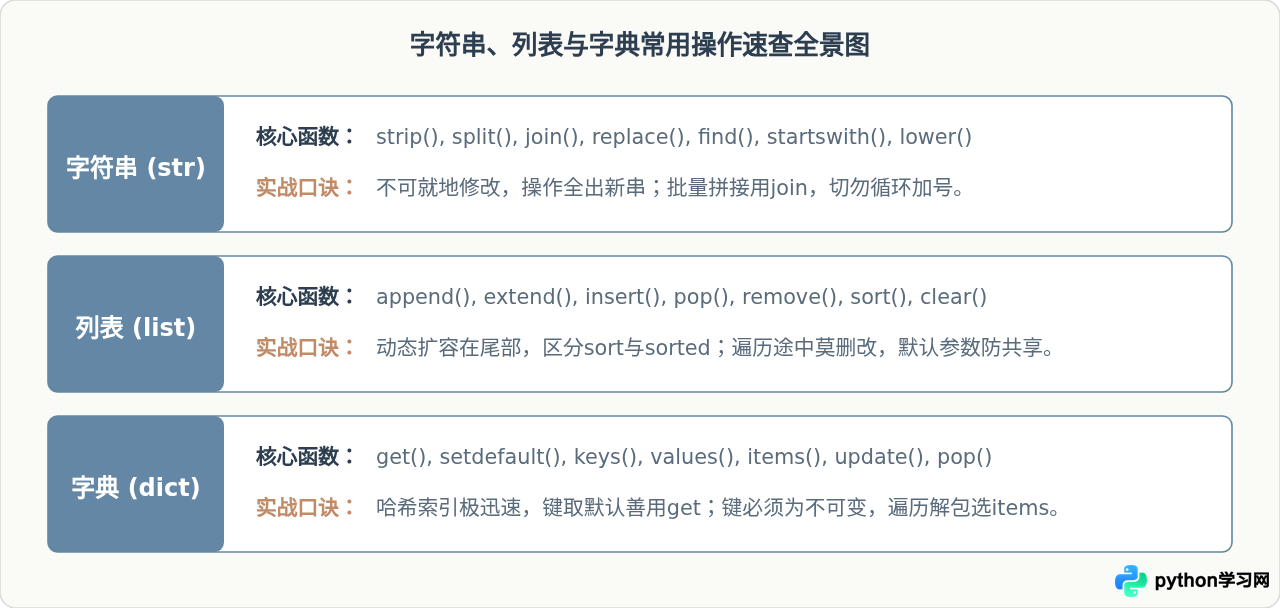
字符串、列表和字典分别代表了不可变文本、可变有序集合与可变映射关系。在日常开发中,理解它们的数据模型是正确选择操作方法的前提。规范使用 join() 优化拼接、分清 sort() 原地操作与 sorted() 副本生成的差异、善用 get() 与 setdefault() 预防缺失键异常,能让代码兼具高效性与健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















