


Python文件读写基础练习题参考答案
针对Python初学者常见的文件读写基础练习题提供完整参考答案与详细代码解析,涵盖基础文本写入、大文件逐行读取、结构化数据处理及异常处理机制。
练习一:文本文件的创建与内容写入
编写一段代码,在当前目录下创建一个名为 records.txt 的文本文件,写入三行学习任务计划;写入完成后,使用追加模式向该文件末尾再补充一条已完成状态的记录。要求:编码必须为 UTF-8,全程必须使用安全资源管理机制。
参考解答
# 练习一参考答案:创建、写入与追加内容
from pathlib import Path

file_path = Path("records.txt")

# 1. 覆盖写入(模式 'w')
initial_tasks = [
    "1. 掌握 open 函数与 with 上下文管理器\n",
    "2. 理解 r、w、a 模式与指针移动\n",
    "3. 练习逐行处理大文件的方法\n"
]

with open(file_path, mode="w", encoding="utf-8") as file:
    file.writelines(initial_tasks)

# 2. 追加写入(模式 'a')
extra_task = "4. [已完成] 掌握 FileNotFoundError 异常捕获\n"

with open(file_path, mode="a", encoding="utf-8") as file:
    file.write(extra_task)

print(f"文件写入成功,保存位置: {file_path.resolve()}")
代码解析与关键机制
初学者在处理文件读写时最容易犯的错误是直接调用 f = open(...) 并在末尾手动写 f.close()。如果在中间发生程序异常或提前返回,文件句柄可能无法及时释放,导致资源泄漏或写入缓冲区未刷盘。
使用 with open(...) as file: 语句遵循了 Python 的上下文管理器协议。无论代码块内部发生何种异常,解释器都会在退出代码块时自动调用 file.close(),确保系统文件句柄被即刻回收。
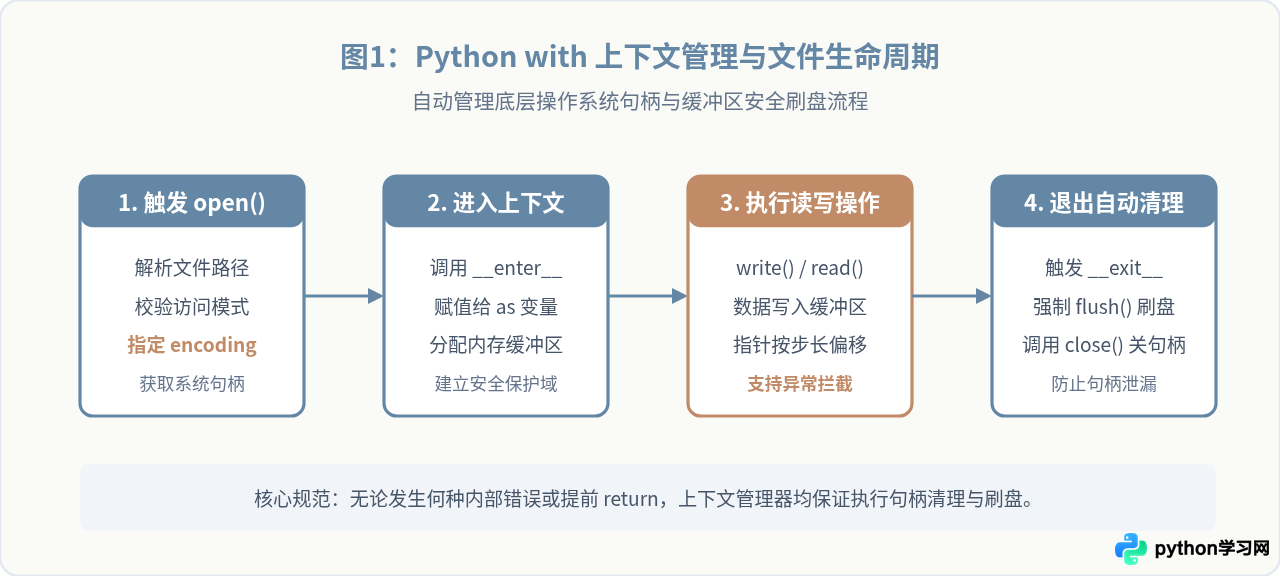
with 语句完整生命周期与资源调度流程"w" 在打开已存在的文件时,会立即将文件长度截断为 0(即瞬间清空原文件所有内容)。若意图保留原有内容并在末尾新增,务必切换为模式 "a"(append)。
练习二:大文件高效逐行读取与关键词统计
假设存在一个体积较大的服务器日志文件 app.log,请编写一个函数 count_keyword_occurrences(file_path, keyword),统计该关键字在日志中出现的行数,并将包含该关键词的前三条日志内容打印出来。要求:内存占用必须恒定,严禁一次性加载整个文件到内存。
参考解答
# 练习二参考答案:低内存消耗的逐行迭代处理
def count_keyword_occurrences(file_path: str, keyword: str) -> int:
    matched_count = 0
    preview_samples = []

    # 直接对文件句柄进行迭代,每次只加载当前行
    with open(file_path, mode="r", encoding="utf-8") as file:
        for line_num, line in enumerate(file, start=1):
            if keyword in line:
                matched_count += 1
                if len(preview_samples) < 3:
                    # 去除行末多余换行符后加入预览
                    preview_samples.append((line_num, line.rstrip("\r\n")))

    print(f"统计完成:关键字 '{keyword}' 共在 {matched_count} 行中出现。")
    if preview_samples:
        print("前 3 条匹配样本如下:")
        for num, text in preview_samples:
            print(f"  [第 {num} 行] {text}")

    return matched_count

# 测试运行(假设 app.log 已存在)
if __name__ == "__main__":
    count_keyword_occurrences("app.log", "ERROR")
代码解析与读取方法对比
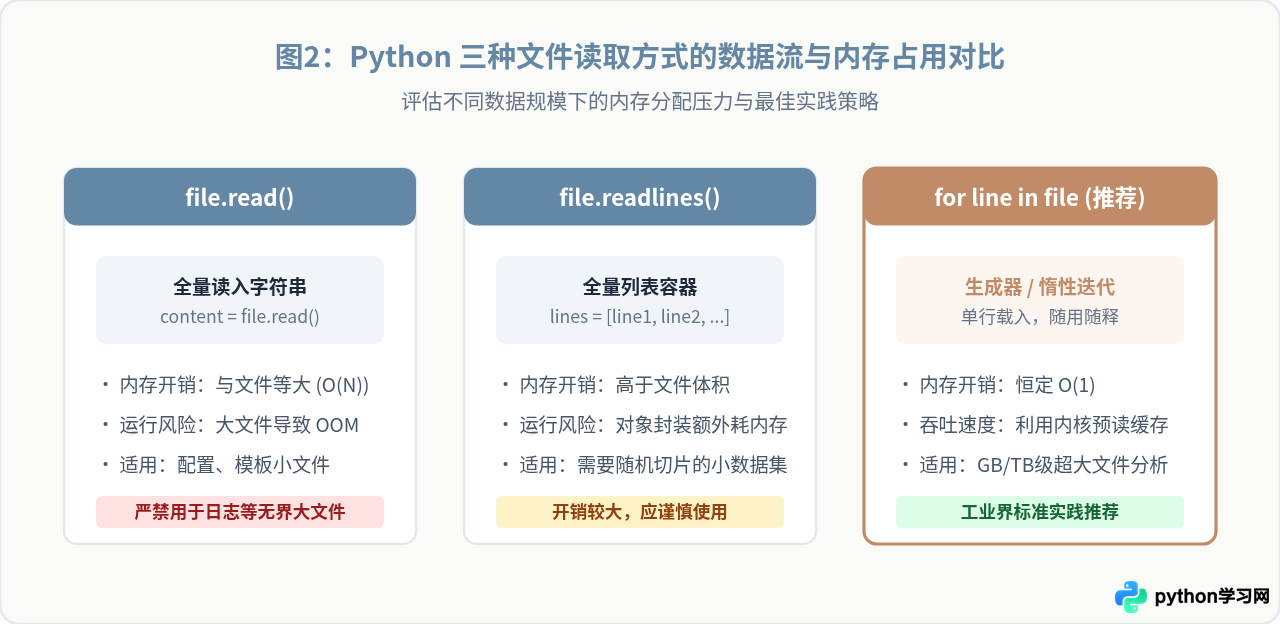
Python 提供了多种读取文本内容的方法,初学者常常混淆它们的执行开销:
file.read():一次性读取全部文件内容,返回一个长字符串。如果文件为 10GB,程序会瞬间申请超过 10GB 内存,极易引发MemoryError。file.readlines():将所有行全部读取并切分为列表返回。虽然便于按索引读取,但同样一次性加载全量数据,内存开销巨大。for line in file:(推荐):Python 的文件对象原生实现了迭代器协议。每次循环从操作系统内核缓冲区读取一行字符串,处理完后即可由垃圾回收器回收,内存复杂度恒定为 O(1)。
练习三:结构化文本与常用文件访问模式分析
编写程序将结构化学生成绩写入 scores.csv(字段包含:姓名、科目、分数),随后重新以读写增强模式(如 r+)读取所有数据,统计并输出每位同学的总分与平均分,最后在文件末尾写入统计汇总段。
参考解答
# 练习三参考答案:结构化读写与文件指针控制
import csv
from pathlib import Path

csv_file = Path("scores.csv")

# 1. 初始数据准备
records = [
    ["姓名", "科目", "分数"],
    ["张明", "Python", "92"],
    ["张明", "算法", "88"],
    ["李华", "Python", "95"],
    ["李华", "算法", "90"]
]

with open(csv_file, mode="w", encoding="utf-8", newline="") as file:
    writer = csv.writer(file)
    writer.writerows(records)

# 2. 读取数据并统计
scores_map = {}
with open(csv_file, mode="r", encoding="utf-8") as file:
    reader = csv.reader(file)
    header = next(reader)  # 跳过表头
    for row in reader:
        if not row:
            continue
        name, subject, score_str = row
        score = float(score_str)
        scores_map.setdefault(name, []).append(score)

# 3. 追加汇总结果
with open(csv_file, mode="a", encoding="utf-8", newline="") as file:
    writer = csv.writer(file)
    writer.writerow([])  # 空行分隔
    writer.writerow(["# 统计汇总", "课程数", "平均分"])
    for name, score_list in scores_map.items():
        avg_score = sum(score_list) / len(score_list)
        writer.writerow([name, len(score_list), f"{avg_score:.2f}"])

print("结构化 CSV 处理完成并成功写入统计数据。")
代码解析与模式选择指南
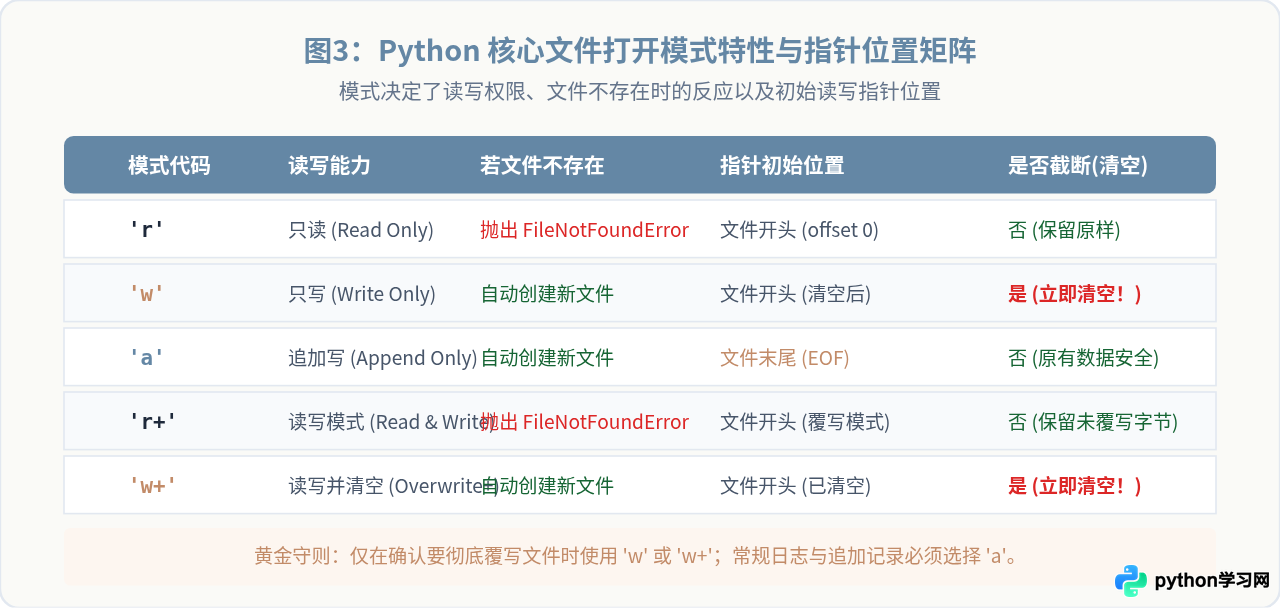
Python 中 open() 的模式参数决定了对文件的读写权限以及文件指针(file pointer)的初始位置。很多初学者误以为 r+ 与 w+ 相似,实际上 w+ 同样会在打开瞬间截断清空文件。
练习四:路径安全校验与健壮的异常捕获体系
编写一个安全的文件读取封装函数 safe_read_text(file_path, default=""),能够优雅处理文件不存在、权限不足、编码解码失败等异常情况。在出现异常时输出明确的人性化排查指引,并返回默认值,避免程序直接崩溃退出。
参考解答
# 练习四参考答案:多维度防御性文件异常处理
from pathlib import Path
from typing import Optional

def safe_read_text(file_path_str: str, default: str = "") -> str:
    path = Path(file_path_str)

    # 1. 前置防御:检查路径是否存在以及是否为常规文件
    if not path.exists():
        print(f"[提示] 文件未找到:'{path.resolve()}',请检查路径拼写。")
        return default

    if not path.is_file():
        print(f"[警告] 目标路径不是有效文件(可能为目录):'{path}'。")
        return default

    # 2. 运行时异常捕获处理
    try:
        with open(path, mode="r", encoding="utf-8") as file:
            return file.read()
    except FileNotFoundError:
        print(f"[错误] 打开时文件丢失:{path}")
        return default
    except PermissionError:
        print(f"[权限错误] 当前运行进程缺乏对文件 '{path}' 的读取权限。")
        return default
    except UnicodeDecodeError as err:
        print(f"[编码错误] 文件可能非 UTF-8 编码或为二进制文件(位置: {err.start})。")
        return default
    except OSError as err:
        print(f"[系统级I/O错误] 处理文件时发生未知异常:{err}")
        return default

# 测试案例
if __name__ == "__main__":
    content = safe_read_text("non_existent_file.txt", default="[EMPTY]")
    print(f"安全读取结果: {content}")
代码解析与异常分类
处理外部文件时,“程序必须预料到文件随时可能不存在或无法访问”。Python 官方推荐遵循 EAFP(Easier to Ask for Forgiveness than Permission,即“宁求事后宽恕,不求事前许可”)哲学:通过 try...except 捕获具体异常,而不是通过写大量 if 语句尝试排查所有物理硬件状态。
常见的异常继承关系如下:FileNotFoundError 与 PermissionError 均继承自 OSError。在编写 except 分支时,必须将子类异常排在前面,父类异常放在后面,防止精确异常被基类分支截获。
总结:Python 文件读写核心自查体系
完成上述练习题后,读者应当能够形成清晰、安全的文件处理心智模型。在日常编码与项目交付中,建议参照以下自查要点进行代码审查:
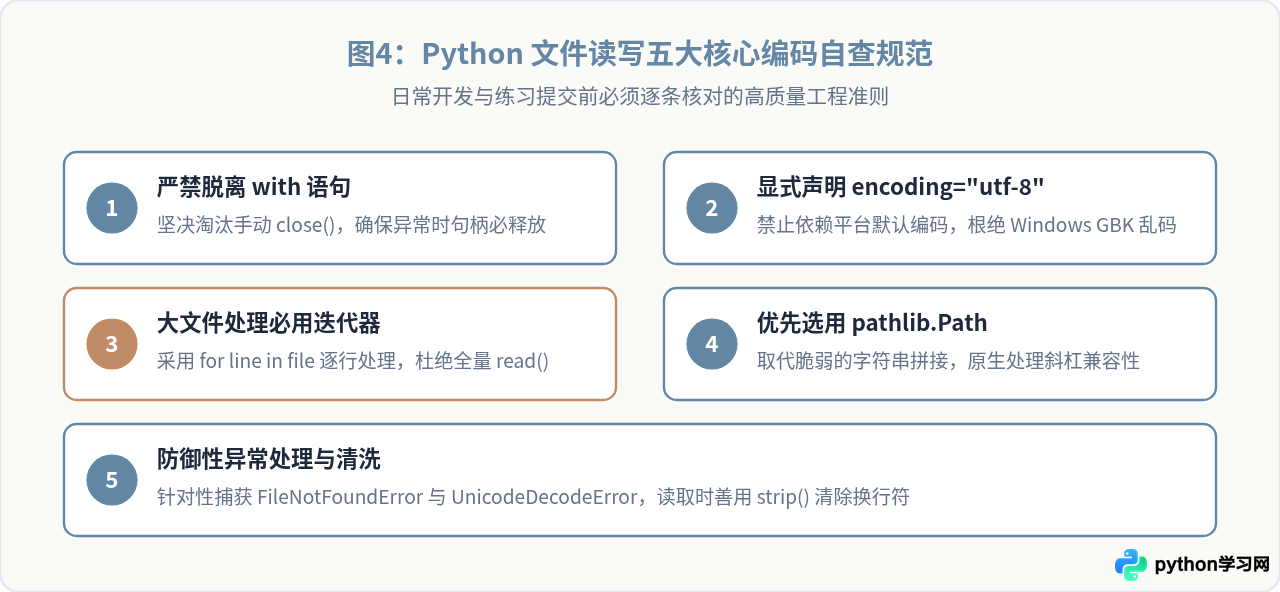
通过这四道典型练习题与核心机制的对比学习,读者不仅可以写出能够成功运行的解题代码,更能建立起面对工业级生产环境时的代码健壮性意识。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















