


Python怎么利用切片提取子串和子列表
深入讲解Python中如何利用切片语法[start:stop:step]提取子串与子列表,涵盖正负索引机制、左闭右开区间、步长反转、浅拷贝特性、边界容错机制与常见避坑指南。
sequence[start:stop:step]。切片遵循“左闭右开”的区间规则与自动容错机制,不仅能以极高执行效率完成数据截取、反转与采样,还不会因索引边界轻微超出范围而引发程序崩溃。本文将系统拆解切片的运行机制、正负索引转换规律、步长控制逻辑,并针对子串与子列表的深浅拷贝差异提供实用范例与避坑建议。
一、切片基本语法与索引切点模型
Python 中的字符串(str)、列表(list)与元组(tuple)都属于序列(Sequence)数据结构。切片表达式的标准格式为:
sequence[start:stop:step]这三个参数均由冒号分隔,其各自职责与取值含义如下:
- start(起始索引):切片截取的起点位置。包含该位置对应的元素。缺省时默认为序列头部(正步长时为 0)。
- stop(结束索引):切片截取的终点边界。不包含该位置的元素,即数学上的左闭右开区间
[start, stop)。缺省时默认为序列末尾。 - step(步长):每次截取元素的前进距离与方向。默认值为
1。若为正数表示从左向右提取;若为负数表示从右向左反向提取。
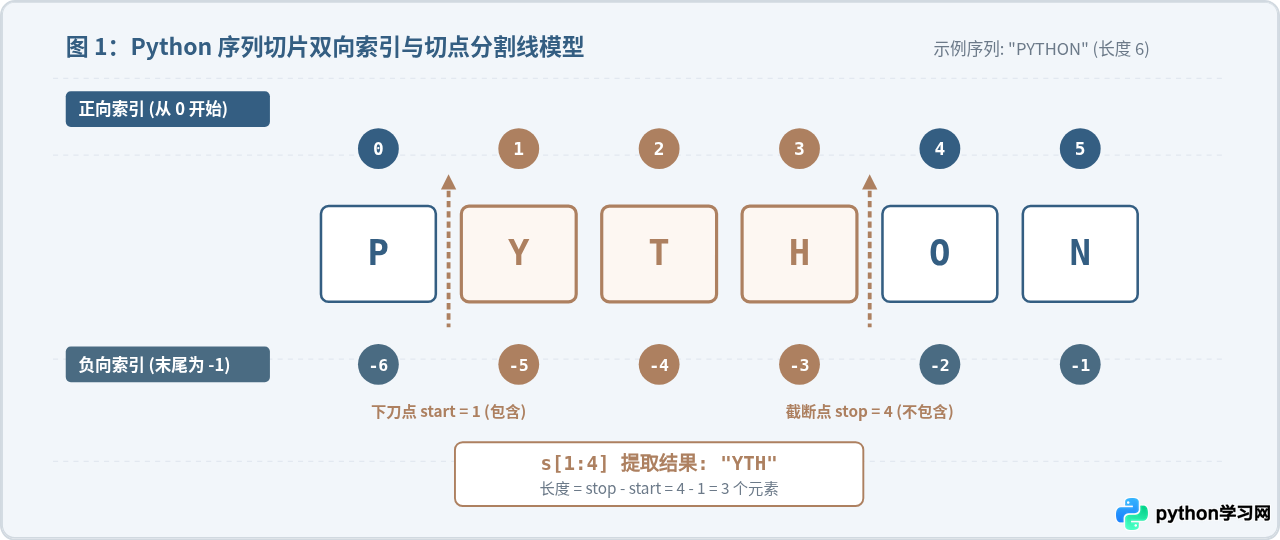
理解左闭右开区间的最佳思维模型是“切点分割线”:把索引看作字符之间的缝隙编号,而不是字符本身的方格。从缝隙 start 沿着缝隙 stop 下刀,切出的元素数量恰好等于 stop - start。
二、提取字符串子串的常用方式
字符串是 Python 中典型的不可变序列。利用切片可以快速获取任意位置的子串,主要场景包括固定区段截取、前缀/后缀提取、间隔跳跃提取以及整串反转。
1. 截取固定区段
指定起始和结束位置,提取中间一段连续字符:
text = "DataScience2026"
# 提取索引 4 到 11 前一位的字符
sub = text[4:11]
print("sub:", sub)2. 省略边界:提取前缀或后缀
当需要从序列开头截取,或者一直截取到末尾时,可以省略 start 或 stop:
text[:n]:提取前n个字符(从索引 0 到 n-1)。text[m:]:从索引m开始截取,一直到字符串末尾。text[:]:省略两端边界,获得与原字符串内容相同的全切片。
filename = "report_q3_final.csv"
prefix = filename[:6]     # 截取前6个字符
ext = filename[-4:]       # 截取最后4个字符(后缀名)

print("prefix:", prefix)
print("ext:", ext)ext: .csv
3. 设置步长:奇偶位置抽样与跳跃提取
第三个参数 step 用于控制步进跨度。例如 step=2 表示隔一个字符取一个:
code = "A1B2C3D4E5"
letters = code[::2]   # 提取偶数位字符
digits = code[1::2]   # 从索引1开始提取奇数位字符

print("letters:", letters)
print("digits:", digits)digits: 12345
4. 负步长:快速反转字符串
将步长设为 -1,且省略 start 和 stop 时,Python 会从最后一个字符倒序遍历至第一个字符,达到反转字符串的效果:
word = "level-up"
reversed_word = word[::-1]
print("reversed:", reversed_word)三、提取与操作子列表的实用技巧
与字符串不同,列表是可变序列。在列表上使用切片不仅可以提取子列表,还可以通过切片赋值实现原位批量替换、插入与删除元素。
1. 提取子列表与浅拷贝(Shallow Copy)机制
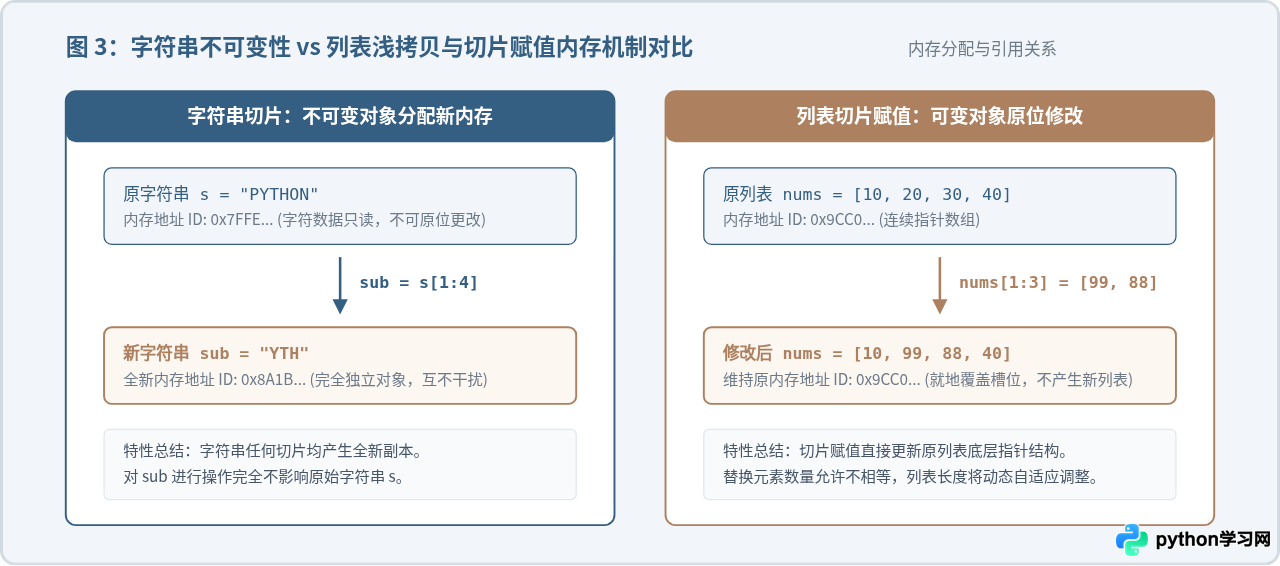
通过切片截取列表会创建一个全新的列表对象,但新列表中存储的元素引用仍然指向原列表中的对象:
scores = [92, 85, 99, 74, 88, 95, 68]
# 提取前3名成绩
top3 = scores[:3]
# 提取中间段成绩
middle = scores[2:5]

print("top3:", top3)
print("middle:", middle)
print("是否同一对象:", top3 is scores)middle: [99, 74, 88]
是否同一对象: False
对新列表 top3 增删元素,完全不会影响原列表 scores。但如果列表中嵌套了子列表或字典等可变对象,切片仅复制外层容器(浅拷贝),内部对象修改会相互关联。
2. 切片赋值:原地替换、插入与删除元素
当切片表达式出现在等号左边时,即为切片赋值(Slice Assignment)。这是列表特有的强大能力:
nums = [10, 20, 30, 40, 50]

# 1. 批量替换:将索引 1 到 3 的部分替换为新列表(长度无需一致)
nums[1:3] = [88, 99, 100]
print("替换后:", nums)

# 2. 原位插入:在索引 2 处插入元素(切片区间长度为0)
nums[2:2] = [777]
print("插入后:", nums)

# 3. 批量删除:将切片赋值为空列表,或使用 del 语句
nums[1:4] = []
print("删除后:", nums)插入后: [10, 88, 777, 99, 100, 40, 50]
删除后: [10, 100, 40, 50]
nums[::2] = [1, 2]),等号右侧序列的长度必须严格等于左侧切片提取出的位置数量,否则 Python 会抛出 ValueError: attempt to assign sequence of size X to extended slice of size Y 异常。
四、步长方向与边界计算的核心规则
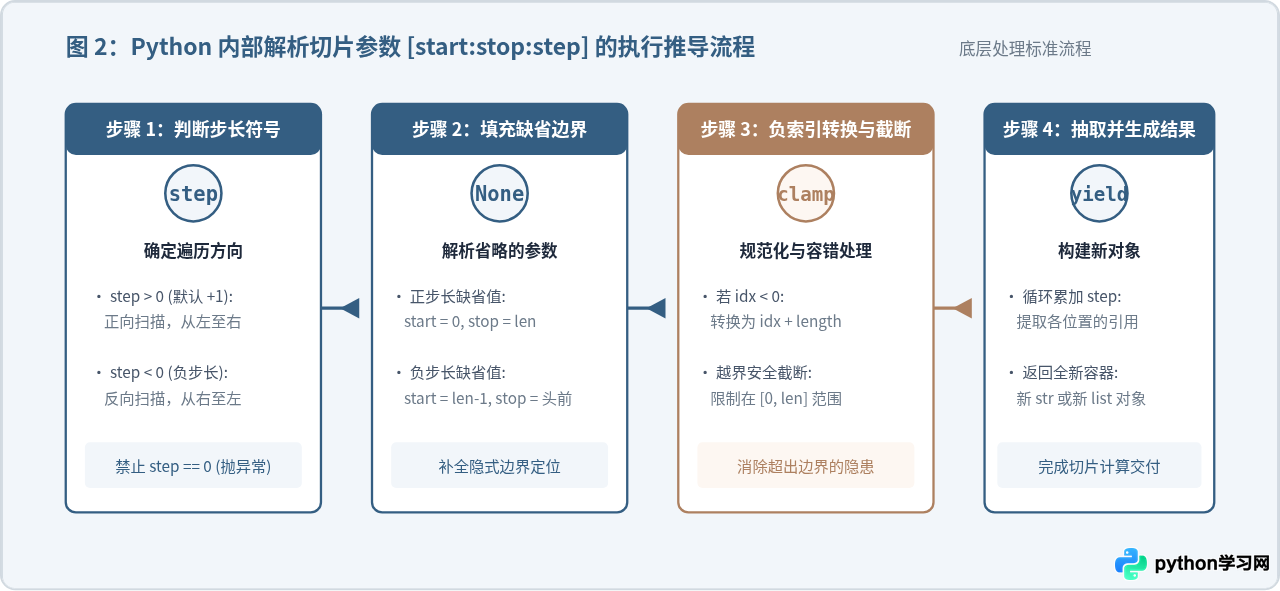
很多开发者在刚接触负步长时经常会截出空字符串或空列表。这是因为当步长变为负数时,提取方向与边界默认值发生了本质变化。
1. 正步长与负步长的方向对比
- 正步长(step > 0):从左向右移动。要求
start < stop才能截取到元素;若start >= stop,返回空序列""或[]。 - 负步长(step < 0):从右向左移动。要求
start > stop才能截取到元素;若start <= stop,返回空序列。
chars = ['a', 'b', 'c', 'd', 'e']

# 正步长正常截取
print("正向:", chars[1:4:1])

# 错误写法:负步长但起点在终点左侧,无法向左移动,得到空列表
print("错误颠倒:", chars[1:4:-1])

# 正确写法:起点在右侧,终点在左侧
print("负步长正确:", chars[4:1:-1])错误颠倒: []
负步长正确: ['e', 'd', 'c']
2. 包含头尾时负步长的边界省略原则
当使用负步长想从末尾一直截取到索引 0 处(包含第一个元素)时,切勿将 stop 设为 0。因为左闭右开规则会导致索引 0 被排除在外:
s = "ABCDE"
# 错误示范:stop=0 导致字符 'A' 无法被取到
print("漏掉首字符:", s[4:0:-1])

# 正确示范:将 stop 留空,Python 会自动延伸至序列起始端点
print("完整反向包含首字母:", s[4::-1])完整反向包含首字母: EDCBA
五、切片的安全容错特性与越界处理
在 Python 中,单元素索引与切片截取在对待“索引越界”时有着完全不同的设计策略:
| 访问方式 | 示例代码 | 越界时的表现 | 典型适用场景 |
|---|---|---|---|
| 单元素下标访问 | s[100] |
抛出 IndexError: string index out of range 异常,程序中断 |
明确要求元素必须存在,越界视为严重逻辑错误 |
| 切片区间访问 | s[:100] |
自动截断到实际有效边界,永不抛出 IndexError | 不确定数据具体长度,要求平稳截取可用部分 |
这一特性在处理不定长文本或数据清洗时极为安全。例如,无论用户输入的字符串是 3 个字还是 300 个字,使用 text[:10] 都能安全拿到“最多前 10 个字符”,无需繁琐的 len() 长度判断:
short_str = "Hi"
# 即使指定的结束索引远远超出实际长度,切片也会优雅截取到末尾
safe_sub = short_str[0:50]
print("safe_sub:", safe_sub)
print("超出起始边界:", short_str[10:20])超出起始边界:
六、进阶技巧:利用 slice() 对象复用切片规则
方括号切片语法 sequence[start:stop:step] 实际上是 Python 内置 slice() 类的语法糖。当在多处需要截取相同固定列(如解析固定宽度的文本日志、CSV 导出文件)时,构造命名的 slice 对象可以显著提升代码的可读性与复用性:
# 定义固定宽度的日志字段切片规则
DATE_SLICE = slice(0, 10)
LEVEL_SLICE = slice(11, 16)
MSG_SLICE = slice(17, None)  # None 相当于省略 stop,截取到末尾

log_line = "2026-10-29 ERROR Database connection pool exhausted"

log_date = log_line[DATE_SLICE]
log_level = log_line[LEVEL_SLICE]
log_msg = log_line[MSG_SLICE]

print("日期:", log_date)
print("级别:", log_level)
print("信息:", log_msg)级别: ERROR
信息: Database connection pool exhausted
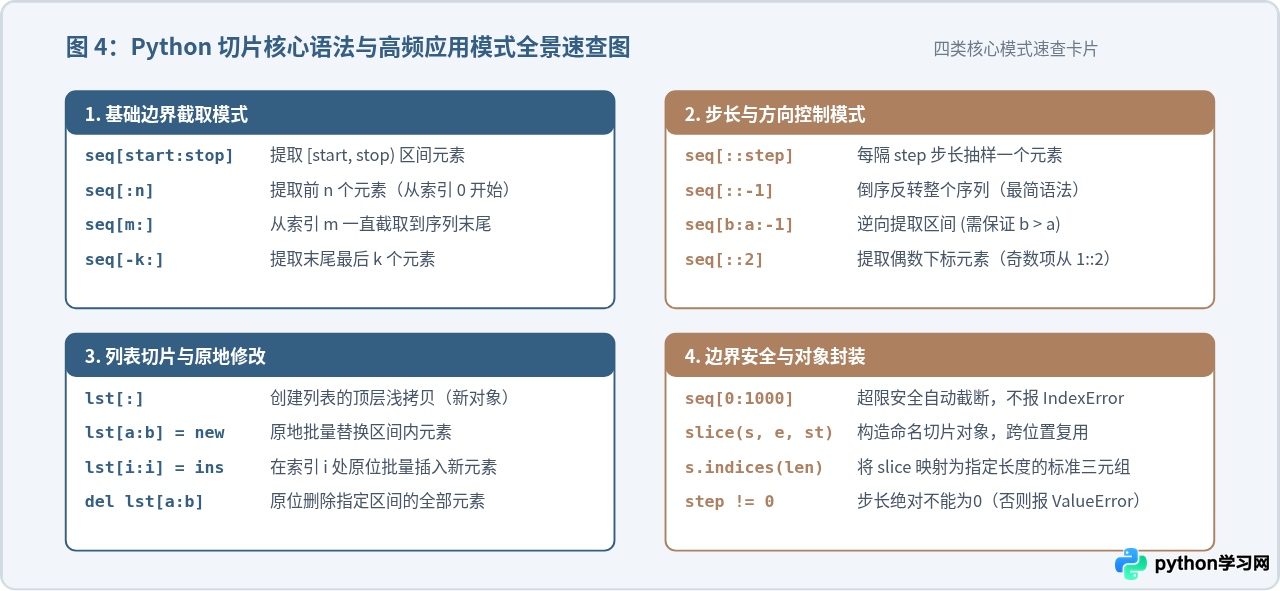
七、总结
Python 切片语法 sequence[start:stop:step] 提供了一种统一、精炼且性能极高的序列提取手段。掌握切片的核心在于三点:第一,牢记“左闭右开”的切点分割线原理,截取长度直接由 stop - start 决定;第二,明确正负步长决定了扫描方向与省略边界时的默认端点;第三,区分字符串(不可变、每次生成新串)与列表(可变、切片读取浅拷贝、切片赋值原地改写)的本质差异。在日常编码中,合理运用切片不仅能替代繁琐的循环遍历,还能借助其越界截断特性写出更加健壮的程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















