


零基础Python自学路线图:从环境搭建到项目实战
专为零基础读者撰写的Python自学实用路线图,详细梳理官方安装包与VS Code配置、Python核心语法体系、典型认知误区辨析以及独立编写自动化清洗脚本的完整实战路径。
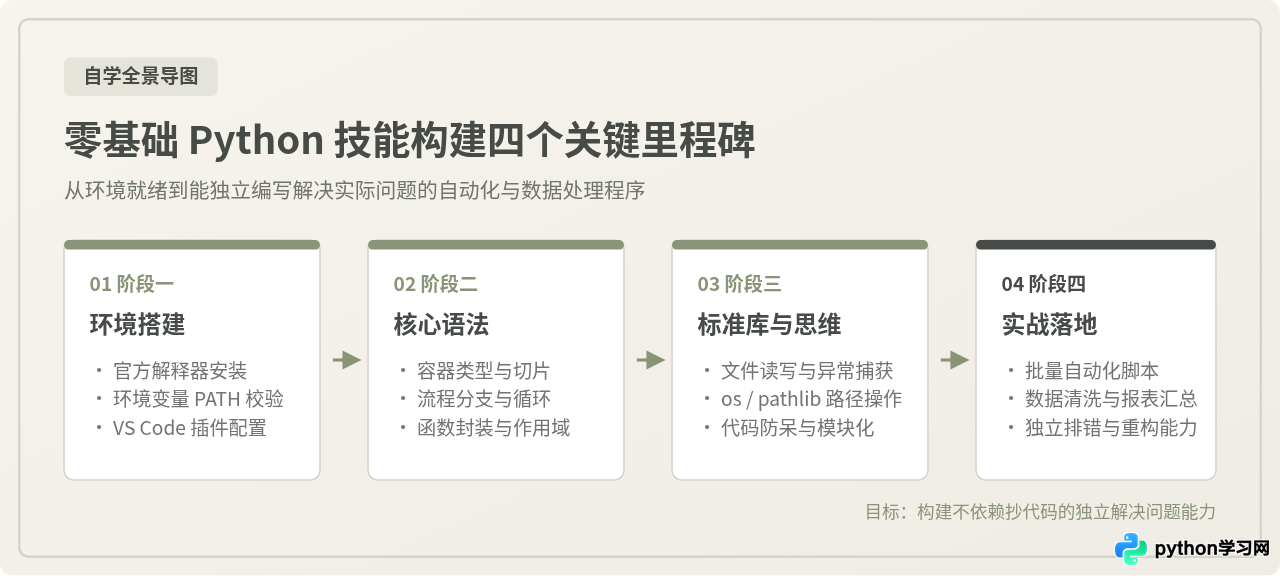
一、总体学习路线与时间周期规划
很多初学者自学失败的原因,在于把编程当成一门像文科考试一样的记忆性学科,试图把变量、类、元组等所有细枝末节背熟后再动手。实际上,编程是一门纯粹的工科技能,只有当语法用来操作具体数据、完成实际任务时,才能真正被理解。
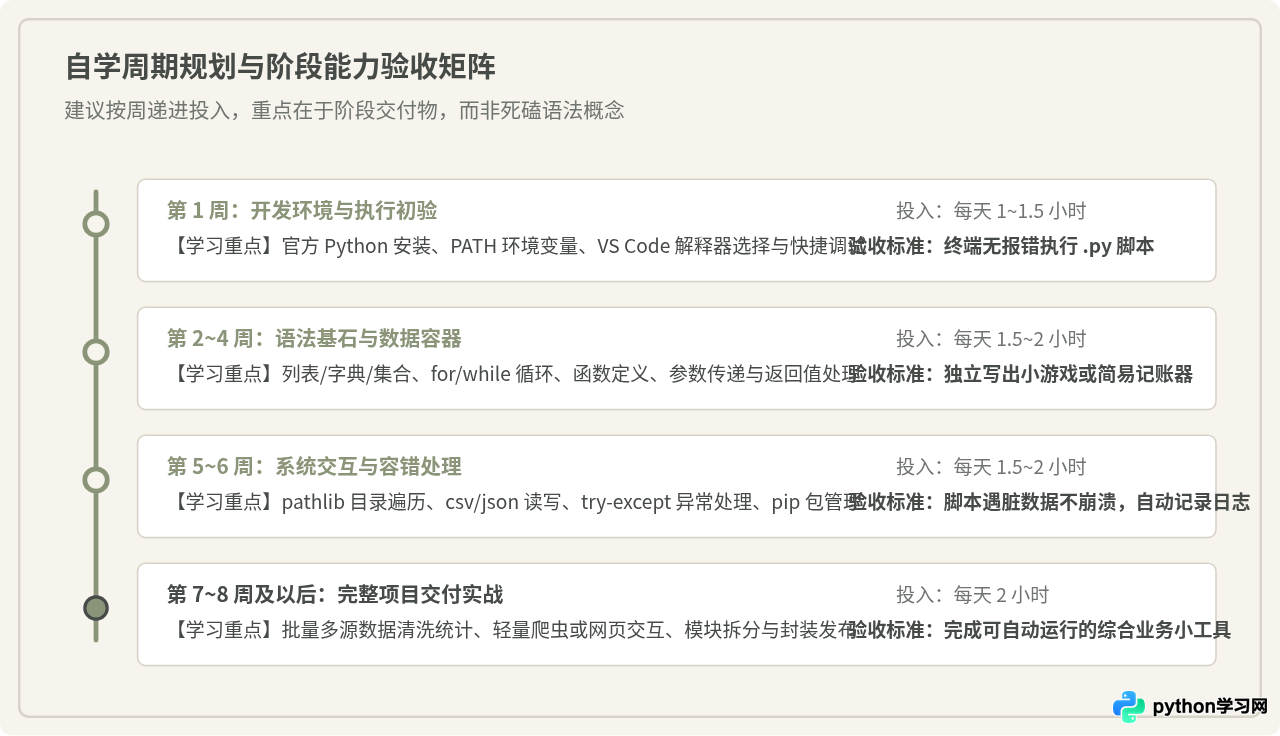
推荐采用“八周递进自学节奏”,以每天 1.5 到 2 小时的稳定投入为基准,划分为四个清晰的阶段目标:
| 阶段 | 周期 | 核心任务 | 关键验收标准 |
|---|---|---|---|
| 阶段一:环境搭建 | 第 1 周 | 安装 Python 官方解释器、配置 PATH、安装 VS Code 及 Python 扩展 | 能够在系统终端及 VS Code 终端无报错运行首个 .py 脚本 |
| 阶段二:语法筑基 | 第 2~4 周 | 掌握数字、字符串、列表、字典及 for/if 控制流与函数封装 | 不借助现成模板,独立编写出成绩统计或猜数字小交互程序 |
| 阶段三:标准库应用 | 第 5~6 周 | 掌握 pathlib 文件路径处理、CSV/JSON 读写及 try-except 异常捕获 |
能对本地包含脏数据的文件进行扫描、清洗与异常兜底 |
| 阶段四:项目实战 | 第 7~8 周 | 整合多文件批量提取、统计归约与格式化报表生成 | 完成一套开箱即用的多数据源批量合并清洗脚本 |
二、阶段一:开发环境搭建与首个程序运行
对于零基础学习者而言,搭建开发环境是遇到的第一道隐形门槛。由于操作系统权限、网络差异或环境变量未正确添加,初学者往往在第一行代码运行前就耗尽了热情。理清安装逻辑,遵循官方标准路径即可顺利规避绝大多数问题。
1. 解释器选型:官方安装包 vs Anaconda
网络教程经常推荐安装 Anaconda,理由是其自带了大量科学计算库。但对于零基础学习者,更推荐直接下载 Python 官方安装包。Anaconda 体积庞大(数个 G),包依赖逻辑复杂,初学者极易在环境冲突时不知所措;而官方纯净版体积小(仅数十兆)、结构清晰,便于初学者理解模块安装与环境变量的底层机制。
2. 安装关键步骤与 PATH 环境变量
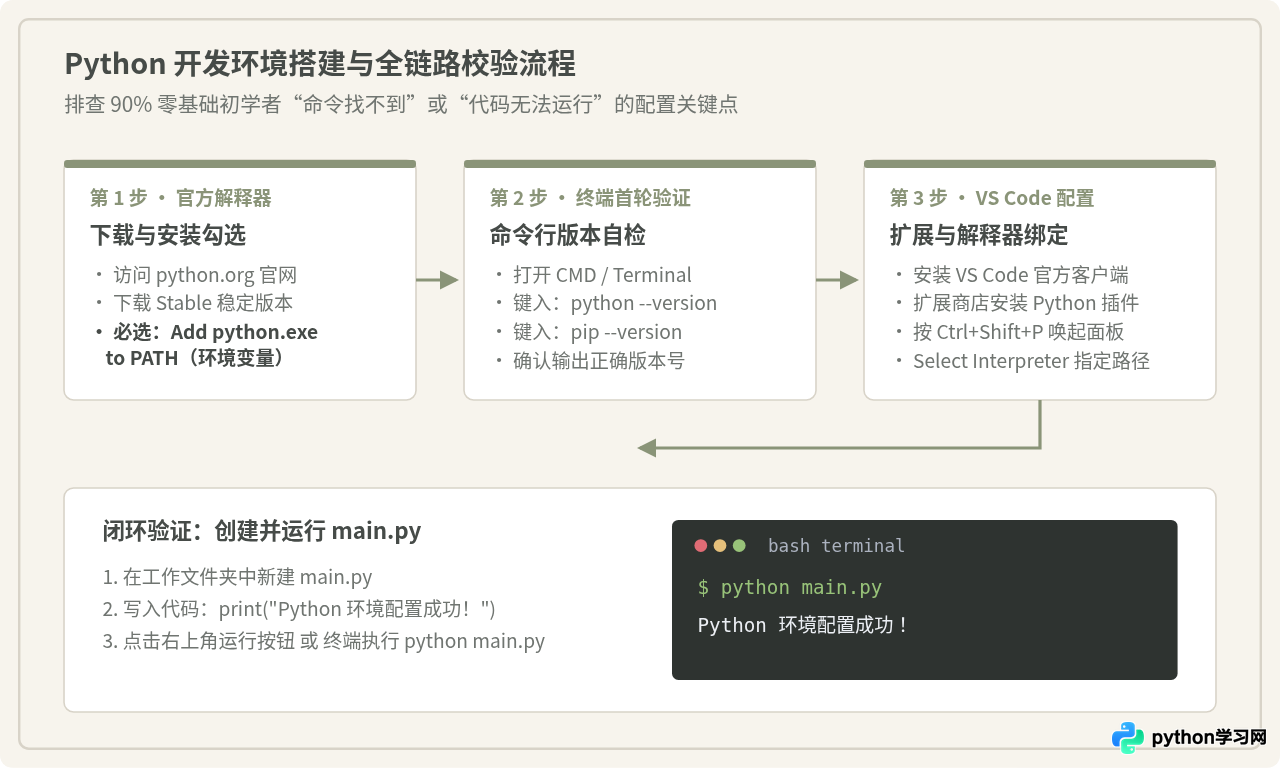
前往 Python 官方网站(python.org),在 Downloads 导航栏中下载对应操作系统的稳定版安装程序。在运行安装程序时,最关键的一步是勾选底部的“Add python.exe to PATH”复选框(若未勾选,系统终端将无法识别 python 命令)。随后点击“Install Now”完成安装。
操作系统的“环境变量(PATH)”好比一份系统的寻路电话薄。当你在终端输入 python 时,系统会在 PATH 记录的路径中逐个寻找名为 python.exe 的可执行文件。若未勾选此项,终端便不知道去哪个文件夹启动 Python,从而报错“'python' 不是内部或外部命令”。
3. 终端验证与版本确认
安装完成后,打开操作系统的命令行工具(Windows 下按 Win + R 输入 cmd 回车,macOS 下打开“终端 Terminal”),分别输入以下命令并检查输出结果:
python --version
pip --versionpip 24.0 from ... (python 3.12)
如果能正确看到版本号,说明系统底层的 Python 解释器已经就绪。
4. 编辑器选择与 VS Code 配置
推荐使用微软官方的 Visual Studio Code(简称 VS Code) 作为主力编写工具。它轻量、跨平台,且拥有强大的生态支持。配置步骤只需三步:
- 下载并安装 VS Code 客户端;
- 在左侧工具栏点击 Extensions(扩展图标),搜索 Python(由 Microsoft 官方发布),点击 Install 安装;
- 按快捷键
Ctrl + Shift + P(macOS 为Cmd + Shift + P),输入Python: Select Interpreter,在弹出列表中选中刚才安装好的 Python 路径。
5. 编写并运行首个脚本
在电脑上新建一个专属代码文件夹(例如 python_study),在 VS Code 中点击“File -> Open Folder”打开该文件夹。新建文件命名为 hello.py,输入以下代码:
# hello.py
user_name = "自学者"
print(f"你好,{user_name}!Python 环境已成功就绪。")
在 VS Code 界面右上角点击三角播放按钮,或者在下方内置终端中键入:
python hello.py三、阶段二:核心语法与编程思维筑基
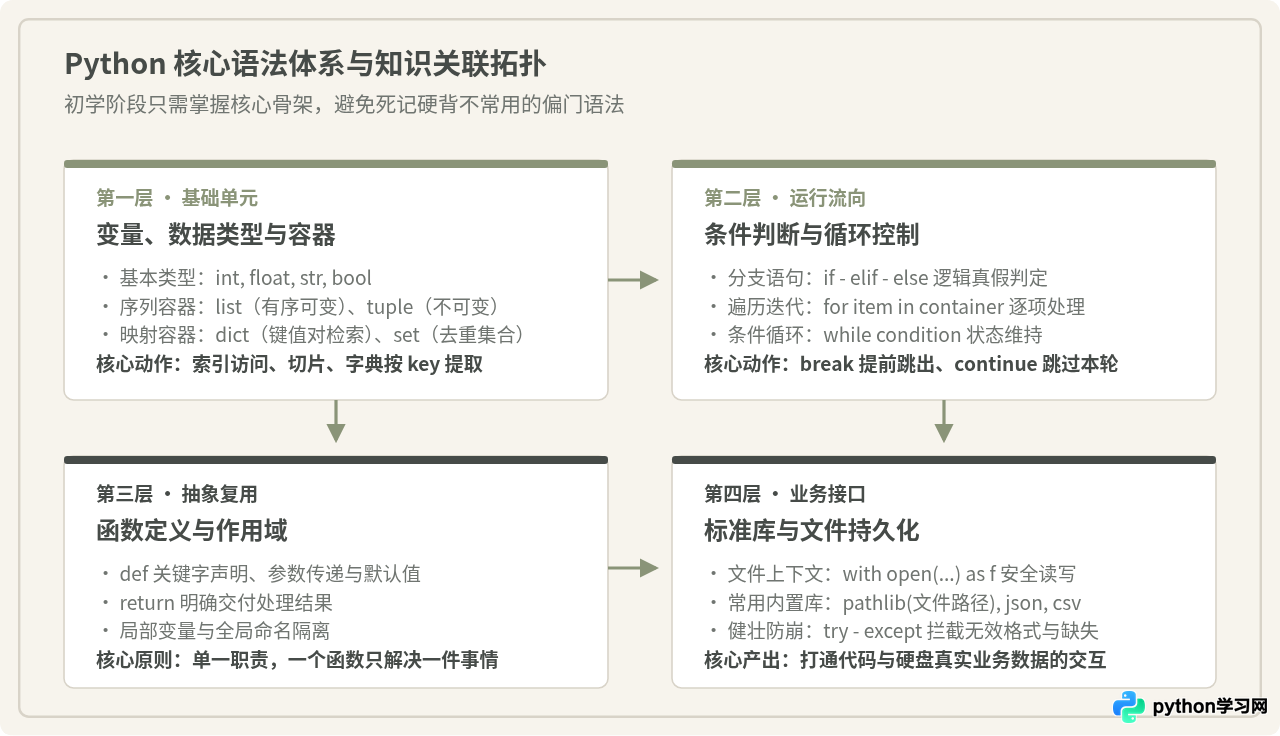
Python 的语法极其丰富,但日常开发中 80% 的任务仅依赖于其中 20% 的核心概念。零基础自学切忌按字典顺序逐条背诵 API,而应牢牢把握“数据存放、流程控制、功能封装”三个核心维度。
1. 数据容器的选择与操作
数据是程序处理的对象。Python 中最常用的四大容器是列表(list)、字典(dict)、元组(tuple)和集合(set):
- 列表(List):有序、可变序列,适合存放同类型元素的排列表,例如待处理的文件名列表:
files = ["a.csv", "b.csv"]。 - 字典(Dict):键值对集合(Key-Value),按键秒级检索,是处理业务数据最核心的载体,例如:
user = {"id": 101, "score": 92.5}。 - 元组(Tuple):不可变有序组,用于存放不应被修改的固定配置或坐标:
point = (1920, 1080)。 - 集合(Set):无序且元素唯一,常用于列表快速去重或交并集运算:
unique_ids = set(raw_id_list)。
2. 流程控制:让程序具备判断与重复处理能力
程序之所以能自动化,核心在于条件判断与循环。以下是筛选异常数据项的代码片段:
scores = [88, -5, 92, 105, 76]
valid_scores = []

for score in scores:
    # 业务过滤:排查不在 0 到 100 之间的异常值
    if 0 <= score <= 100:
        valid_scores.append(score)
    else:
        print(f"检测到异常分数值,已过滤: {score}")

print(f"有效分数列表: {valid_scores}")检测到异常分数值,已过滤: 105
有效分数列表: [88, 92, 76]
3. 函数封装:从面条代码走向工程化
当一段逻辑在代码中重复出现两次以上时,就应当用 def 封装为函数。函数的设计原则是单一职责与纯净输入输出:
def calculate_average(numbers: list) -> float:
    """计算非空数字列表的平均值,空列表返回 0.0"""
    if not numbers:
        return 0.0
    return sum(numbers) / len(numbers)

avg = calculate_average(valid_scores)
print(f"平均分计算结果: {avg:.2f}")
四、阶段三:自学过程中的常见认知误区与修正
在自学推进到第 3 到 4 周时,许多人会产生严重的挫败感。这些挫败往往并非智力问题,而是陷入了学习认知误区。
现象与成因:跟着教学视频看老师敲代码,逻辑顺畅、结果完美,但关掉视频面对空白编辑器时脑中一片空白。这是“被动输入”产生的掌握假象。
修正方案:每次看完一个案例后,立刻合上教程。用自己的语言在纸上或注释中列出步骤(步骤 1 做什么、步骤 2 做什么),然后自己敲出代码。遇到语法报错时,先自己读懂英文报错行,尝试修改,实在卡住 20 分钟以上再去对照原代码。
现象与成因:刚学完基本语法,就盲目冲进 LeetCode 刷动态规划或二叉树算法,被难度劝退,怀疑自己不适合编程。
修正方案:计算机科学算法与日常工程开发是两个维度。对于绝大多数学习者而言,Python 最强大的优势在于自动化办公、文件处理、数据抓取与应用开发。先学会用 Python 解决手头的实际文件整理和数据计算,建立信心之后,再按需了解数据结构与算法原理。
现象与成因:终端一冒出红色 Traceback 就手足无措,全网病急乱投医重装软件。
修正方案:Python 的报错提示实际上是极其精准的诊断报告。学会看最后一行:IndexError(索引越界)、KeyError(字典不存在该键)、TypeError(类型不匹配,如数字加字符串)、FileNotFoundError(路径写错)。把最后一行报错和触发代码行对应起来,95% 的问题都能在 2 分钟内定位。
五、阶段四:综合项目实战——多数据源批量合并清洗脚本
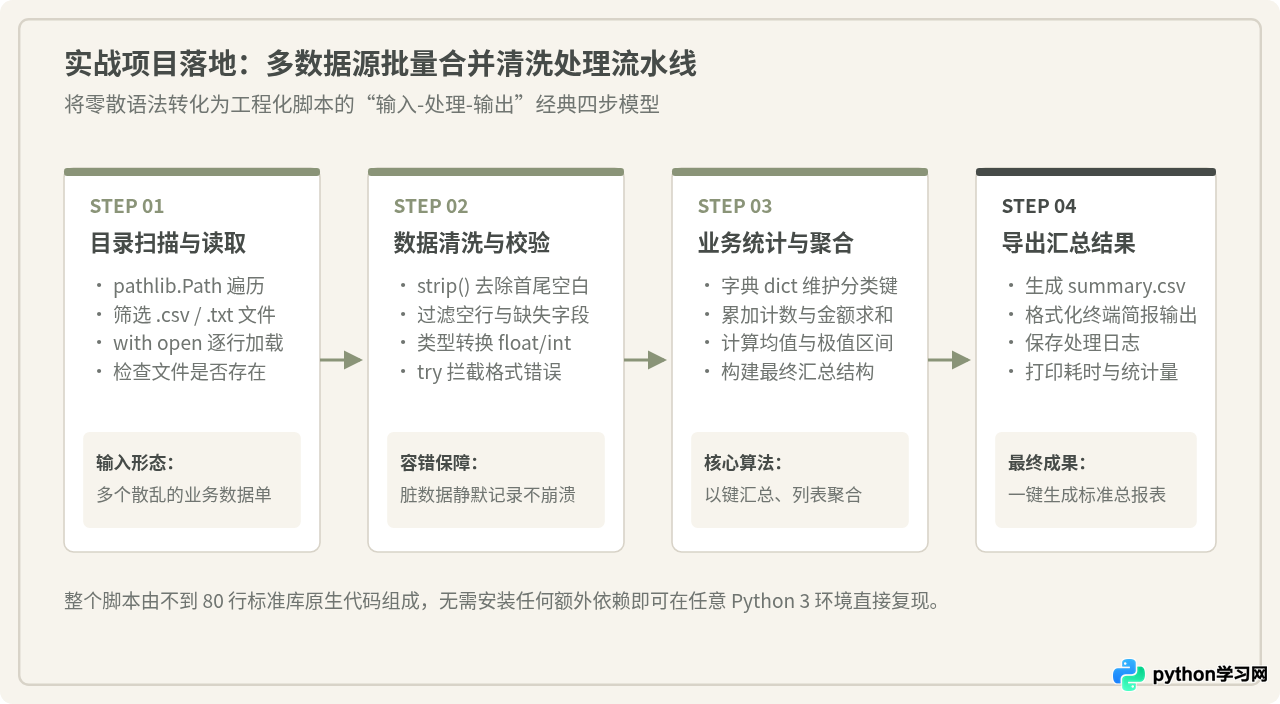
衡量自学是否出师的唯一标准,是能否面对一个真实的、没有现成答案的问题,独立完成需求拆解、代码设计与容错落地。本节以实际工作中极具代表性的“分散数据文件自动汇总与统计”为例,演示完整工程实现。
1. 项目需求拆解
假设我们每天都会从不同业务分支收到多个格式类似的业务记录文本(例如 branch_a.csv, branch_b.csv 等),里面混杂着空行、脏格式数据或无效金额。我们的目标是编写一个脚本 data_processor.py:
- 自动扫描指定文件夹下的所有
.csv文件; - 逐行清洗数据,剔除缺失列、首尾空格以及非法金额;
- 按业务品类累加销售额与交易笔数;
- 将汇总报表导出为标准的
summary_report.csv,并在终端输出执行报告。
2. 完整实战源码
创建文件 data_processor.py,代码完全使用 Python 内置标准库(pathlib 与 csv),不需要 pip install 任何第三方依赖即可直接运行:
# data_processor.py
"""
项目实战:多源 CSV 数据文件自动合并与业务指标汇总清洗脚本
使用原生标准库实现,具备路径自检与脏数据容错能力
"""
import csv
from pathlib import Path


def process_single_file(file_path: Path, category_summary: dict) -> tuple[int, int]:
    """
    解析单个 CSV 文件,更新全局品类汇总字典
    返回: (成功处理行数, 异常行数)
    """
    success_count = 0
    error_count = 0

    try:
        with open(file_path, mode="r", encoding="utf-8") as f:
            reader = csv.reader(f)
            # 读取首行表头
            header = next(reader, None)
            if not header:
                return 0, 0

            for line_no, row in enumerate(reader, start=2):
                # 校验字段完整性(期望:订单号, 品类, 金额)
                if len(row) < 3:
                    error_count += 1
                    continue

                category = row[1].strip()
                amount_str = row[2].strip()

                # 数据类型清洗与异常拦截
                try:
                    amount = float(amount_str)
                    if amount < 0:
                        raise ValueError("金额不能为负数")
                except ValueError:
                    error_count += 1
                    continue

                # 累加到全局品类字典
                if category not in category_summary:
                    category_summary[category] = {"total_amount": 0.0, "order_count": 0}

                category_summary[category]["total_amount"] += amount
                category_summary[category]["order_count"] += 1
                success_count += 1

    except Exception as e:
        print(f"[警告] 读取文件 {file_path.name} 失败: {e}")

    return success_count, error_count


def export_summary_report(output_path: Path, category_summary: dict) -> None:
    """将汇总指标写入输出 CSV 文件"""
    with open(output_path, mode="w", encoding="utf-8", newline="") as f:
        writer = csv.writer(f)
        writer.writerow(["品类名称", "成交笔数", "总销售额(元)", "客单均价(元)"])

        for category, stats in sorted(category_summary.items()):
            count = stats["order_count"]
            total = stats["total_amount"]
            avg = total / count if count > 0 else 0.0
            writer.writerow([category, count, f"{total:.2f}", f"{avg:.2f}"])


def main():
    data_dir = Path("./data_source")
    output_file = Path("./summary_report.csv")

    # 1. 如果演示数据目录不存在,自动生成两个测试文件用于自检
    if not data_dir.exists():
        data_dir.mkdir(parents=True, exist_ok=True)
        # 生成示例测试数据 A
        (data_dir / "sales_east.csv").write_text(
            "order_id,category,amount\n"
            "E101, 电子数码 , 2999.00\n"
            "E102, 办公用具 , 45.50\n"
            "E103, 电子数码 , INVALID\n"  # 模拟脏数据
            "E104, 食品生鲜 , 128.00\n",
            encoding="utf-8"
        )
        # 生成示例测试数据 B
        (data_dir / "sales_west.csv").write_text(
            "order_id,category,amount\n"
            "W201, 食品生鲜 , 86.00\n"
            "W202, 办公用具 , 150.00\n"
            "W203, 电子数码 , 4200.00\n",
            encoding="utf-8"
        )
        print("[提示] 已自动创建演示数据目录及测试 CSV 文件。")

    # 2. 扫描所有 csv 文件
    csv_files = list(data_dir.glob("*.csv"))
    print(f"[扫描完成] 发现 {len(csv_files)} 个待处理数据文件。")

    category_summary = {}
    total_valid = 0
    total_errors = 0

    for csv_file in csv_files:
        valid_cnt, err_cnt = process_single_file(csv_file, category_summary)
        total_valid += valid_cnt
        total_errors += err_cnt
        print(f" -> 已处理 {csv_file.name}: 有效 {valid_cnt} 笔,过滤无效 {err_cnt} 笔")

    # 3. 导出汇总报表
    export_summary_report(output_file, category_summary)

    print("\n======== 执行简报 ========")
    print(f"处理成功记录总数: {total_valid}")
    print(f"清洗过滤异常记录: {total_errors}")
    print(f"汇总指标已保存至: {output_file.resolve()}")


if __name__ == "__main__":
    main()
3. 运行效果与验证
直接在项目目录下运行该脚本:
python data_processor.py[扫描完成] 发现 2 个待处理数据文件。
-> 已处理 sales_east.csv: 有效 3 笔,过滤无效 1 笔
-> 已处理 sales_west.csv: 有效 3 笔,过滤无效 0 笔
======== 执行简报 ========
处理成功记录总数: 6
清洗过滤异常记录: 1
汇总指标已保存至: /path/to/project/summary_report.csv
查看自动生成的 summary_report.csv,内容格式如下:
品类名称,成交笔数,总销售额(元),客单均价(元)
办公用具,2,195.50,97.75
电子数码,2,7199.00,3599.50
食品生鲜,2,214.00,107.00通过这个实战项目,初学者同时练习了模块导入、路径遍历、上下文管理(with 自动关闭文件资源)、循环判断、类型安全转换、字典聚合与外部写入。这套“扫描—清洗—归约—持久化”的代码范式,可以无缝迁移至企业日常工作中 70% 以上的日常数据整理场景。
六、阶段五:能力验证与进阶方向选择
完成上述阶段后,如何客观判断自己是否已经脱离了“纯初学者”阶段?可以对照以下三项基准进行自我审查:
- 脱离单步教程:给定一个简单文件处理需求,能够自主列出代码步骤,而不是第一反应去搜索引擎复制粘贴整段脚本;
- 自主排查错误:运行脚本报错时,能根据终端抛出的错误类型定位到具体文件和行数,并使用
print()或断点观察变量中间值; - 代码防御意识:打开文件或请求外部数据时,习惯性加上
try-except或判断文件是否存在,而不是假定外部数据永远规范完美。
后续三大主流发展路线
掌握了核心 Python 与工程化基础后,建议根据自身职业背景与兴趣,选择一个主攻方向深耕,切忌在多个领域浅尝辄止:
- 方向 1:数据分析与科学计算
推荐技术栈:pandas、numpy、matplotlib、seaborn、Jupyter Notebook。
适用人群:财务、运营、市场或科研人员,需要处理数万行复杂 Excel、制作动态数据看板或撰写分析报告。 - 方向 2:自动化脚本与爬虫开发
推荐技术栈:requests、BeautifulSoup4、playwright、openpyxl。
适用人群:需要定期抓取公开网页资讯、批量自动填写表单或跨软件同步数据的工作者。 - 方向 3:轻量 Web 应用与 API 服务
推荐技术栈:FastAPI、Flask、sqlite3。
适用人群:希望把自己的脚本包装成网页工具给团队同事使用,或者为移动端提供后端接口的开发者。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















