


Python怎么获取字符串的长度
详细讲解在Python中获取字符串长度的标准方法,分析len()函数的底层机制、字符数与字节数的区别、转义字符与特殊字符的处理细节,以及类型报错的排查方法。
在 Python 中获取字符串长度的标准方法是调用内置函数 len()。该函数直接接收目标字符串作为参数并返回字符总数,运行速度为常数级复杂度 O(1)。本文将具体介绍该函数的使用规范、底层取值机制、字符数与字节数的界限、转义字符及常见报错的排查技巧。
一、基础用法:使用内置函数 len()
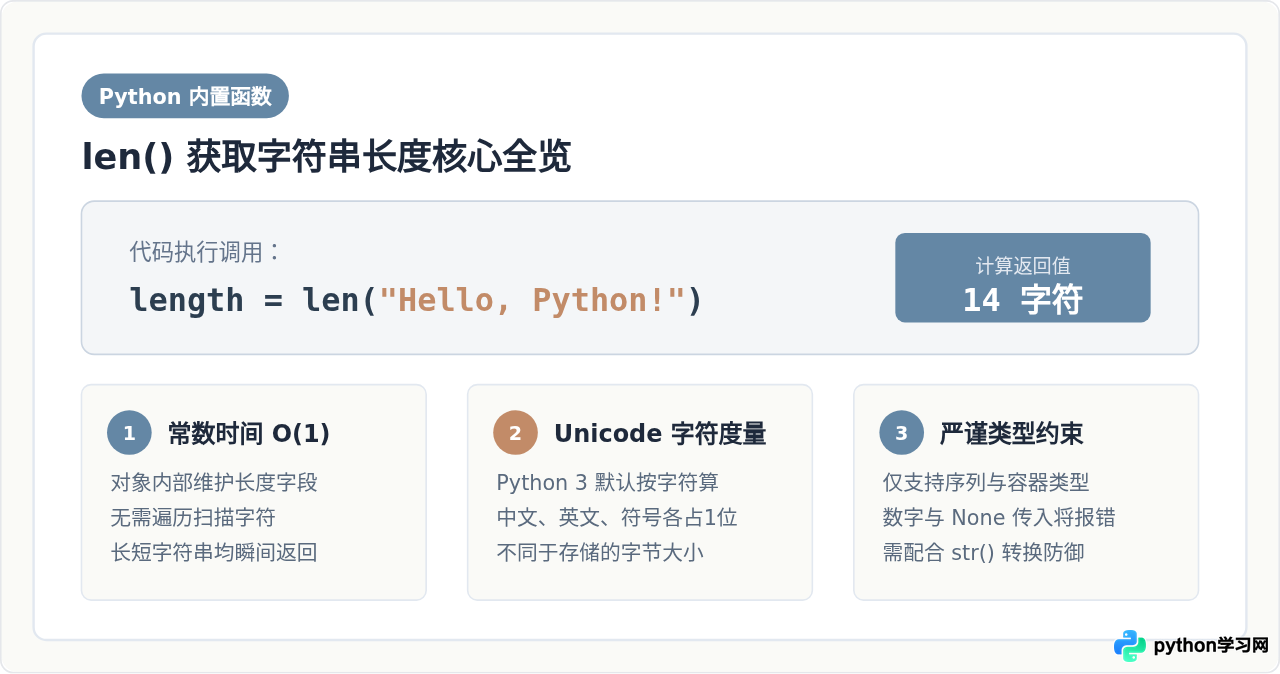
Python 提供了全局内置函数 len()(length 的简写),用于获取任何序列(包括字符串、列表、元组等)的元素个数。当参数为字符串类型时,它返回的是该字符串包含的字符总数。
基础使用形式非常直观:直接将字符串字面量或字符串变量置于 len() 的括号内即可。
# 示例:获取常规字符串变量的长度
text = "Hello, Python!"
length = len(text)
print("字符串长度为:", length)字符串长度为: 14在上述例子中,字符串中包括 12 个英文字母、1 个半角逗号、1 个空格和 1 个感叹号,共计 14 个字符。空格和各类标点符号均作为普通字符进行完整计数。
为什么 len() 运行速度极快?
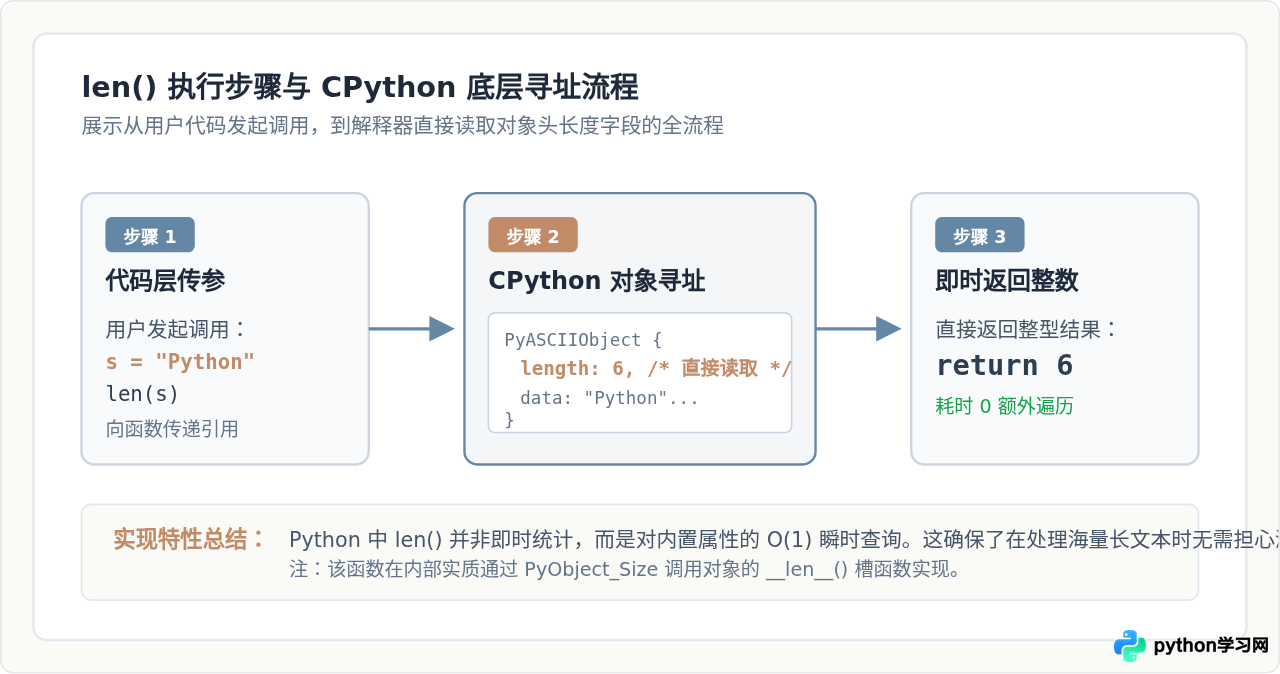
在许多低级语言中,获取以空字符结尾的字符串长度需要从头到尾遍历内存空间,时间复杂度为 O(n)。但在 Python(具体为标准 CPython 解释器)中,字符串以不可变的 PyASCIIObject 或 PyCompactUnicodeObject 结构体形式存在。当字符串被创建时,解释器就已经计算并将长度存储在其元数据结构中的 length 字段中。
因此,调用 len(s) 实际上只是读取了一个已经存储在内存结构中的整型数字,其时间复杂度为 O(1) 常数级别。不论字符串包含 10 个字符还是 1000 万个字符,获取长度的操作耗时均完全相同,无须担心性能衰减。
二、关键概念澄清:字符数 vs 字节数
初学者容易产生的一个困惑是:一段文字的“长度”到底是指视觉/逻辑上的字符个数,还是在磁盘/网络上占用的字节总数?
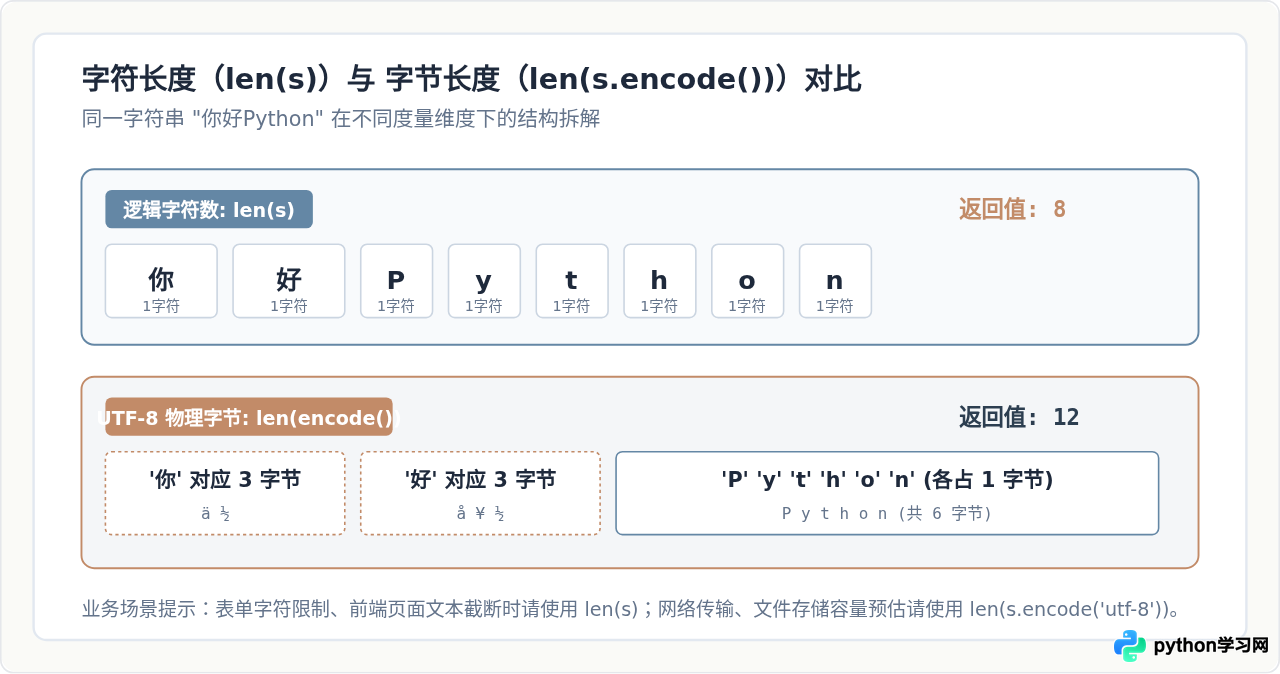
在 Python 3 中,标准字符串类型 str 完全基于 Unicode。因此,len(str) 统计的始终是 Unicode 字符数量(码点数量)。无论是英文字母、阿拉伯数字、标点符号还是汉字,每一个独立字符在 len() 看来权重都是 1。
# 示例:中英混合字符串的字符数统计
text = "你好Python"
print("字符总数:", len(text))字符总数: 8输出结果为 8,对应 2 个中文字符与 6 个英文字母。然而,当我们需要把字符串保存到本地文件、存入数据库特定字段(如以字节限制长度的 VARCHAR),或者通过网络 Socket 发送时,系统关注的是物理编码后的字节长度(Byte Length)。
如何获取字符串的字节长度?
若需要获取字节数,必须先调用字符串的 .encode() 方法将其编码为字节序列(bytes 类型),然后再对该字节序列调用 len():
# 示例:获取 UTF-8 编码下的字节长度
text = "你好Python"
utf8_bytes = text.encode("utf-8")
print("UTF-8 字节数:", len(utf8_bytes))

# 示例:获取 GBK 编码下的字节长度
gbk_bytes = text.encode("gbk")
print("GBK 字节数:", len(gbk_bytes))UTF-8 字节数: 12
GBK 字节数: 10在 UTF-8 编码规范中,常见汉字通常占用 3 个字节,英文字符占用 1 个字节,因此总计为 2 * 3 + 6 = 12 字节;而在 GBK 编码中,汉字通常占用 2 个字节,因此总计为 2 * 2 + 6 = 10 字节。
三、特殊字符与容易忽略的细节
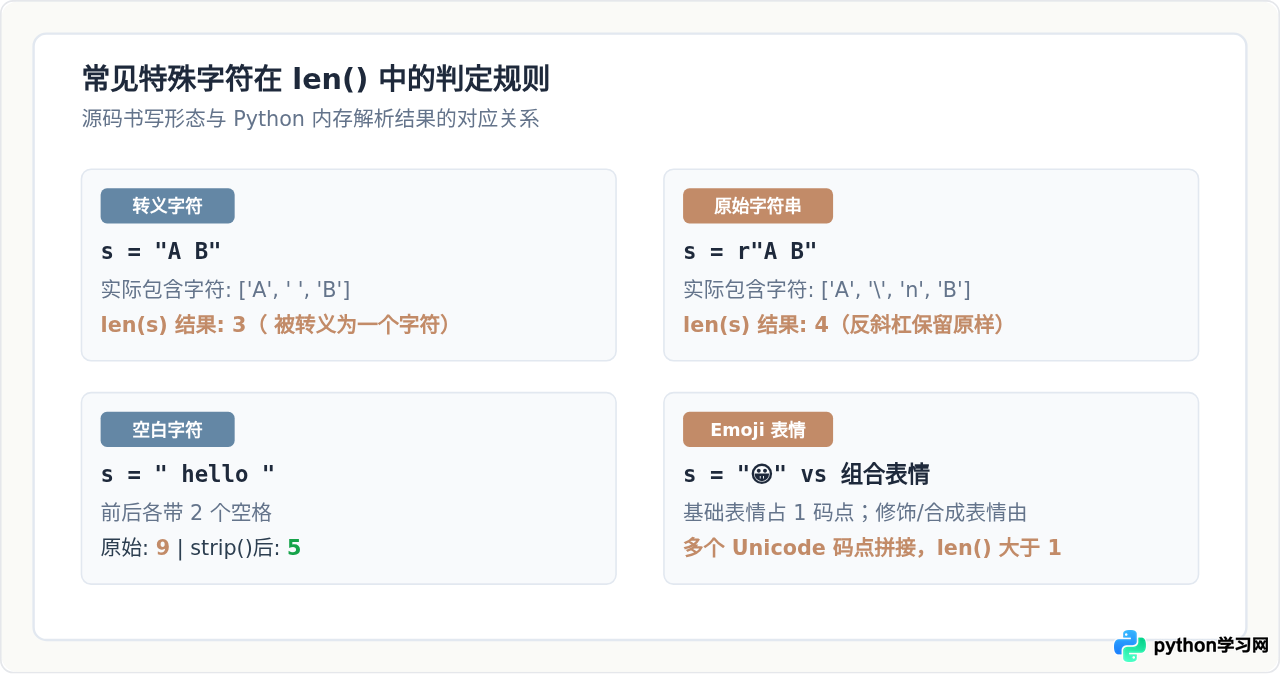
虽然 len() 本身使用简单,但在遇到转义字符、不可见空白符号以及组合 Emoji 表情时,初学者很容易因为视觉表象与内存实际表示的差异而得出错误的预期。
1. 转义字符与原始字符串(Raw String)
在普通字符串中,带有反斜杠的转义序列(如换行符
、制表符 、回车符 )在解释器载入后会被转义为一个单独的控制字符。例如,源码中键入了 \ 和 n 两个字符,但其内存长度仅为 1。
如果使用原始字符串(以 r 或 R 为前缀),反斜杠将失去转义功能,按原样视作普通字符。
# 普通字符串:
 作为一个换行符
normal_str = "A
B"
print("普通字符串长度:", len(normal_str))

# 原始字符串:\ 与 n 分别作为独立字符
raw_str = r"A
B"
print("原始字符串长度:", len(raw_str))普通字符串长度: 3
原始字符串长度: 42. 空字符串与空白字符
没有任何字符的空字符串 "" 长度为 0;而由空格或制表符组成的字符串,无论在屏幕上看起来多么“空”,每一个空格都算作一个长度。若业务要求忽略首尾空白,应在统计前调用 .strip() 处理。
empty = ""
print("空字符串长度:", len(empty))  # 0

spaces = "   "
print("纯空格长度:", len(spaces))   # 3

padded = "  hello  "
print("去除前后空格后长度:", len(padded.strip()))  # 5
3. Emoji 表情与多码点字符
大多数常见 Emoji(如 😀)是单个 Unicode 码点,len("😀") 返回 1。然而,某些复杂的 Emoji(如家庭、特定肤色的人物、国旗等)实际上是由多个 Unicode 码点通过“零宽连字号”(Zero Width Joiner, ZWJ )拼接而成的。对于这类组合字符,len() 统计的是背后的码点总数,而不是屏幕上渲染出的单个合成图标。
四、常见报错与防御性编写
在实际项目开发中,直接将变量传入 len() 往往是产生运行时异常的高发点。最常见的报错是向 len() 传入了非序列对象。
1. 常见报错表现
当变量未被正确初始化、计算结果为 None,或者从数据库/接口读取到了数值类型(如 int、float)时,执行 len() 将直接抛出 TypeError:
# 错误示例 1:传入整数
num = 12345
length = len(num)  # 抛出 TypeError: object of type 'int' has no len()

# 错误示例 2:传入 None
val = None
length = len(val) # 抛出 TypeError: object of type 'NoneType' has no len()在 Python 的设计哲学中,数值代表标量大小,而非序列。如果要统计整数拥有多少个十进制数位,必须显式将其转为字符串形态后再调用 len(),即 len(str(num))。
2. 稳健的防御性代码模式
为了保证程序在面对未知外部数据(如用户输入、接口入参)时不发生崩溃,推荐采用以下两种处理模式:
模式 A:显式类型校验
def get_safe_length(val):
    if isinstance(val, str):
        return len(val)
    elif val is None:
        return 0
    else:
        # 如需把其他对象视为字符串测长,可先转换
        return len(str(val))

# 测试不同入参
print(get_safe_length("hello"))  # 示例输出:5
print(get_safe_length(None))     # 示例输出:0
print(get_safe_length(98765))    # 示例输出:5
模式 B:异常捕获与兜底
def get_length_with_try(val):
    try:
        return len(val)
    except TypeError:
        return len(str(val)) if val is not None else 0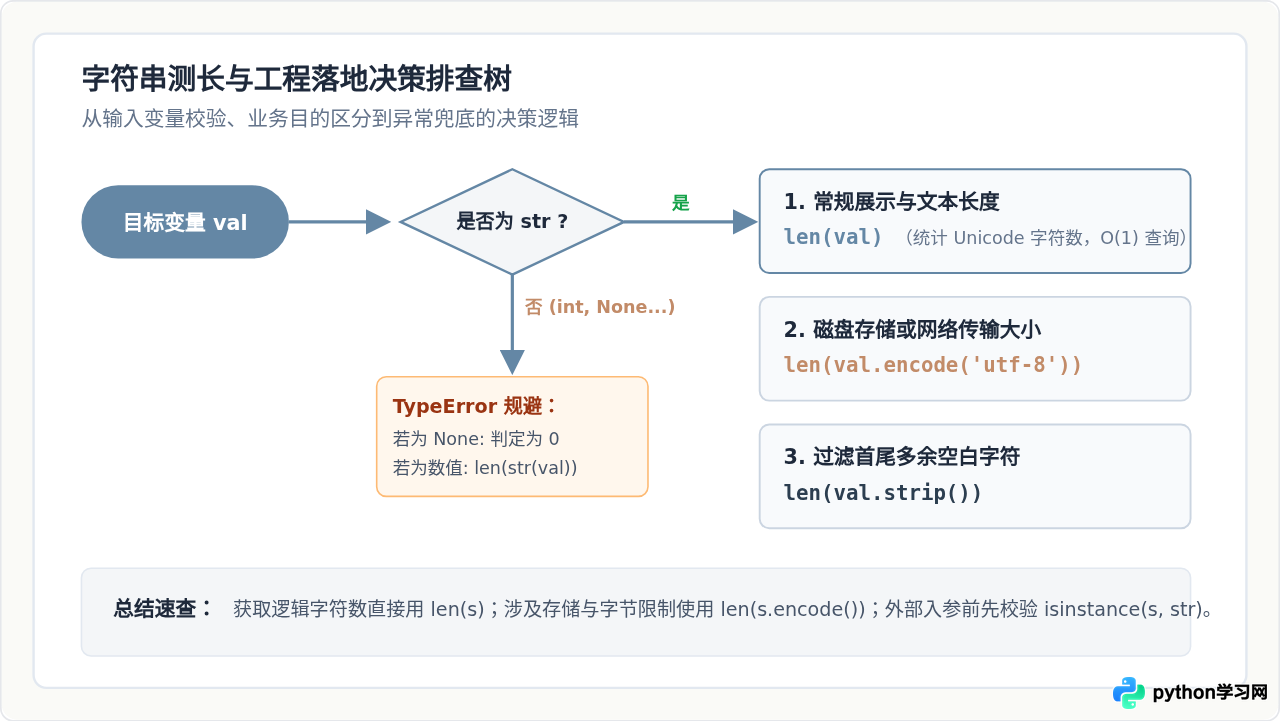
五、方法速查与总结
通过以上的具体展开,我们可以把 Python 中获取字符串长度的关键信息归纳为以下表格,便于在日常编码中快速查阅:
| 操作需求 | 对应代码写法 | 返回值含义 | 时间复杂度 |
|---|---|---|---|
| 统计字符个数(默认) | len(text) |
Unicode 码点总数(汉字、字母均计为 1) | O(1) |
| 统计 UTF-8 字节数 | len(text.encode('utf-8')) |
编码后的物理字节总数(常用汉字占 3 字节) | O(n)(受编码转换耗时影响) |
| 去除前后空格后测长 | len(text.strip()) |
有效非空白字符范围内的总字符数 | O(n) |
| 统计数值型变量的位数 | len(str(num)) |
数字转换为字符串后的十进制位数 | O(log10(num)) |
| 安全防御获取未知变量长度 | len(val) if isinstance(val, str) else 0 |
避免因 None 或数字抛出 TypeError | O(1) |
掌握 len() 的底层机制与 Unicode/字节之间的界限,能帮助我们在处理文本截断、表单校验以及网络报文打包时准确评估数据长度,避免潜在的越界与格式截断隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















