


什么时候该用NumPy数组代替Python列表?
深入解析什么时候该用NumPy数组代替Python列表:从底层内存分布、向量化计算机制到工程实践场景,明确界定二者的性能差异、适用边界与选择依据。
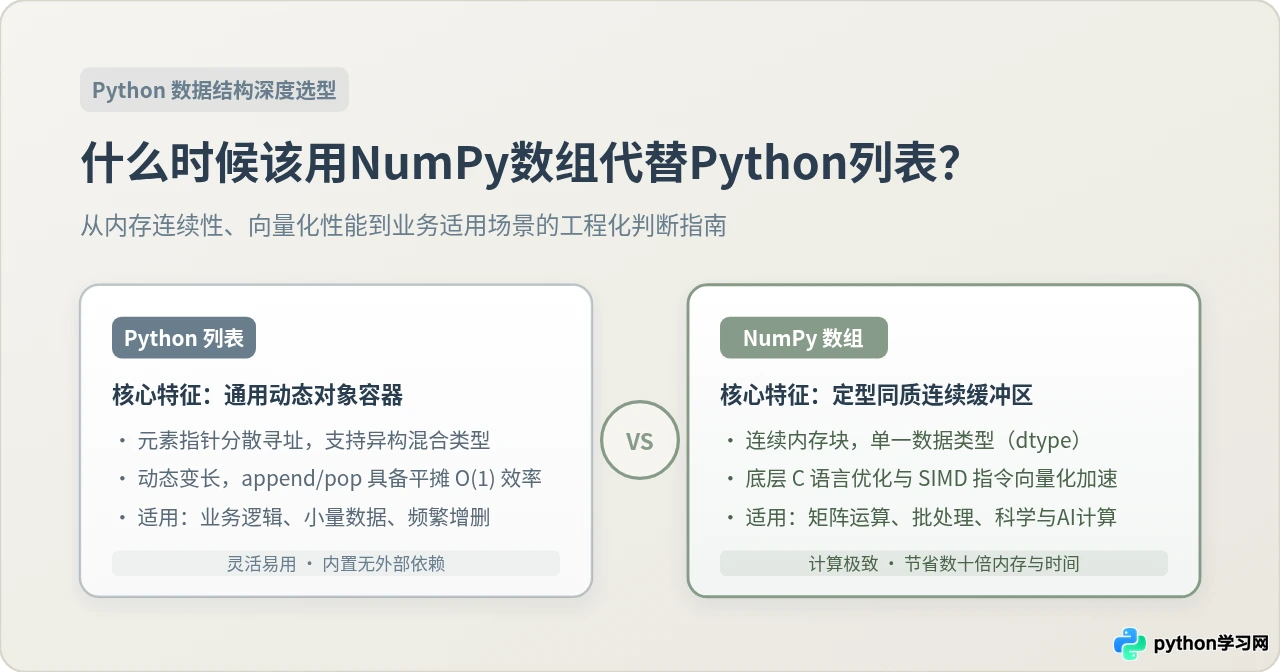
核心结论:当你需要处理大规模同质数值计算、多维矩阵运算、向量化批处理或与数据科学/AI生态对接时,应该坚决使用 NumPy 数组(ndarray)代替 Python 列表(list);而当你需要存储异构类型数据(混合字符串、字典、对象)、频繁执行动态增删(如 append、pop)或处理小规模通用业务逻辑时,Python 原生列表依然是更轻量、灵活且无外部依赖的首选容器。
一、为什么会有这个选择?底层内存模型差异
Python 列表与 NumPy 数组看似都是“保存一串元素的容器”,但它们在底层的内存组织方式存在本质区别。正是这种存储架构的差异,决定了二者在内存占用与执行速度上的天壤之别。
1. Python 列表的指针间接寻址模型
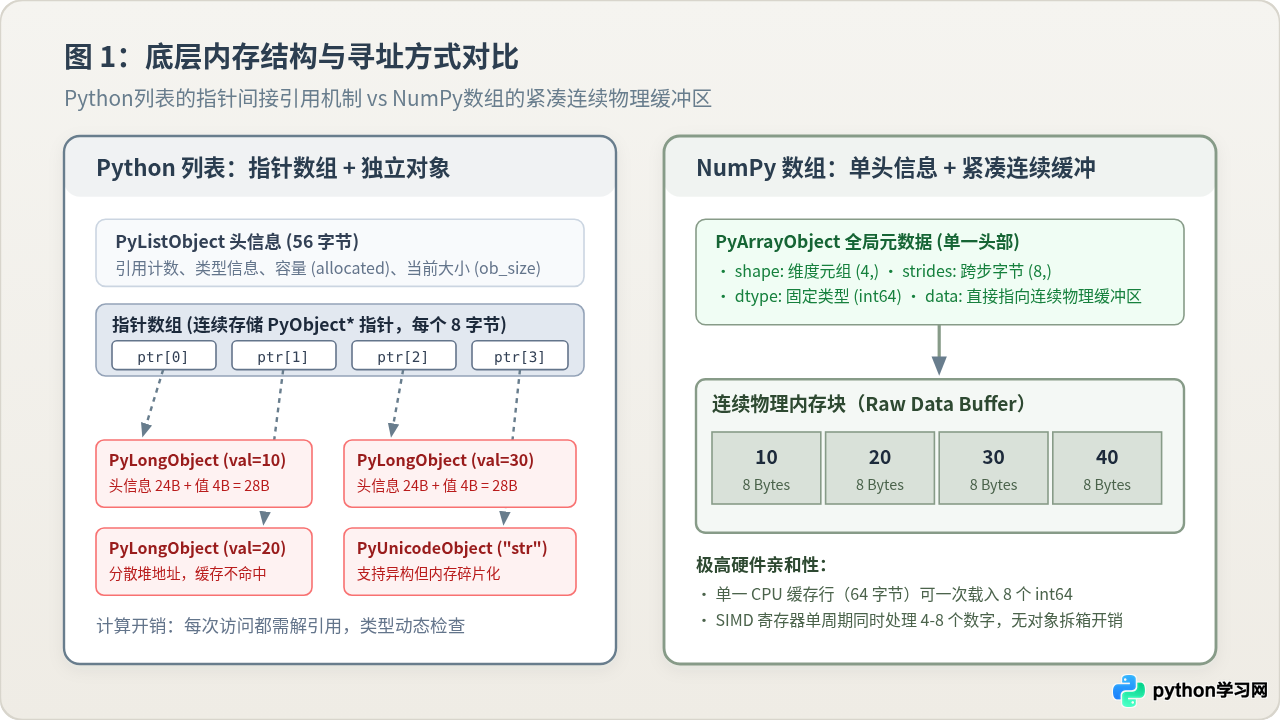
Python 原生列表本质上是一个动态指针数组。列表本身只按顺序连续保存指向具体对象的指针(在 64 位系统上每个指针占用 8 字节),而列表里的每一个整数、浮点数或字符串,都是独立分配在堆内存中的完整 PyObject。
以最简单的整数为例,Python 中即使是一个数字 10,也是一个包含引用计数、类型指针和数值信息的结构体(PyLongObject),至少占用 28 个字节。这意味着一个包含 100 万个整数的列表,除了每个元素 8 字节的指针,还在堆内存的不同位置分散着 100 万个 28 字节的对象头,内存占用接近 36 MB,且内存地址零散分布,无法有效利用 CPU 的 L1/L2 高速缓存。
2. NumPy 数组的连续同质内存模型
NumPy 数组(ndarray)则完全不同,它在底层由一块连续的物理内存缓冲区(Data Buffer)构成。整个数组共享一个全局元数据头(记录数组维度 shape、跨步 strides 和数据类型 dtype),数据缓冲区中存放的是纯粹的二进制连续数值,没有任何 Python 对象的包装开销。
同样存储 100 万个 64 位整数(int64),NumPy 严格按每数字 8 字节紧凑排列,仅消耗约 8 MB 内存,比原生列表节省 75% 以上的空间。更重要的是,连续的物理内存能够完美匹配 CPU 缓存行(Cache Line)预取机制,单次内存载入即可将相邻数据一并送入寄存器。
二、关键场景一:什么时候必须用 NumPy 数组?
只要你的需求触及以下四个核心特征之一,继续使用原生列表就会导致显著的性能瓶颈与代码臃肿,必须切换为 NumPy 数组。
1. 涉及大规模纯数值计算与向量化操作
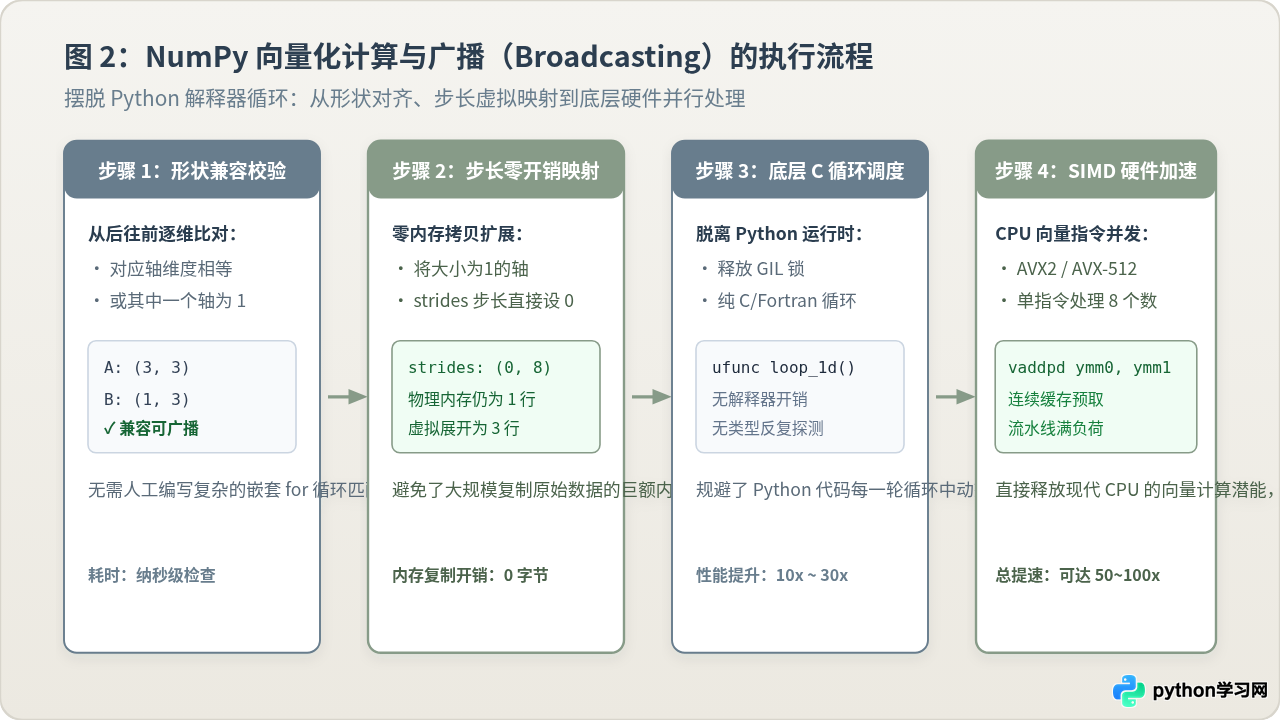
Python 的 for 循环在解释器层级逐行执行,每一轮迭代都需要检查元素类型、动态绑定方法并拆装箱。而 NumPy 提供了向量化(Vectorization)能力,将整个数学运算推向底层的 C 语言循环,并调用 CPU 的 SIMD(单指令多数据流)向量指令集并发执行。
# 环境:Python 3.10+, NumPy 1.24+
import time
import numpy as np

n = 2_000_000

# --- 方式 A:Python 原生列表循环相加 ---
list_a = list(range(n))
list_b = list(range(n))

t0 = time.perf_counter()
list_result = [a + b for a, b in zip(list_a, list_b)]
t_list = time.perf_counter() - t0

# --- 方式 B:NumPy 向量化直接相加 ---
arr_a = np.arange(n, dtype=np.int64)
arr_b = np.arange(n, dtype=np.int64)

t1 = time.perf_counter()
arr_result = arr_a + arr_b
t_numpy = time.perf_counter() - t1

print(f"原生列表耗时: {t_list:.4f} 秒")
print(f"NumPy 数组耗时: {t_numpy:.4f} 秒")
print(f"加速比: {t_list / t_numpy:.1f} 倍")
原生列表耗时: 0.1428 秒
NumPy 数组耗时: 0.0021 秒
加速比: 68.0 倍
在上述测试中,简单的逐元素加法在 NumPy 下达成了数十倍的提速。数据量越大,规避解释器开销和利用 SIMD 硬件并行的优势就越夸张。
2. 多维数组与矩阵运算(线性代数与图像处理)
如果使用列表模拟二维或三维矩阵(例如 matrix = [[1, 2], [3, 4]]),切片提取某一列需要写列表推导式 [row[1] for row in matrix],既冗长又会创建全新列表。
NumPy 原生支持多维切片与视图(View):提取整列只需 arr[:, 1],转置只需 arr.T,矩阵乘法只需 A @ B。这些操作均直接映射到底层高度优化的 BLAS/LAPACK 线性代数库,效率甚至超过普通手写的 C 代码。
3. 广播机制(Broadcasting):不同形状数组的零拷贝计算
当需要对一个 (1000, 3) 的坐标矩阵统一减去均值向量 (3,) 时,原生列表必须嵌套双层循环逐项相减。而 NumPy 的广播机制能够在不复制任何数据的前提下,通过将步长(strides)设为 0 虚拟展开维度,完成底层流水线批处理。
4. 对接现代数据科学与机器学习技术栈
Pandas DataFrame 的底层存储基于 NumPy 数组;Scikit-learn 的模型训练、PyTorch/TensorFlow 的张量转换(torch.from_numpy())均以 NumPy 的内存结构为通用中转标准。若坚持用列表,每次调用接口都会经历昂贵的格式转换复制。
三、关键场景二:什么时候应当保留并使用 Python 列表?
尽管 NumPy 在科学计算上极为强大,但在一般软件工程和常规业务逻辑中,NumPy 绝不是列表的全面替代品。在以下场景中,Python 原生列表具有不可替代的优势。
1. 容器中包含混合类型(异构数据)
Python 列表是通用引用容器,可以自由容纳任意类型的对象:
record = ["user_1024", 28, {"role": "admin", "active": True}, [1.5, 2.0]]
如果强行将混合类型传入 np.array(),NumPy 会自动将其降级为 dtype=object。此时,数组内部退化为存储 Python 对象指针,不仅完全失去了连续内存的缓存亲和性与 SIMD 向量化加速,反而引入了额外的包装开销,得不偿失。
2. 元素频繁动态追加(append)或弹出(pop)
Python 列表采用了预分配(Over-allocation)扩容算法。当列表容量占满时,解释器会按比例申请一块更大的连续指针空间,因此执行 list.append() 的平摊时间复杂度是优秀且平滑的 O(1)。
相比之下,NumPy 数组的长度在创建后是完全固定的。虽然 NumPy 提供了 np.append() 函数,但其内部实现是:重新申请一块更大的完整内存块,将旧数组中的所有数据全量拷贝过去,再把新元素拷入。
# 典型反模式示例:在循环中持续调用 np.append
import numpy as np
import time

count = 50_000

# 错误用法:不断重新分配内存
t0 = time.perf_counter()
arr = np.array([], dtype=np.int64)
for i in range(count):
    arr = np.append(arr, i)  # 每次循环都全量深拷贝!
t_bad = time.perf_counter() - t0

# 正确做法:先用列表收集,完成后一次性转为数组
t1 = time.perf_counter()
temp_list = []
for i in range(count):
    temp_list.append(i)
arr_correct = np.array(temp_list, dtype=np.int64)
t_good = time.perf_counter() - t1

print(f"循环 np.append 耗时: {t_bad:.4f} 秒")
print(f"列表 append 后转数组耗时: {t_good:.4f} 秒")
循环 np.append 耗时: 1.8452 秒
列表 append 后转数组耗时: 0.0076 秒
np.append()。高频动态收集数据时,应该优先使用 Python 列表作为缓冲区;当数据收集完毕进入计算阶段时,再调用一次 np.array() 转换为数组。
3. 小型数组与轻量级业务脚本
NumPy 函数在底层调度时有少许固定的微秒级封装与参数校验开销。当数组长度只有几十个元素时,列表推导式的执行耗时可能比 NumPy 的函数调用还要短,且无需额外引入第三方库依赖。
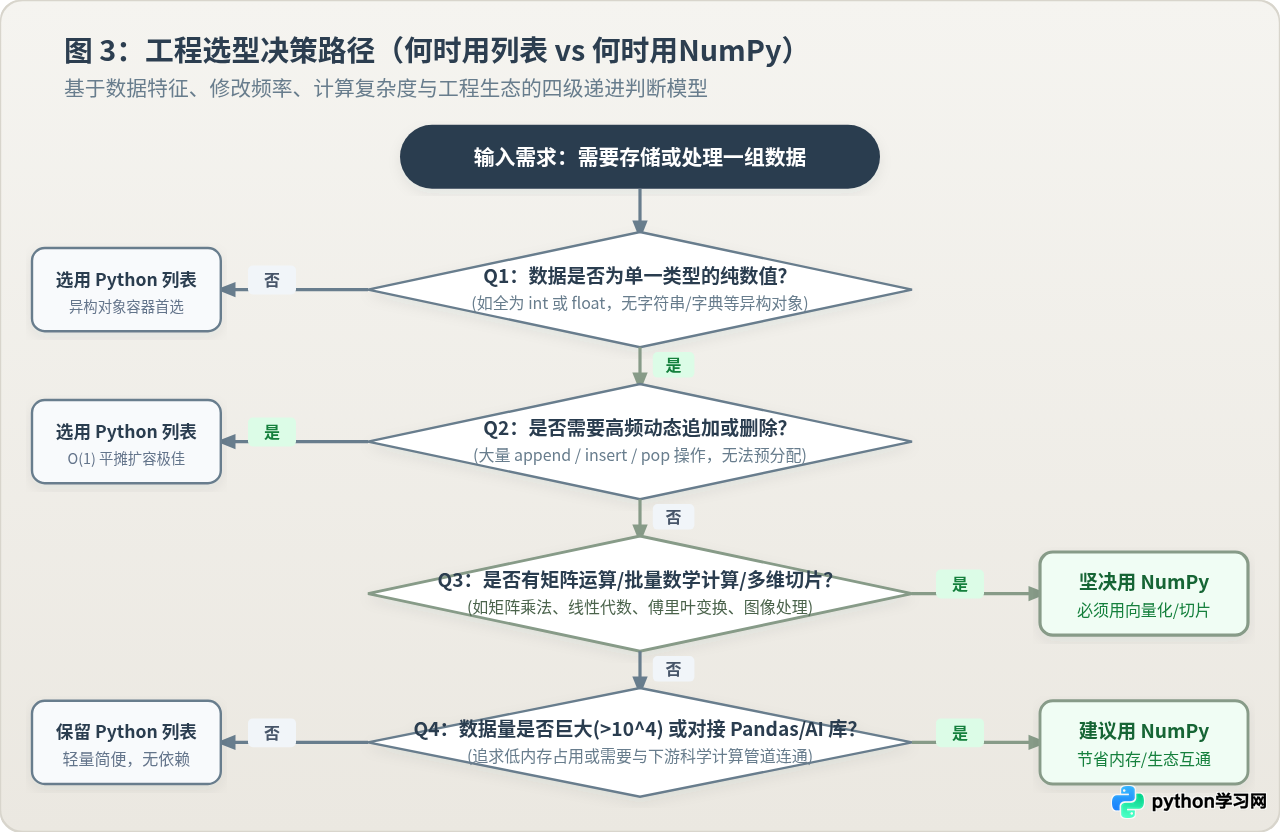
四、技术选型决策树与判断流程
为了在实际工程中快速做出正确决策,可以遵循如下四个核心判断步骤:
- 看数据类型:数据是否为单一的数值类型?若混杂了字典、类实例或变长文本,使用 Python 列表。
- 看增删频率:是否需要高频变长追加元素?如果是流式数据或队列,使用列表或
collections.deque。 - 看运算模式:是否需要批量执行矩阵乘法、统计聚合、多维切片或代数公式?如果是,必须使用 NumPy 数组。
- 看数据规模与生态:元素是否达到千量级以上,或需要传入 Pandas、Scikit-learn、PyTorch?如果是,选择 NumPy。
五、工程实践中的典型陷阱与注意事项
1. 警惕切片的“视图(View)”与“副本(Copy)”
在 Python 原生列表中,切片操作 sub_list = my_list[1:4] 始终会创建一个全新的浅拷贝列表,修改 sub_list 不会影响原列表。
但在 NumPy 中,基本切片 sub_arr = my_arr[1:4] 返回的是原数组的内存视图(View),两者共享同一块底层连续缓冲区。若修改 sub_arr[0] = 999,原数组 my_arr[1] 也会同步被修改。如果需要独立副本,必须显式调用 my_arr[1:4].copy()。
2. 明确指定 dtype 避免隐式类型提升
NumPy 默认会根据输入数据推导类型。例如在 64 位机器上整数推导为 int64,浮点数推导为 float64。在处理图像数据时,若未显式指定 dtype=np.uint8,内存占用会凭空暴增 8 倍。创建数组时显式声明 dtype 是良好的工程习惯。
六、全文总结
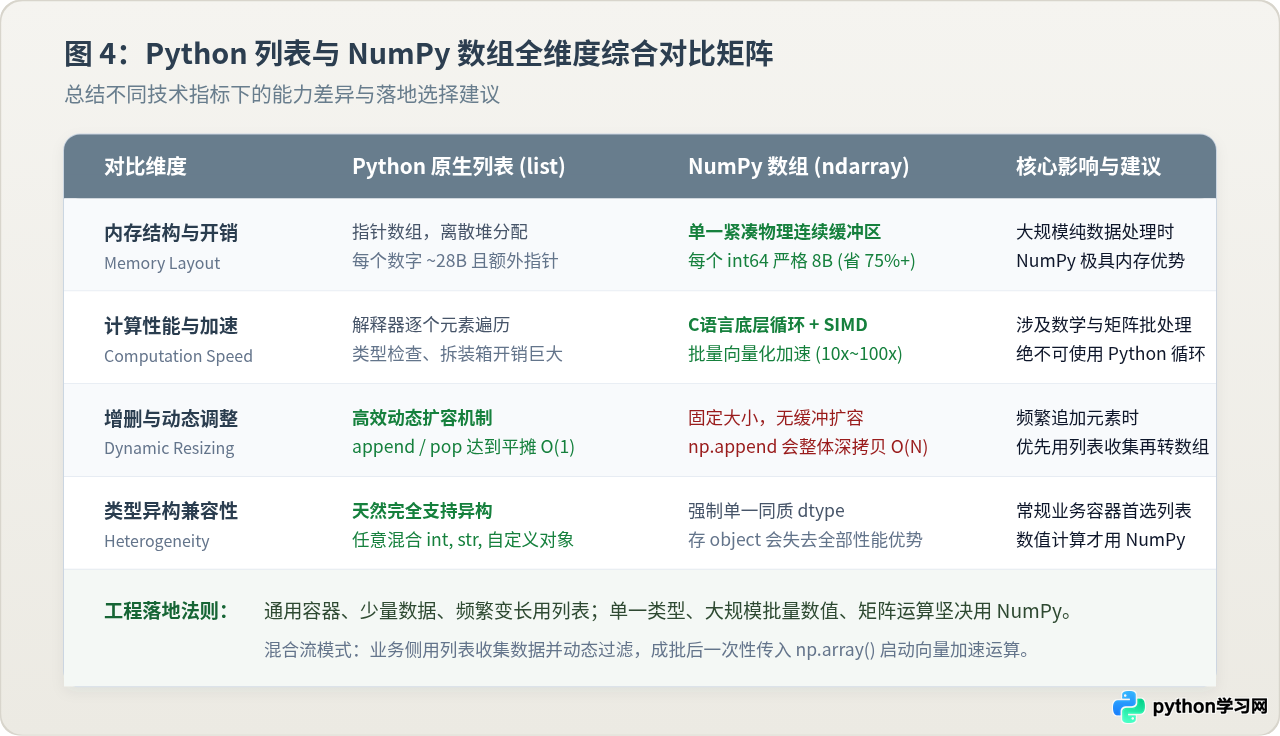
决定何时使用 NumPy 数组代替 Python 列表,核心并不在于“哪个工具更先进”,而在于数据特征与处理方式的匹配度:
- 选择 Python 列表:数据异构多变、需要频繁增删、数据规模小、作为一般性业务数据容器。
- 选用 NumPy 数组:纯数值密集计算、多维矩阵运算、追求毫秒级吞吐量、海量数据集处理以及科学计算生态管道。
在工业级项目中,二者最常见的协作模式是“动静分离”:外层业务逻辑用 Python 原生列表灵活组装与收集数据,核心算法模块将其一次性固化为 NumPy 数组执行向量化加速,从而兼顾业务敏捷度与硬件计算极致性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















