


unittest vs pytest:Python自动化测试框架选型指南
深入对比Python内置的unittest与主流第三方测试框架pytest,从代码组织、断言机制、夹具系统、参数化及执行工作流等多维度解析差异,提供条件明确的工程选型与平滑迁移指南。
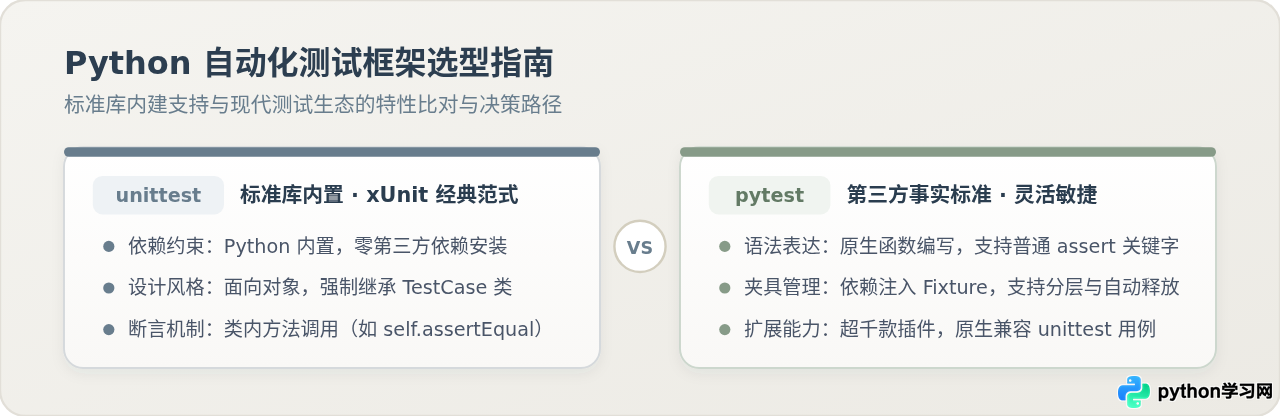
unittest 是 Python 标配的标准库,遵循经典的 xUnit 面向对象范式,核心价值在于零第三方依赖与严格的基类组织;而 pytest 作为主流第三方事实标准,通过原生 assert 关键字重写、基于依赖注入的模块化 Fixture 体系以及超过千款社区插件,大幅削减了样板代码并提供极其精确的断言内省体验。本文将从代码范式、断言机制、夹具生命周期、参数化扩展到执行调试全流程进行深度比对,为工程团队提供条件明确的选型与落地决策路径。
一、编码范式与断言机制:类继承与原生语法的对比
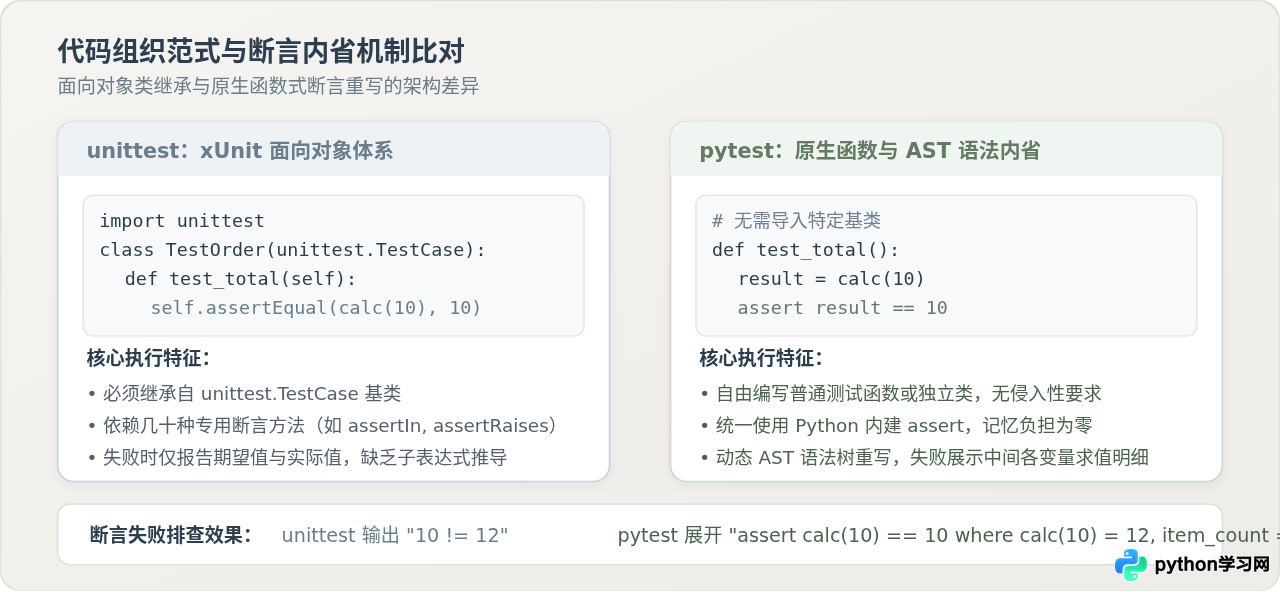
编写测试用例的第一道差异体现在代码的侵入性与语法表达上。unittest 借鉴了 Java JUnit 的 xUnit 架构设计,强制所有测试用例必须封装在继承自 unittest.TestCase 的类内部,测试方法必须以 test_ 前缀命名,断言必须通过 self.assertEqual()、self.assertTrue() 等专门的实例方法完成。
与之相对,pytest 贯彻了现代 Python 的轻量设计哲学。它允许测试直接编写为自由的全局函数(也可以按需放置在无需继承特定基类的普通类中),且测试断言仅使用 Python 原生的 assert 关键字。
代码对比:电商折扣计费测试
假设待测试的业务函数为 calc_order_amount(price, member_level, coupon),我们需要验证当金牌会员(享受 8 折优惠)且无优惠券时,计算出的最终金额是否符合预期。
# test_billing_unittest.py
import unittest
from billing import calc_order_amount

class TestBilling(unittest.TestCase):
    def test_gold_member_discount(self):
        original_price = 100
        member_level = "gold"
        final_price = calc_order_amount(original_price, member_level, coupon=None)

        # 必须使用 unittest 提供的断言方法
        self.assertEqual(final_price, 80)
        self.assertIsInstance(final_price, (int, float))

if __name__ == "__main__":
    unittest.main()
# test_billing_pytest.py
from billing import calc_order_amount

def test_gold_member_discount():
    original_price = 100
    member_level = "gold"
    final_price = calc_order_amount(original_price, member_level, coupon=None)

    # 直接使用 Python 内建 assert
    assert final_price == 80
    assert isinstance(final_price, (int, float))
断言失败后的内省诊断(AST 重写差异)
在测试通过时,两种风格的代码差异仅仅体现在行数上;但一旦测试失败,底层机制的悬殊差异便直接影响开发人员的排错效率。unittest 在断言失败时,通常仅报告传入断言方法的最终值:
在实际排查中,面对“85 != 80”,工程师必须手动在代码中插入断点或打出 print 语句,才能看清究竟是折扣率计算有误还是计入了额外费用。
而 pytest 采用 AST(抽象语法树)重写机制。在执行测试文件前,pytest 会动态拦截并解析 assert 表达式,自动捕获表达式中所有子节点与变量的实时中间结果。发生失败时,它会自动在终端展开完整的上下文推导链:
这种详尽的中间状态内省由框架在后台自动完成,不需要编写任何附加诊断代码,显著减少了调试用例的往返时间。
二、测试夹具与状态管理:生命周期钩子 vs 依赖注入
自动化测试的可靠性极大地依赖于测试环境的准备与清理(如初始化数据库连接、生成临时测试数据、模拟外部 HTTP 客户端)。如果状态清理不干净,测试用例之间就会发生污染,产生难以复现的偶发错误。
unittest:经典的面向对象生命周期
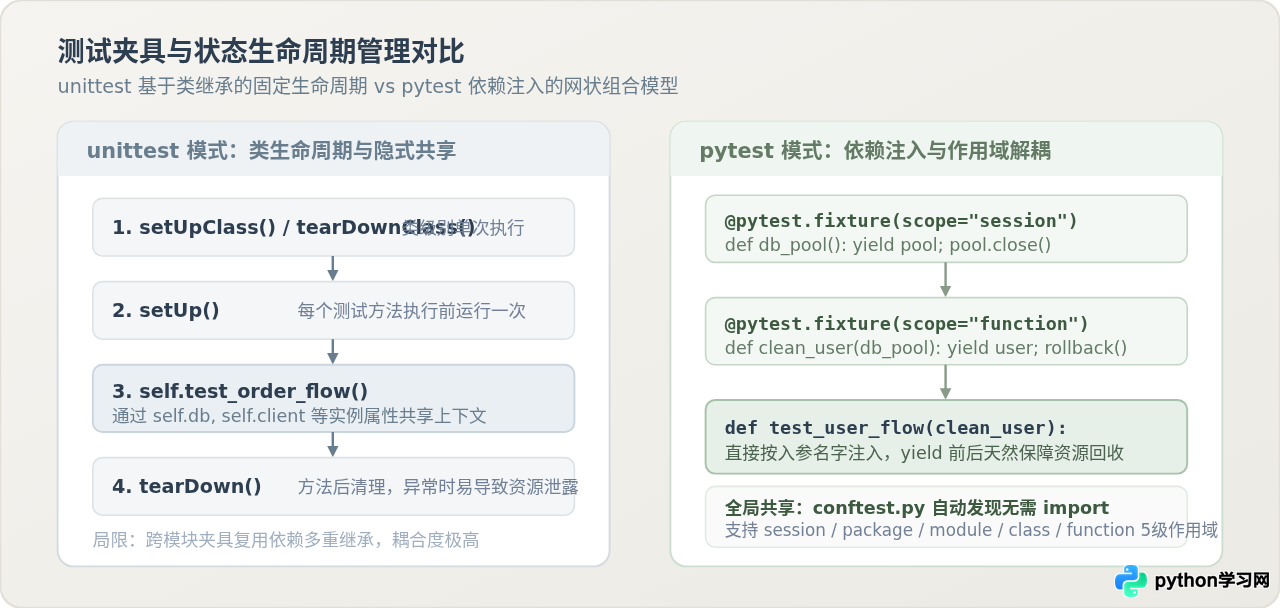
unittest 沿用了基于类的生命周期模型:
setUpClass()与tearDownClass():类级别的类方法,在当前测试类的所有方法运行前后各执行一次。setUp()与tearDown():方法级别的实例方法,在每一个test_*方法运行前后执行。
在 unittest 中,多个测试方法若要共享准备好的资源,必须将资源绑定在 self 实例上(例如 self.db = init_db())。这种机制存在两个显著短板:第一,如果 setUp() 在中途崩溃,tearDown() 默认不会被触发,极易引发连接泄露;第二,当多个不同的测试类需要复用一套通用的夹具逻辑时,必须通过 Python 的多重继承来实现,极易造成基类臃肿与层级固化。
pytest:声明式依赖注入与精细作用域
pytest 彻底摒弃了类继承模式,引入了函数式依赖注入的 Fixture(夹具) 体系。通过 @pytest.fixture 装饰器,任何函数都可以成为一个测试依赖源:
# conftest.py
import pytest
from myproject.db import DatabaseSession

@pytest.fixture(scope="session")
def db_engine():
    # Session 作用域:整个测试套件仅启动一次连接池
    engine = DatabaseSession.create_engine("test_db.sqlite")
    yield engine
    # 测试全部结束后自动执行清理
    engine.dispose()

@pytest.fixture(scope="function")
def db_session(db_engine):
    # Function 作用域:每个测试函数享有独立的事务
    session = db_engine.get_session()
    session.begin()
    yield session
    # 无论测试成功还是断言抛错,均自动回滚保障隔离
    session.rollback()
    session.close()
# test_user.py
def test_create_user(db_session):
    # 只要在参数列表中声明 db_session,pytest 会自动完成注入
    user_id = db_session.add_user(name="Alice", role="admin")
    assert db_session.get_user(user_id)["name"] == "Alice"
这种设计带来了三项核心优势:
- 解耦与组合能力:测试函数不需要关心
db_session依赖了什么,Fixture 自身可以像积木一样层层嵌套依赖。 - 5 级作用域精确控制:支持
session(整次测试跑一次)、package(包内共享)、module(单模块共享)、class(类共享)与function(单用例独享),兼顾执行性能与数据隔离。 - conftest.py 全局自动发现:在根目录或子目录放置
conftest.py,其定义的 Fixtures 会被作用域内的测试自动识别,无需在每个测试文件中手动import。
三、数据驱动与参数化测试的实现差异
在验证边界条件、密码强度校验或多规格折扣等业务逻辑时,通常需要使用不同的输入组合重复运行同一段验证逻辑,这就是数据驱动测试(Parameterized Testing)。
unittest 的应对方案
在标准库 unittest 中,原生并不包含开箱即用的参数化装饰器。在不借助外部第三方库的情况下,官方推荐使用 subTest 上下文管理器来模拟:
# test_password_unittest.py
import unittest
from security import validate_password

class TestPassword(unittest.TestCase):
    def test_password_strength(self):
        test_cases = [
            ("12345", False, "密码过短"),
            ("Abc12345!", True, "合规密码"),
            ("abcdefgh", False, "缺少大写与特殊字符"),
        ]
        for pwd, expected, reason in test_cases:
            with self.subTest(password=pwd, note=reason):
                self.assertEqual(validate_password(pwd), expected)
subTest 虽然能避免单个数据失败导致后续数据中断,但在测试报告中,所有数据依然合并算作同一个测试用例执行;IDE 或 CI 工具也无法独立选中某个失败的数据项单独重新运行。
pytest 的原生参数化装饰器
pytest 提供了原生的 @pytest.mark.parametrize 装饰器,能够在收集阶段直接将数据矩阵解包为独立可执行的测试项:
# test_password_pytest.py
import pytest
from security import validate_password

@pytest.mark.parametrize("pwd, expected", [
    ("12345", False),
    ("Abc12345!", True),
    ("abcdefgh", False),
], ids=["short_len", "valid_complex", "missing_uppercase"])
def test_password_strength(pwd, expected):
    assert validate_password(pwd) == expected
在控制台运行测试时,这三组数据会直接表现为 3 个独立命名的用例:
test_password_strength[short_len]、
test_password_strength[valid_complex]、
test_password_strength[missing_uppercase]。
如果其中某一项失败,你可以直接通过 pytest -k short_len 针对该数据单独调试,效率显著提高。
四、测试执行、过滤与调试操作全流程
自动化测试的价值最终落地在本地开发与 CI/CD 流水线的实际执行中。以下展示现代测试工程中标准化的 4 步操作流程。
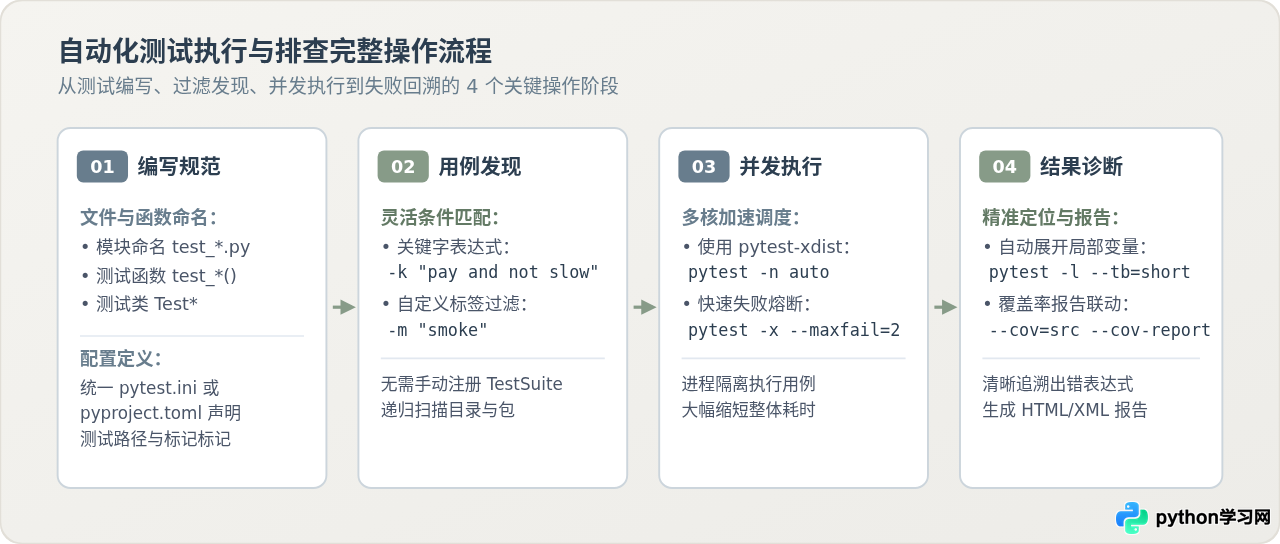
步骤 1:规范化文件结构与基础配置
在项目根目录维护标准的目录结构,建议采用如下组织形式:
my_project/
├── pyproject.toml      # 项目与 pytest 核心配置文件
├── src/
│   └── billing.py      # 业务源代码
└── tests/
    ├── conftest.py     # 公共夹具
    ├── test_billing.py # 核心业务测试
    └── test_auth.py    # 认证权限测试
在 pyproject.toml 中统一声明测试运行参数与标记:
[tool.pytest.ini_options]
minversion = "7.0"
addopts = "-ra -q --strict-markers"
testpaths = ["tests"]
markers = [
    "smoke: 冒烟核心用例",
    "slow: 耗时较长的集成测试",
]
步骤 2:灵活匹配与过滤执行
运行测试无需写冗长的启动脚本,可通过丰富的命令行参数精确匹配执行范围:
- 按关键字匹配函数或类名:
pytest -k "discount or billing" - 排除耗时用例:
pytest -m "not slow" - 仅执行上次失败的用例:
pytest --lf(--last-failed) - 首个用例失败立即终止:
pytest -x
步骤 3:多核并发与性能加速
当测试用例规模达到几百上千时,单进程执行通常需要数分钟甚至更长。通过安装 pytest-xdist 插件,可以一键开启多进程隔离并发:
# 自动根据 CPU 物理核心数分配并行工作进程
pytest -n auto
步骤 4:覆盖率统计与报告导出
配合 pytest-cov 插件,可在执行测试的同时收集代码行覆盖率,并生成标准终端报告与 HTML 页面:
pytest --cov=src --cov-report=term-missing --cov-report=html:cov_html
五、历史资产兼容与综合选型决策
很多工程师担心引入 pytest 会导致现存的 unittest 代码需要全部重构。实际上,pytest 具备向下兼容性:pytest 可以直接发现并无误运行所有 unittest.TestCase 用例。
这意味着团队完全不需要一次性重写老代码,可以直接将 CI 构建脚本中的执行命令从 python -m unittest discover 切换为 pytest,既能享受 pytest 的漂亮终端输出、失败自动重试、多核并发插件,又能让新增加的功能用例直接使用 pytest 风格编写。
关键特性横向维度对照
| 评估维度 | unittest | pytest |
|---|---|---|
| 依赖限制 | 标准库内置,零第三方安装 | 需要通过 pip 安装第三方包 |
| 编码侵入度 | 高(必须继承 TestCase,使用专属方法) | 低(普通函数即可,无继承负担) |
| 断言方式 | 类方法(self.assertEqual 等几十种) | 原生 assert 关键字 + AST 语法内省 |
| 夹具管理 | 固定周期(setUp/tearDown),基于继承 | 函数式依赖注入,5 级作用域,自动解耦 |
| 数据驱动 | 需使用 subTest 或额外安装扩展库 | 原生自带 @pytest.mark.parametrize |
| 生态扩展性 | 扩展难度大,缺乏统一定制的插件生态 | 官方与社区插件超千款(xdist/cov/mock 等) |
| 执行兼容性 | 无法运行 pytest 编写的函数测试 | 完全兼容运行 unittest 的所有测试类 |
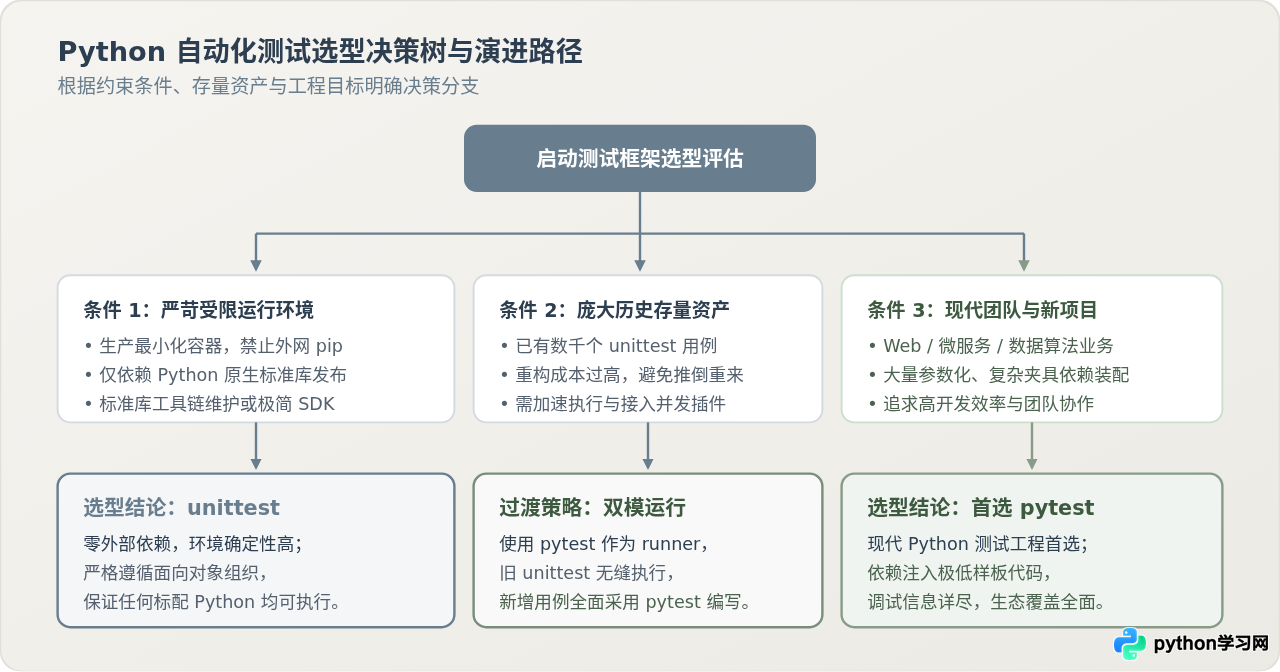
明确的选型决策建议
- 超受限生产环境:生产部署容器严苛隔离,完全禁止访问外网 PyPI 镜像源,且无法维护私有轮子仓库。
- 极简核心库/系统 SDK:编写不依赖任何第三方包的基础运行时组件,要求安装该库的用户获得绝对纯粹的零依赖交付。
- 纯 xUnit 面向对象规范约束:团队工程师主要背景来自 Java/C++,并严格规定必须遵循单一面向对象继承体系组织代码。
- 现代 Web 与微服务系统(如 FastAPI、Django、Flask):需要频繁模拟数据库事务、Redis 缓存与 HTTP Client,pytest 的 Fixture 机制能降低 60% 以上的重复初始化代码。
- 数据分析与算法系统:大量涉及不同数据组合、矩阵输入的校验,
@pytest.mark.parametrize能极大提升测试用例的维护效率。 - 大型工程与快速迭代团队:测试用例数量庞大,必须依赖多进程并发(
pytest-xdist)、按标签分级运行(Smoke/Regression)以及精确失败内省来控制构建时间。
总结而言,对于绝大多数现代 Python 项目,pytest 是兼顾开发人效、测试表现力与工程生态的最佳选择;而对于受限环境与零外部依赖诉求,unittest 则是永远可靠的标准库保底方案。对于存量项目,采用“pytest 作为统一运行器 + 保留旧 unittest 用例 + 新用例全面切换 pytest”的双模推进策略,是成本最低、风险可控的最佳实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















