


Python题库系统高并发随机抽题算法优化与缓存策略
针对Python题库系统在高并发场景下的随机抽题性能瓶颈,深入剖析ORDER BY RAND的全表扫描原因,提供主键池化、蓄水池抽样、Redis分层集合与防重位图的完整优化算法与缓存架构落地实践。
在各类线上模拟考试、课后练习与知识竞赛系统中,高并发随机抽题是核心业务动作,也是后端数据库最具挑战的性能瓶颈之一。解决该问题的关键路径在于彻底转变“数据库承担随机计算”的传统思路,将题库索引与题目详情解耦:利用主键集合池化和应用层快速采样算法消除全表扫描,同时配合 Redis 多级缓存与用户历史答题位图,将题目抽取耗时从数百毫秒压缩至 2 毫秒以内。
一、传统随机抽题为何在高并发下失效
在业务研发初期,最容易写出的抽题 SQL 语句通常如下所示:
SELECT id, stem, options, answer
FROM question_bank
WHERE subject_id = 101 AND question_type = 1 AND is_deleted = 0
ORDER BY RAND()
LIMIT 20;
这条语句在开发测试阶段、题库只有几百道题时执行顺畅。然而,一旦题库扩充至数十万甚至百万级,并在集中考试等高并发场景下(例如数百上千名考生同一分钟进入考场交卷开考),数据库服务器的 CPU 会迅速飙升至 100%,连接池瞬间被打满,最终导致整个系统响应超时崩溃。
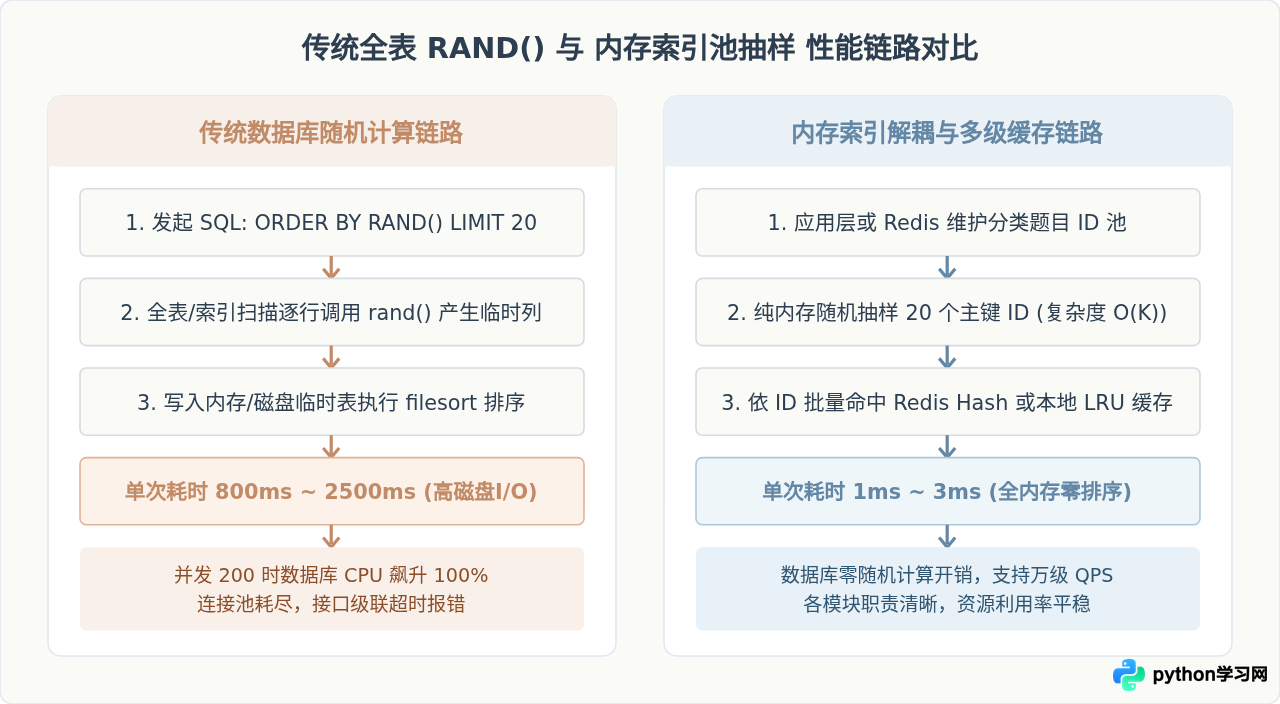
产生这一故障的底层原因在于 MySQL 数据库处理 ORDER BY RAND() 的物理执行机制。当数据库执行该语句时,存储引擎必须对满足 WHERE 条件的每一行记录调用一次随机数生成函数,随后将该随机值与主键写入临时表(通常先在内存临时表中创建,超出容量后溢出到磁盘临时表),最后在临时表中对全量行执行 filesort 归并排序,取前 20 条主键再去主表中回表查找数据。整个流程的计算复杂度为 O(N log N),且产生大量的临时磁盘 I/O 开销与锁争用。
二、算法层优化:解耦随机计算与数据提取
要摆脱全表排序,优化的第一步是在架构设计上实现“算存分离”:随机运算只在紧凑的数值型主键数组中进行,不涉及重量级的题目文本(题干、富文本、选项、解析)检索。只要获得了所需的 N 个题目 ID,后续即可通过主键索引以 O(1) 复杂度直接提取内容。
1. 纯数据库场景的 JOIN 主键随机优化
如果系统尚未引入外部缓存中间件,可以通过两段式 SQL 将全表随机转换为单行随机数的索引范围查找:
SELECT q.id, q.stem, q.options, q.answer
FROM question_bank AS q
JOIN (
    SELECT ROUND(RAND() * (SELECT MAX(id) - MIN(id) FROM question_bank WHERE subject_id = 101) + (SELECT MIN(id) FROM question_bank WHERE subject_id = 101)) AS rand_id
) AS r
WHERE q.subject_id = 101 AND q.id >= r.rand_id
ORDER BY q.id ASC
LIMIT 20;
这种方法利用了 id >= rand_id 的主键索引范围扫描,性能大幅改善。但其缺陷也十分明显:一旦题库中有大量逻辑删除(导致 ID 出现断层空洞),较小断层附近的题目被抽取的概率将发生倾斜;且无法保证在单次抽题中均匀覆盖多种难度和题型分布。
2. Python 应用层内存 ID 池与洗牌采样
更稳健且高效的工程做法是在 Python 进程内或 Redis 中维护精简的主键 ID 列表。例如,10 万条题目 ID 在 Python 列表仅占用几十千字节内存。系统通过 Python 内置的高性能 C 实现随机算法完成抽取,随后一次性并发批量查询:
import random
from typing import List, Dict, Any

class QuestionSampler:
    """题目内存采样器:负责在主键ID集合上执行无损随机抽样"""

    def __init__(self, id_list: List[int]):
        # 内部保存有序或无序的主键列表
        self.id_list = id_list
        self.total = len(id_list)

    def sample_by_reservoir(self, count: int) -> List[int]:
        """
        蓄水池抽样算法 (Reservoir Sampling):
        适用于题库数据流式加载、或者总容量未知/极大的场景。
        时间复杂度 O(N),额外空间复杂度 O(count)
        """
        if count >= self.total:
            return list(self.id_list)

        reservoir = self.id_list[:count].copy()
        for i in range(count, self.total):
            # 生成 [0, i] 之间的随机整数
            j = random.randint(0, i)
            if j < count:
                reservoir[j] = self.id_list[i]
        return reservoir

    def sample_fast(self, count: int) -> List[int]:
        """
        基于 Python C 扩展实现的随机采样:
        内部使用基于 Mersenne Twister 引擎的快速采样,耗时通常在微秒级别。
        """
        if count >= self.total:
            return list(self.id_list)
return random.sample(self.id_list, count)random.sample 可以保证抽出的 N 个 ID 互不重复。如果业务规则要求根据题型(如单选 10 道、多选 5 道、判断 5 道)和难度等级分层抽取,只需分别对各个子分类 ID 列表执行局部采样,最后合并结果即可,完全规避了 SQL 复合条件过滤与全表排序的死锁风险。
三、缓存策略与并发控制架构
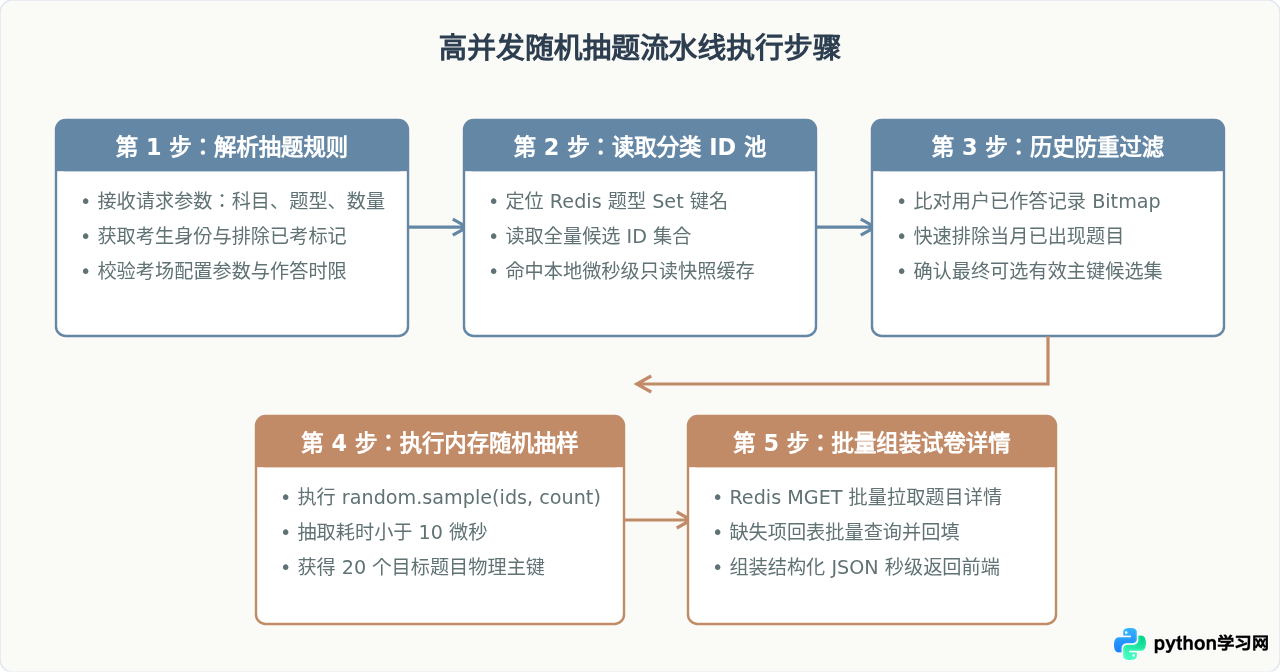
为了支撑数万 QPS 的高并发抽题请求,仅有应用层算法优化仍不够,必须配合合理的分布式多级缓存架构。核心原则是:题库静态化、索引集合化、去重位图化。
1. Redis 键结构设计
- 题库分类索引集合 (Set):针对每种抽题维度建立无序集合。键名格式如
qb:index:{subject_id}:{type}:{difficulty},其成员直接存储题目主键 ID(如整型 10024、10025)。使用SRANDMEMBER key count可以由 Redis 原生在 O(count) 复杂度内返回不重复的随机成员。 - 题目详情缓存 (Hash 或 String):使用
qb:detail:{question_id}保存该题目的完整题干、选项序列化文本。当应用层拿到抽取出的 20 个 ID 后,直接通过MGET进行单次网络往返拉取,极大降低网络 RTT。 - 用户已做记录位图 (BitMap):如果系统要求在练习中“不抽到过去 30 天内做过的题目”,千万级做题记录如果使用关系表
NOT IN查询会导致索引完全失效。此时可以为每个用户建立 BitMap:user:history:{user_id},其中 offset 对应题目 ID。若对应位为 1 表示已做,Python 在内存采样时校验该位即可跳过。
2. 缓存击穿与雪崩的防护策略
在万人同时进入考场的瞬间,极易出现大批量考生抽到相同题目分类并引发缓存击穿的问题。优化措施包括:
- 考试前集中预热:考前半小时由后台定时任务将本场涉及的科目 ID 池与题目详情全量写入 Redis,并将 TTL 设置为当前场次结束时间加 1 小时,规避开考瞬间的冷启动加载。
- 互斥锁与逻辑不过期:对于日常练习题库,题库分类 ID 集合永不设置物理过期时间,当管理员在后台修改、删除题目时,通过异步消息队列更新 Redis 集合与详情缓存,彻底消除缓存穿透与击穿隐患。
- 本地二级缓存 (Local Cache):在 Python 进程内(使用
cachetools.LRUCache)缓存热点题目详情 60 秒,将高频题目的网络访问拦截在 Python 进程内存中。
四、生产级 Python 抽题服务实战
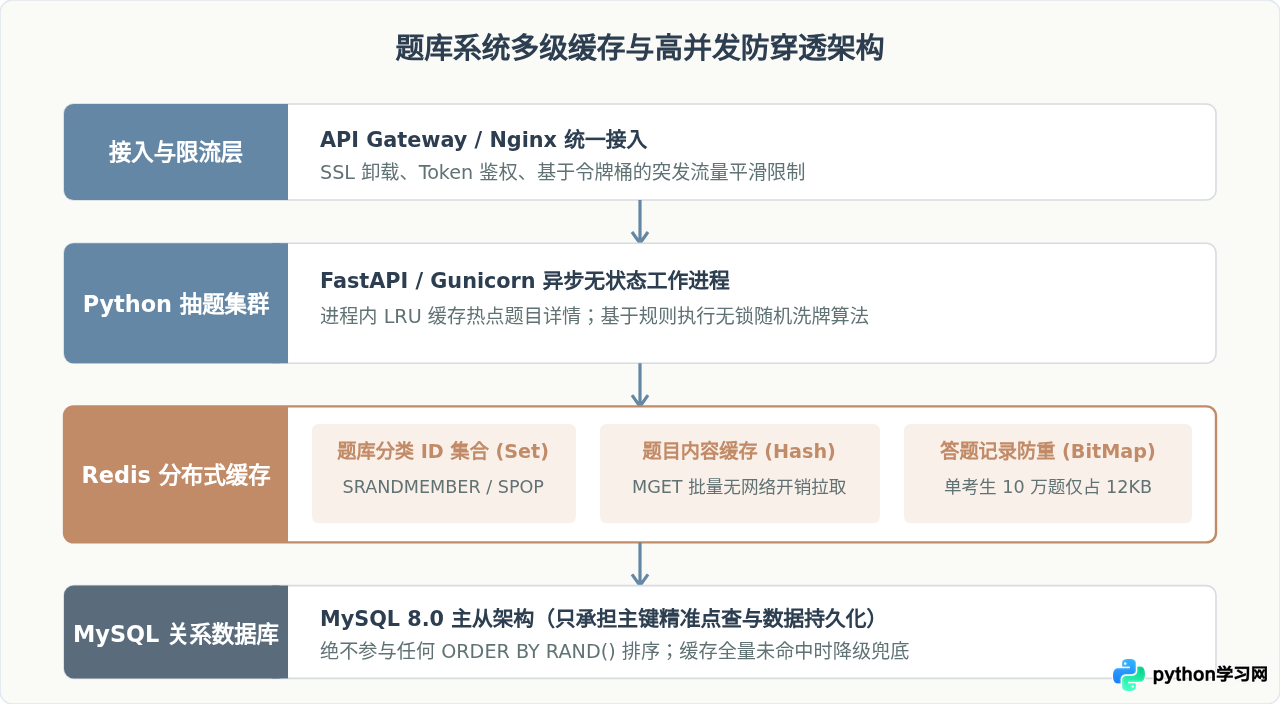
下面给出一个基于 Python 异步框架与 redis-py 连接池的完整抽题服务实现代码,包含规则校验、Redis 集合原子采样、防重位图比对及兜底容灾机制:
import json
import logging
from typing import List, Dict, Any, Optional
import redis.asyncio as aioredis
from pydantic import BaseModel

logger = logging.getLogger("ExamSampler")

class RuleItem(BaseModel):
    subject_id: int
    question_type: int
    difficulty: int
    count: int

class ExamPaperRequest(BaseModel):
    user_id: int
    rules: List[RuleItem]

class AsyncExamService:
    def __init__(self, redis_pool: aioredis.ConnectionPool):
        self.redis = aioredis.Redis(connection_pool=redis_pool)

    async def sample_paper(self, req: ExamPaperRequest) -> Dict[str, Any]:
        """
        根据复合规则抽取整套试卷
        """
        all_selected_ids: List[int] = []
        user_history_key = f"user:history:{req.user_id}"

        for rule in req.rules:
            index_key = f"qb:idx:{rule.subject_id}:{rule.question_type}:{rule.difficulty}"

            # 1. 尝试直接利用 Redis 原生 SRANDMEMBER 抽样 (过采样 1.5 倍以抵消历史重复)
            fetch_count = int(rule.count * 1.5) if rule.count > 0 else 0
            candidate_ids_bytes = await self.redis.srandmember(index_key, fetch_count)

            if not candidate_ids_bytes:
                logger.warning(f"题库集合为空: {index_key}")
                continue

            candidate_ids = [int(cid) for cid in candidate_ids_bytes]

            # 2. 检查用户防重位图
            valid_ids: List[int] = []
            pipeline = self.redis.pipeline()
            for cid in candidate_ids:
                pipeline.getbit(user_history_key, cid)
            bit_results = await pipeline.execute()

            for cid, is_done in zip(candidate_ids, bit_results):
                if not is_done:
                    valid_ids.append(cid)
                if len(valid_ids) == rule.count:
                    break

            # 3. 若过滤后数量不足,说明该考生刷题极多,允许降级补充已做题目
            if len(valid_ids) < rule.count:
                for cid in candidate_ids:
                    if cid not in valid_ids:
                        valid_ids.append(cid)
                    if len(valid_ids) == rule.count:
                        break

            all_selected_ids.extend(valid_ids)

        # 4. 批量拉取题目详情
        paper_questions = await self._fetch_questions_detail(all_selected_ids)
        return {
            "user_id": req.user_id,
            "total_count": len(paper_questions),
            "questions": paper_questions
        }

    async def _fetch_questions_detail(self, qids: List[int]) -> List[Dict[str, Any]]:
        if not qids:
            return []

        detail_keys = [f"qb:detail:{qid}" for qid in qids]
        raw_details = await self.redis.mget(detail_keys)

        results = []
        missing_ids = []

        for qid, data in zip(qids, raw_details):
            if data:
                results.append(json.loads(data))
            else:
                missing_ids.append(qid)

        # 如果发生缓存缺失,执行数据库精准主键点查(单次批量查询)
        if missing_ids:
            db_records = await self._query_db_by_ids(missing_ids)
            results.extend(db_records)
            # 异步回填缓存
            async with self.redis.pipeline(transaction=False) as pipe:
                for rec in db_records:
                    pipe.set(f"qb:detail:{rec['id']}", json.dumps(rec), ex=86400)
                await pipe.execute()

        return results

    async def _query_db_by_ids(self, qids: List[int]) -> List[Dict[str, Any]]:
        # 模拟执行精准主键回表查询:SELECT id, stem, options FROM question_bank WHERE id IN (...)
        logger.info(f"主键点查兜底回表,数量: {len(qids)}")
return [{"id": qid, "stem": f"题目内容 #{qid}", "options": ["A", "B", "C", "D"]} for qid in qids]aioredis.pipeline() 将几十道题目的位图校验压缩在一次网络通信中完成;对于题目详情使用 MGET 进行单批次获取。即使题库中有几十万道题,整个抽取过程网络交互次数被严格控制在 3 次以内,整体耗时稳定在 1.5ms 到 4ms 之间。
五、方案选型矩阵与避坑要点
在实际系统演化过程中,不同阶段的并发量和数据量决定了最佳架构形态。切忌脱离实际业务阶段盲目引入过度复杂的分布式协调架构。
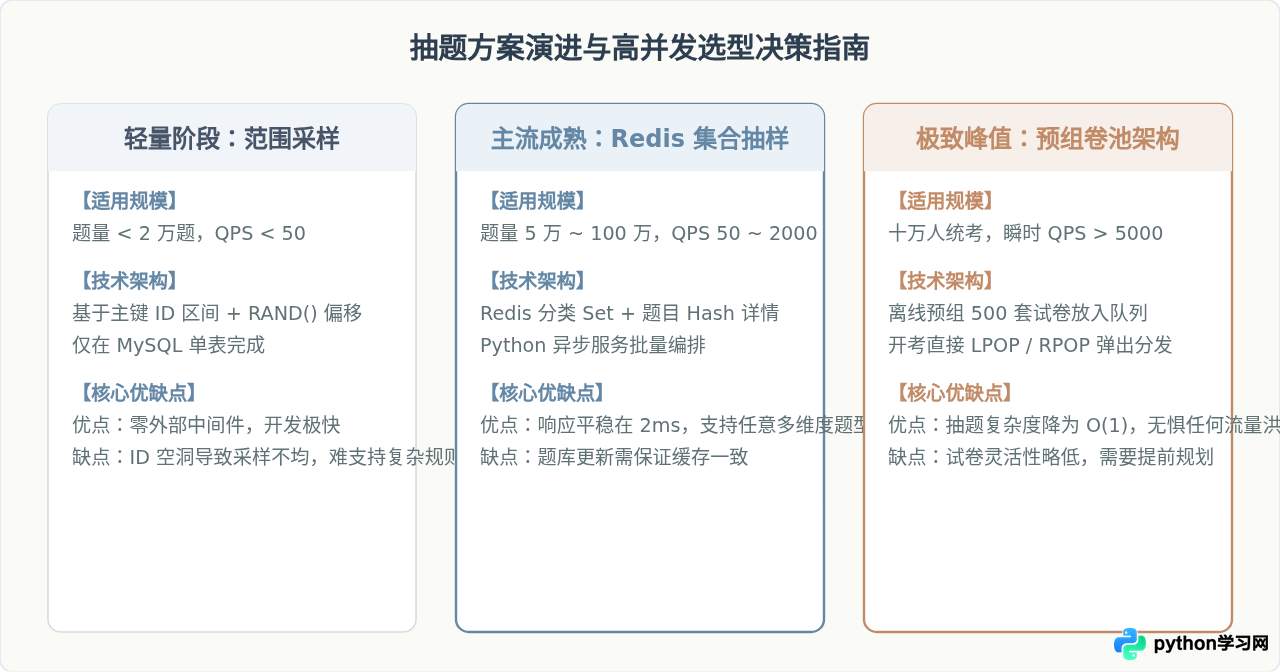
工程落地常见误区与避坑清单
| 常见误区 | 产生后果 | 正确工程做法 |
|---|---|---|
| 在 Redis 中对每个题目设置不同的短 TTL | 并发访问时频繁出现部分题目缓存穿透,导致回表风暴 | 题库分类与详情数据设置较长过期时间或逻辑不过期,统一由后台管理事件异步失效。 |
| 抽题时将 10 万道题完整 JSON 全部拉入 Python 内存 | Python 内存膨胀,垃圾回收 (GC) 停顿导致接口 P99 抖动 | 内存中只存整型 ID(4 字节),仅对最后中选的 20~50 道题目拉取完整 JSON 文本。 |
做题去重使用关系数据库的 NOT IN 子查询 |
用户已做题成千上万条时,SQL 执行计划退化为笛卡尔积全表扫描 | 采用 Redis BitMap 或 Bloom Filter 在内存中做 O(1) 过滤,位图极度紧凑(1 万题仅占 1.2KB)。 |
| 开考瞬间所有用户同时向后端请求动态随机抽卷 | 瞬时 QPS 超出服务器 CPU 上限,连接池打满 | 统考场景采用“预组卷池”策略,提前生成大量试卷实例,开考直接发放预热试卷。 |
综上所述,Python 题库系统在高并发随机抽题场景下的性能优化,本质是通过“以空间换时间”和“以内存换磁盘”的解耦思想。将昂贵的动态全表随机运算剥离出数据库核心链路,通过整型 ID 集合池化、Python 内存无锁洗牌抽样、Redis 分层缓存与用户位图去重,能够在数十万题库规模下保持单次抽题 2ms 左右的极速响应,从而为大规模线上考试和日常刷题提供坚实可靠的架构支撑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















