


大模型文件太大下载中断?Git LFS断点续传与多线程加速技巧
针对大模型下载中断和速度慢的问题,本文基于Windows环境下的Git LFS机制,解析如何保留已下载对象、理解断点续传的真实边界、合理设置并发传输参数,以及下载后的完整性验证方法,避免盲目重下或错误配置。
模型已经下载了大半,网络突然断开,再次尝试时进度条却从头开始。这种时刻最让人焦虑的并非网速慢,而是无法确定之前的等待是否付诸东流。于是,有人选择删除整个仓库重来,也有人试图将并发连接数拉满,结果往往导致更多的超时与错误。
另一个常见的误区是将“仓库克隆成功”等同于“权重下载完成”。目录中虽然文件名齐全,但可能仍是指向远程存储的LFS指针文件,一旦加载模型便会报错。要解决这类问题,首先要保住已有数据,再厘清实际的传输机制。
Git LFS能够复用本地已完成的对象,部分中断的传输也可能利用续传机制,但这取决于服务器支持;多文件并发也不意味着自动将单个大文件切分加速。理清这些边界,才能让下载过程真正可控。
已经下载的别急着删:先确认缺的是哪一层
以Windows系统中一个已经克隆到本地的模型仓库为例,首要原则是保留现有的工作目录和.git文件夹。切勿执行重建仓库或清理LFS缓存等操作,因为其中可能已经存储了部分完整下载的权重,删除只会导致后续重复传输。
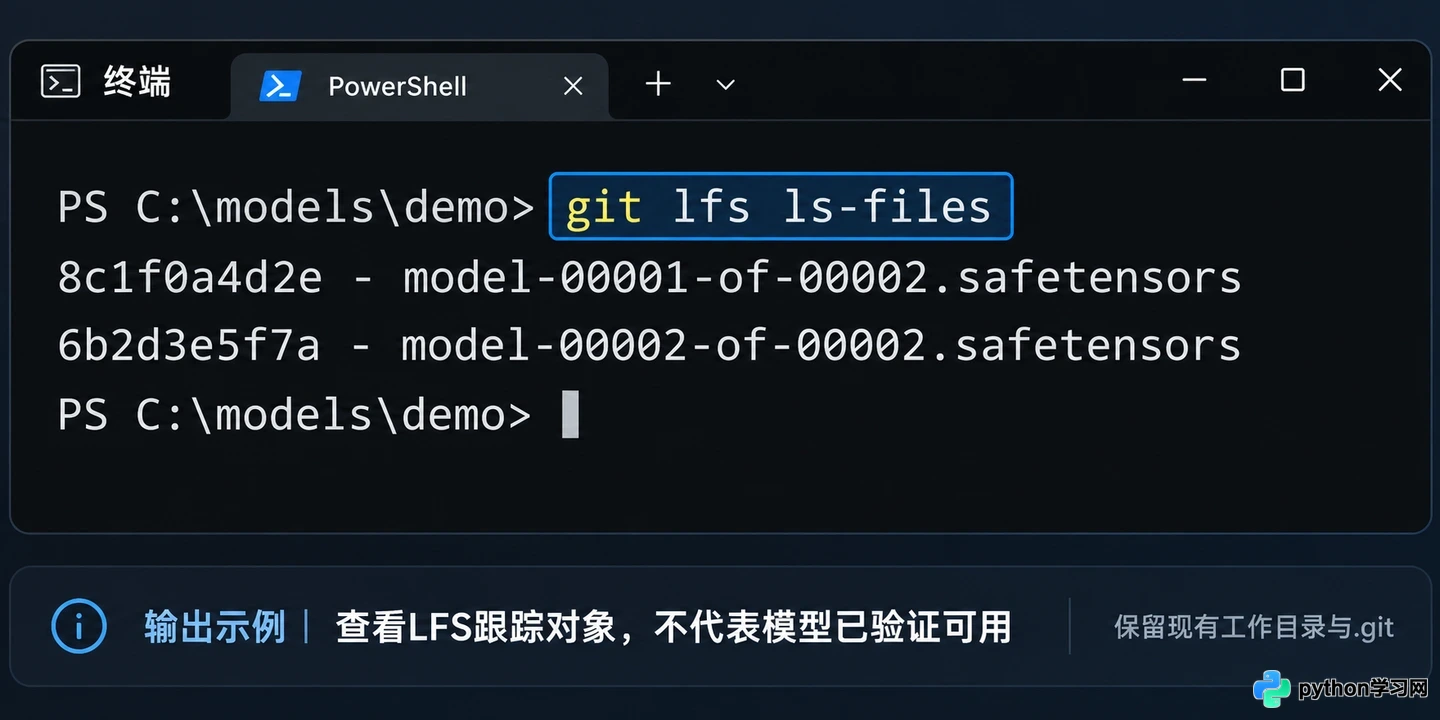
在Windows终端中检查LFS跟踪对象状态
在终端进入该仓库目录后,首先使用git lfs version确认客户端可用,接着运行git lfs ls-files查看当前引用中的LFS跟踪对象。这一步是在检查文件的管理状态,而非运行模型,更不能仅凭文件扩展名判断其内容是否完整。
若需要继续获取当前检出版本所需的对象,应使用git lfs pull命令。该命令会下载当前分支需要的LFS对象,并在必要时将内容检出到工作区,这与仅更新普通Git提交的操作有本质区别。
如果远端仓库名称不是默认的origin,或者存在多个分支及特殊的下载适配器,应先核对实际配置。许多模型托管平台使用独立的存储后端,不能直接将平台专用下载器的缓存逻辑套用在Git LFS流程中。
最关键的是保持可恢复的状态。如果发现某个权重文件只有几行指针文本,应优先检查LFS下载是否完成,而不是修改扩展名后强行交给推理程序。
断点续传有前提:重新执行不等于必然从原字节继续
网络恢复后继续同一仓库的下载,Git LFS可以复用已有的完整对象。但对于尚未完成的大对象,能否从中间继续传输,还取决于客户端版本、传输适配器、临时文件状态以及服务器的响应策略。
Git LFS的基本下载实现中包含基于HTTP范围请求(Range Request)的续传处理,但这需要服务端配合。如果服务器拒绝范围请求,客户端可能会退化为重新下载整个文件。此时进度条看似重来,并不代表本地所有缓存都已失效,已完成的独立文件依然会被保留。
因此,“断点续传”需要分两层理解:一是多份权重中已完成的文件能否保留,二是单份尚未完成的权重能否从精确偏移量继续。两者并非同一承诺。混淆这两者,会让正常的协议回退行为被误判为程序故障。
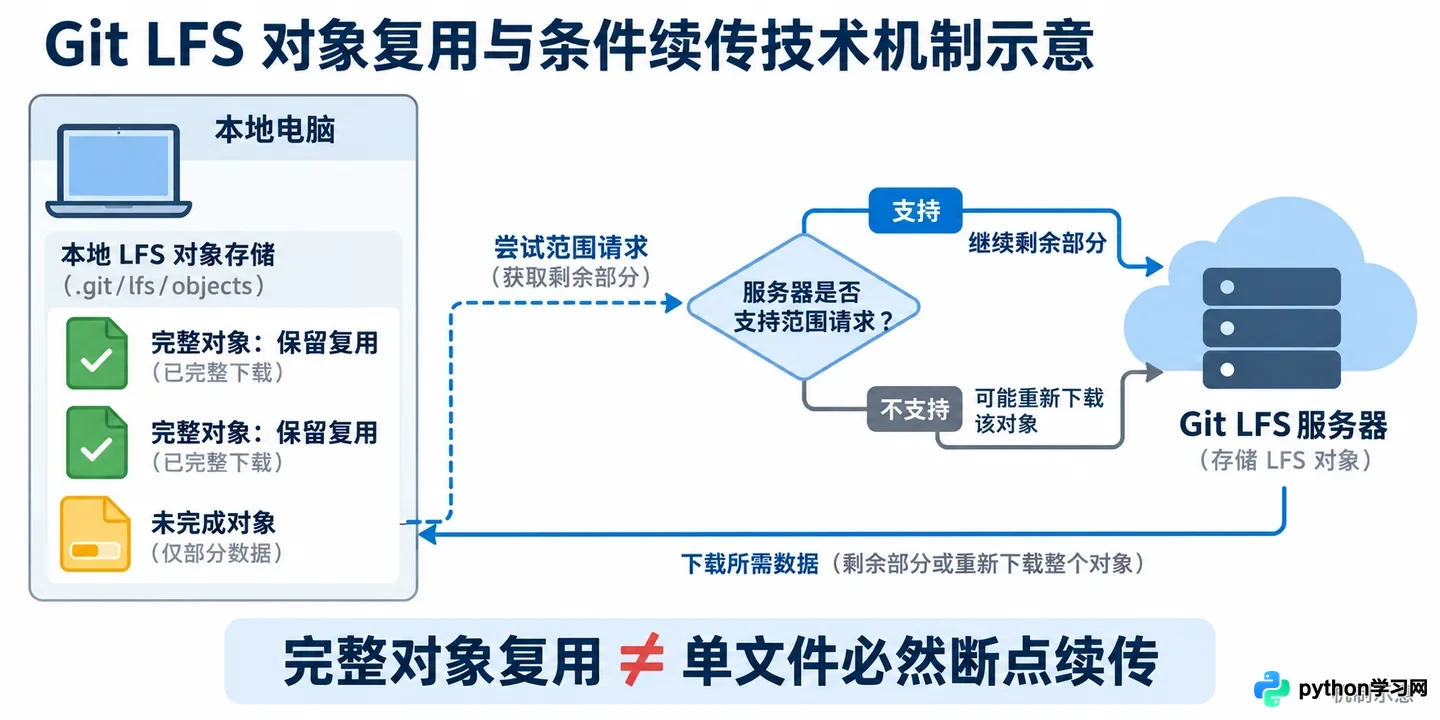
Git LFS断点续传与对象复用机制示意
遇到下载失败时,应先记录错误类别、客户端版本及发生阶段。切勿参照网络碎片教程手工重命名.git/lfs/incomplete目录中的临时文件,也不要随意拼接两个半截文件。这些操作依赖具体的内部实现,极易破坏原本能够自动恢复的状态。
此外,如果涉及受限访问的模型仓库,必须确认账号已获得相应授权。认证失败、下载配额限制与网络中断的处理方向截然不同,反复重试不会自动获取权限,切换下载通道也无法替代合法的访问令牌。
多线程先看文件数量,不是数字越大越快
当一个模型由多份分片组成时,Git LFS可以并发处理多个对象。配置项lfs.concurrenttransfers用于控制并发传输的数量,但其默认行为的并发重点在于“对象数量”,而非自动为单个超大权重文件增加多个分段下载线程。
在同一个仓库中,可以通过以下命令查看是否设置过该项及其来源:
git config --show-origin --get lfs.concurrenttransfers
如果没有显示自定义值,并不意味着客户端没有并发能力,默认值通常由安装版本决定,不应盲目照搬旧教程中的固定数值。
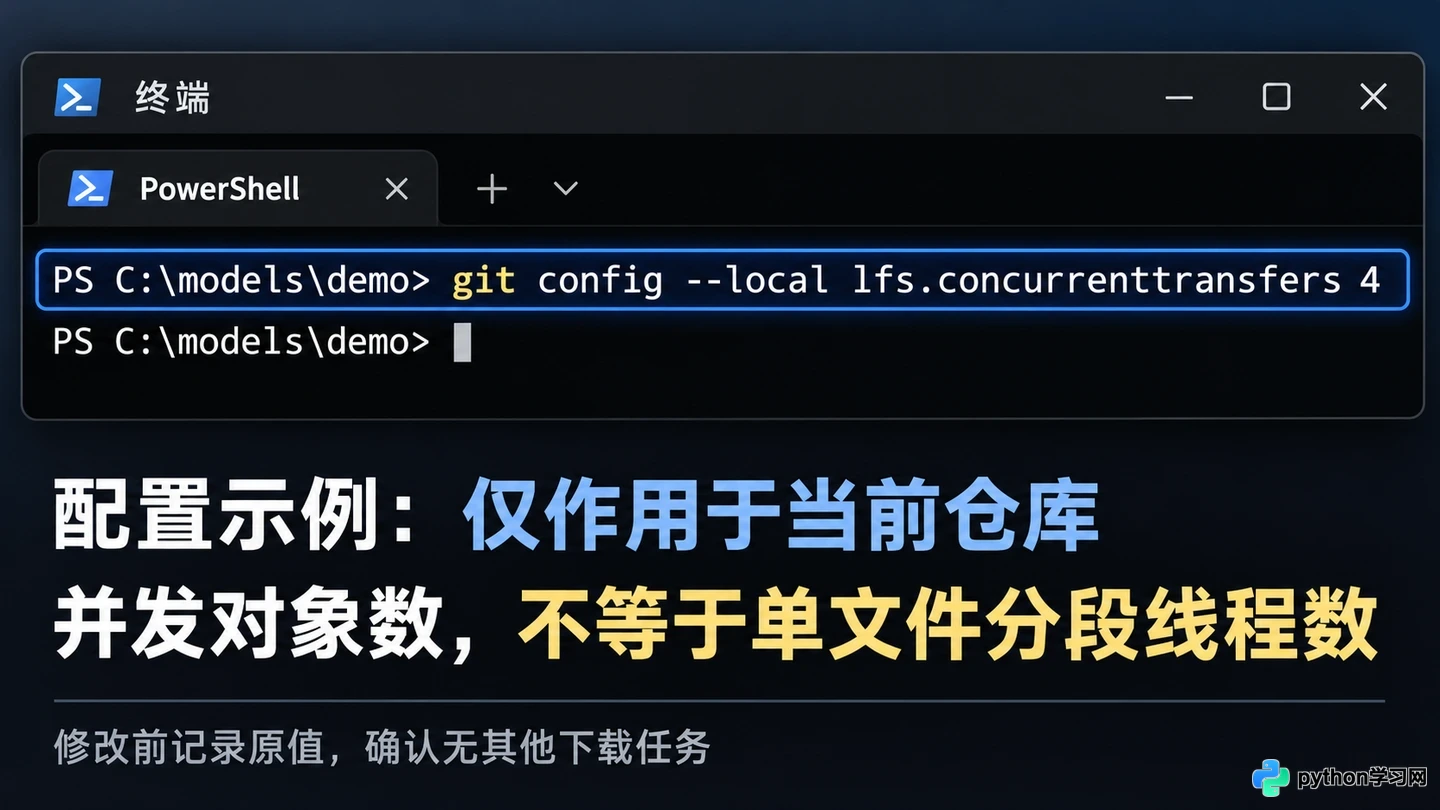
在Windows终端中配置LFS并发传输数
若确需调整,建议先记录旧配置,再仅对当前仓库进行测试。例如,使用以下命令将并发数设置为4,作为一个受控的比较基准:
git config --local lfs.concurrenttransfers 4
修改前需确认没有其他下载任务在同一仓库运行。如果多个分片能够稳定下载,再评估是否有必要增加并发;若出现更多超时、限流或磁盘写入拥堵,应立即降低并发数或恢复原值。
客户端并发能力、服务端限速策略、网络带宽以及磁盘I/O性能共同决定了最终结果,不存在一个设置就能保证倍速的通用公式。当只剩一个大文件时,继续增大该对象的并发设置通常无法解决预期的“单文件多线程加速”问题,此时应检查真实瓶颈及平台支持的其他下载方式。
完成提示之后,还要验证模型是否真的可用
下载结束并不意味着工作完成。首先需确认没有失败的对象,再核对工作区中实际权重大小与项目提供的清单是否一致。如果发布方提供了校验值(如SHA256),应按说明进行核验,不能仅凭文件名相同就认定内容一致。
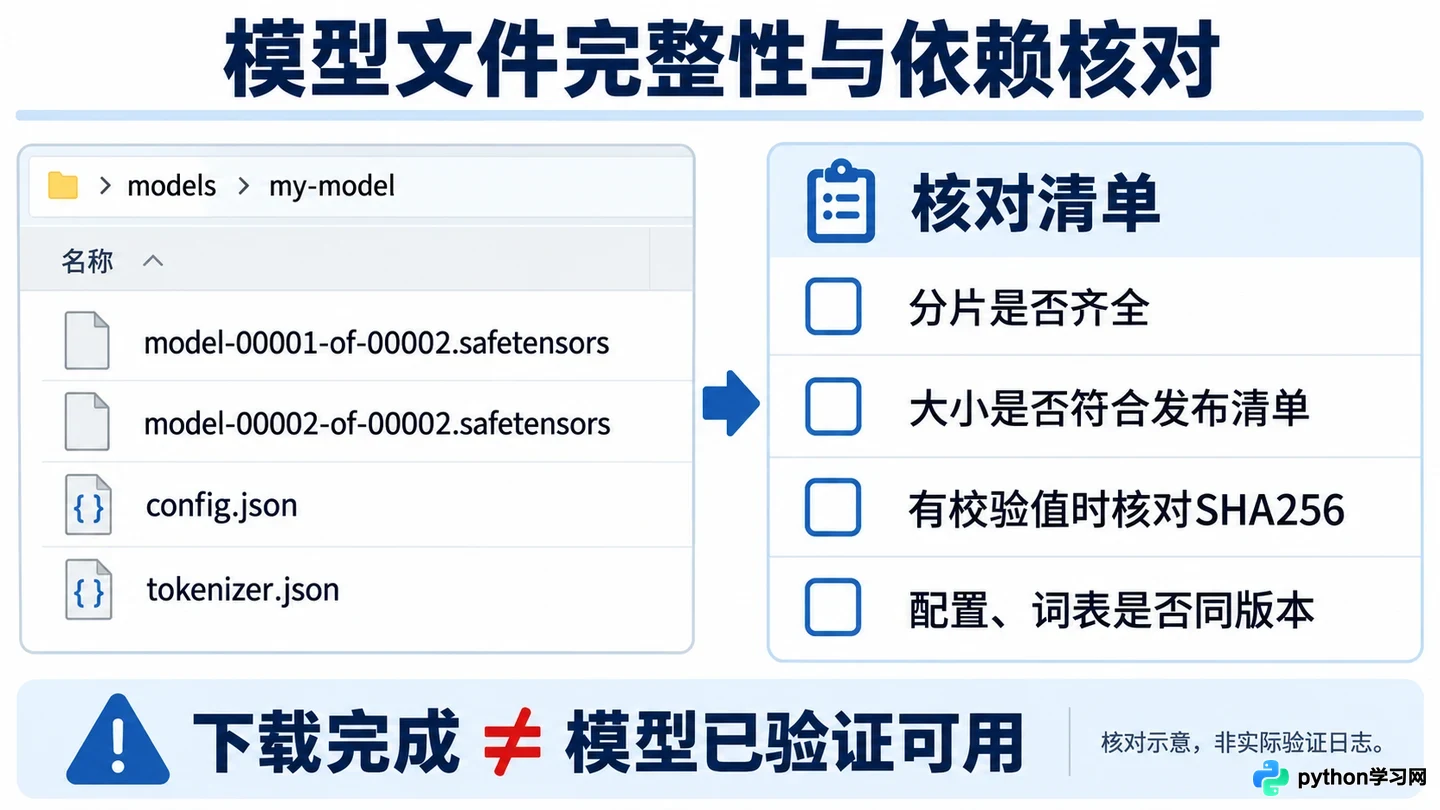
模型文件完整性验证与依赖检查
对于分片模型,还需检查索引引用的权重是否齐全,配置文件、词表等运行依赖是否来自同一个模型版本。仓库中出现几个体积巨大的文件,并不代表整个推理所需的内容都已经准备就绪。
最后才进入模型加载验证阶段。保留原始的报错信息,不要将格式错误、架构不匹配或内存不足等问题统统归咎于下载失败。使用受信任的运行时环境,并审阅仓库关于远程代码执行的安全要求,不为排错而随意开启信任远程代码的选项。
本文中的命令仅为操作示例,未附带实际下载速度或成功日志。判断加速是否有效,需要在相同的网络环境、仓库版本和剩余文件条件下记录结果;不同时间段的两次下载不能直接作为严格的性能对比依据。
大模型下载最值得坚持的顺序,是保留已有数据、确认权限与传输方式、按对象规模调整并发,最后验证文件完整性。能稳定完成并确认可用,比进度条一时跑得快更重要;已经完成的部分,不必为了一个暂时的错误提示而全部推倒重来。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















