


Python列表去重:使用set()快速删除重复元素
详细讲解在Python中使用set()函数快速去除列表重复元素的原理、步骤、注意事项及进阶替代方案。包含完整代码示例与四幅原生SVG图解。
set()再转回列表,是删除重复元素最简洁、最快速的常用手段。本文将详细讲解这一方法的操作步骤、底层实现原理、性能优势以及使用时的核心限制。
一、核心做法:一行业务代码实现列表去重
对Python列表进行去重,最直观的操作是将包含重复项的列表传给内置函数set(),随后再使用list()将其还原为列表结构。
# 原始列表(包含重复的整型元素)
raw_list = [3, 1, 4, 1, 5, 9, 2, 6, 5]

# 使用 set() 快速去重并转回列表
unique_list = list(set(raw_list))

# 示例输出:[1, 2, 3, 4, 5, 6, 9] (注意:具体输出顺序可能随机改变)
print("去重结果:", unique_list)
在上面的代码中,原始列表中重复出现的数字 1 和 5 只保留了一份,列表长度由原来的 9 缩减为 7。
二、底层原理解析:为什么 set() 去重如此迅速?
如果手动使用循环遍历列表去重(即每次检查新列表中是否已包含当前元素),时间复杂度为 O(n²)。因为在列表中执行 item in list 检查需要从头到尾进行线性比对。
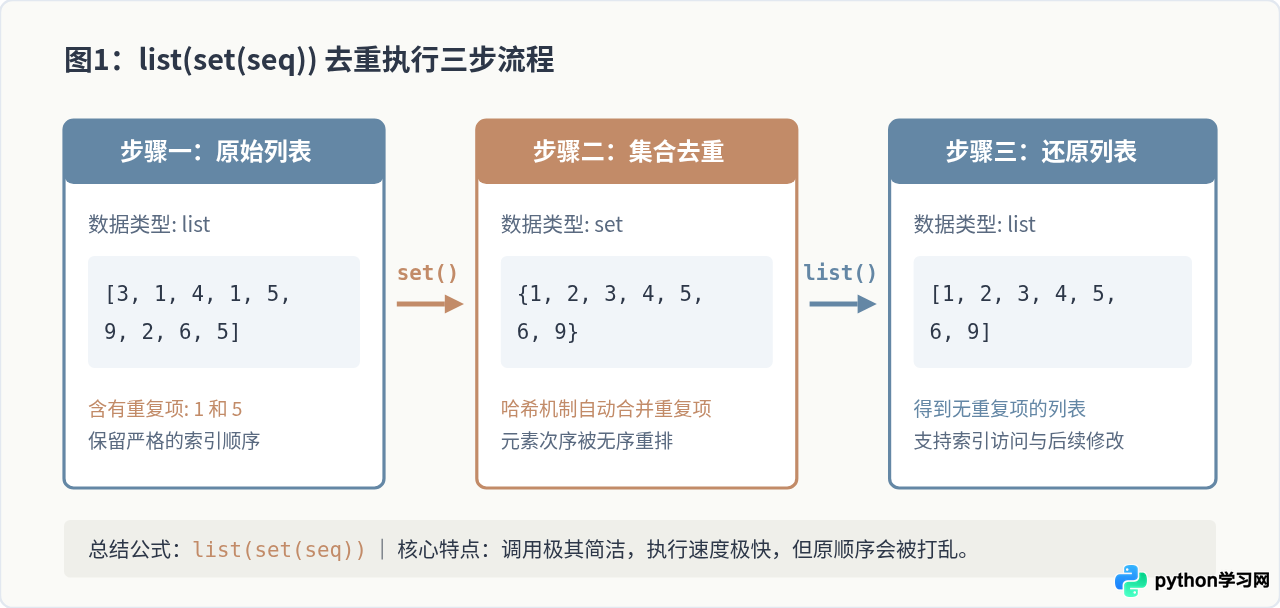
而 set() 的底层实现基于哈希表(Hash Table)。当一个元素被放入集合时,Python 会完成以下动作:
- 调用该元素的
__hash__()方法计算哈希值; - 根据哈希值直接定位到内部哈希表的特定槽位(Bucket / Slot);
- 若该槽位已有相同元素,则判定为重复,直接忽略;若无则存入。
因此,集合插入和成员查重的平均时间复杂度为 O(1)。对包含 n 个元素的列表完成去重,总时间复杂度仅为 O(n),在数据量达到数万或数百万级别时,性能优势极其显著。
三、关键边界:set() 去重的两大局限与应对方案
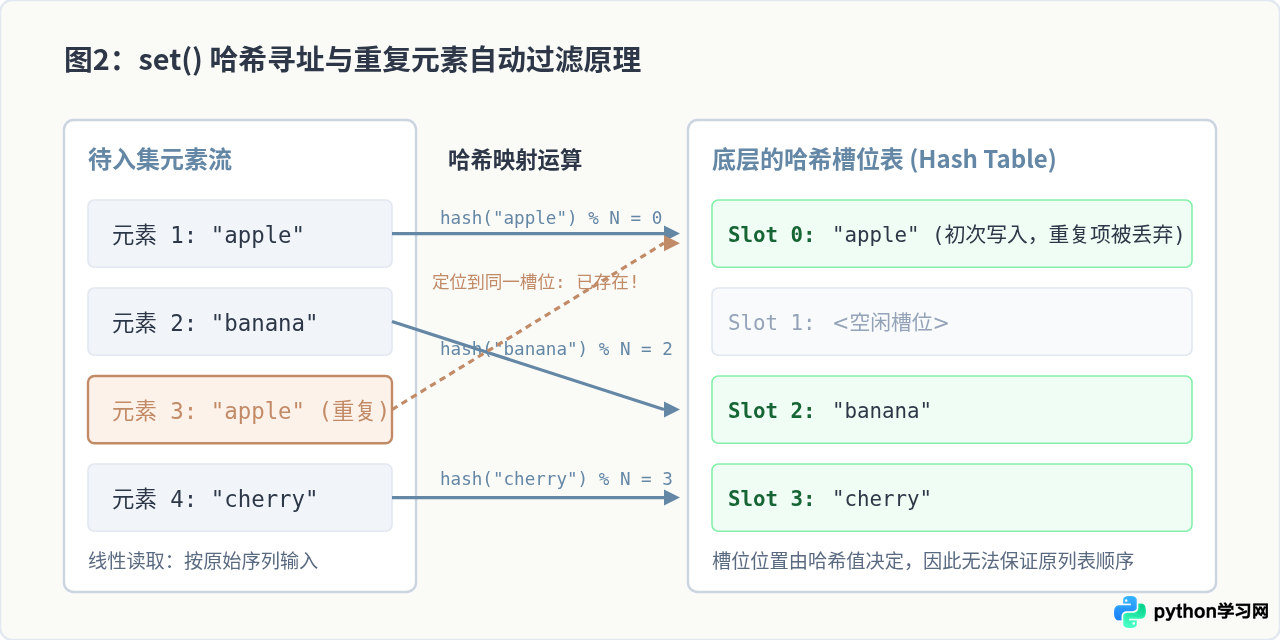
虽然 set() 操作极简且性能极佳,但在实际开发中必须注意以下两大前提限制:
限制一:无法保留原有元素的顺序
由于集合元素是根据哈希值存放于底层哈希表中的,转换成 set 后元素的相对顺序通常被打乱。如果你的业务逻辑对元素出现的先后顺序有严格要求(例如日志时序、榜单排名等),不可直接使用 set() 去重。
保序去重的推荐方案:自 Python 3.7 开始,标准字典 dict 在语言规范层面保证了插入顺序。利用 dict.fromkeys() 可以在去重的同时完整保留元素的初次出现顺序:
# 需要保留原顺序的列表
raw_list = ["b", "a", "c", "a", "b"]

# 保序去重方案:使用 dict.fromkeys()
ordered_unique = list(dict.fromkeys(raw_list))

# 示例输出:['b', 'a', 'c'] (严格保留了原列表中的先后顺序)
print("保序去重结果:", ordered_unique)
限制二:列表元素必须是可哈希类型(Hashable)
集合要求其所有成员必须是可哈希的对象(如 int、float、str、tuple 等不可变类型)。如果列表中包含不可哈希的容器(如嵌套的 list、dict 或其他集合),调用 set() 将直接抛出运行时异常:
# 包含不可哈希类型(列表)的列表
nested_list = [[1, 2], [3, 4], [1, 2]]

# 错误用法:
# unique_nested = list(set(nested_list))
# 抛出异常:TypeError: unhashable type: 'list'

# 解决方案:先将内部子列表转为可哈希的 tuple,去重后再按需转回
tuple_unique = [list(item) for item in set(tuple(x) for x in nested_list)]
# 示例输出:[[1, 2], [3, 4]]
print("嵌套列表去重结果:", tuple_unique)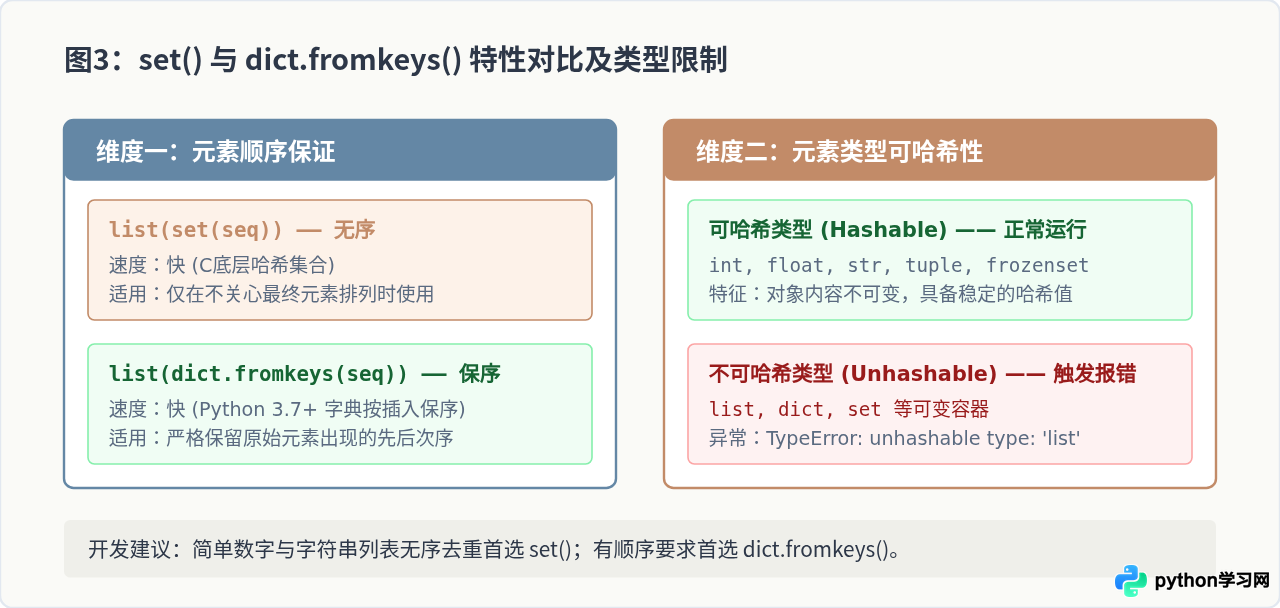
四、常见误区与避坑指南
在部分包含较小连续整数的示例中,执行 list(set([3, 1, 2])) 往往会返回 [1, 2, 3],这容易给初学者造成“set 会自动升序排序”的错觉。实际上这是 CPython 解释器对小整数哈希优化导致的巧合(hash(1) == 1)。一旦数据包含负数、大数或字符串,顺序就会呈现无规律排列,切勿依赖集合的任何顺序特性。
业务开发中常遇到从接口返回的字典列表 [{"id": 1}, {"id": 2}]。由于 dict 是可变对象,直接调用 set() 必然报错。对字典去重应明确按特定字段(如唯一主键 id)在循环中维护一个已见集合,或将字典序列化后再去重。
五、全景决策与方法选型总结
在实际工程中选择列表去重方法,可以通过以下决策路径进行判断:
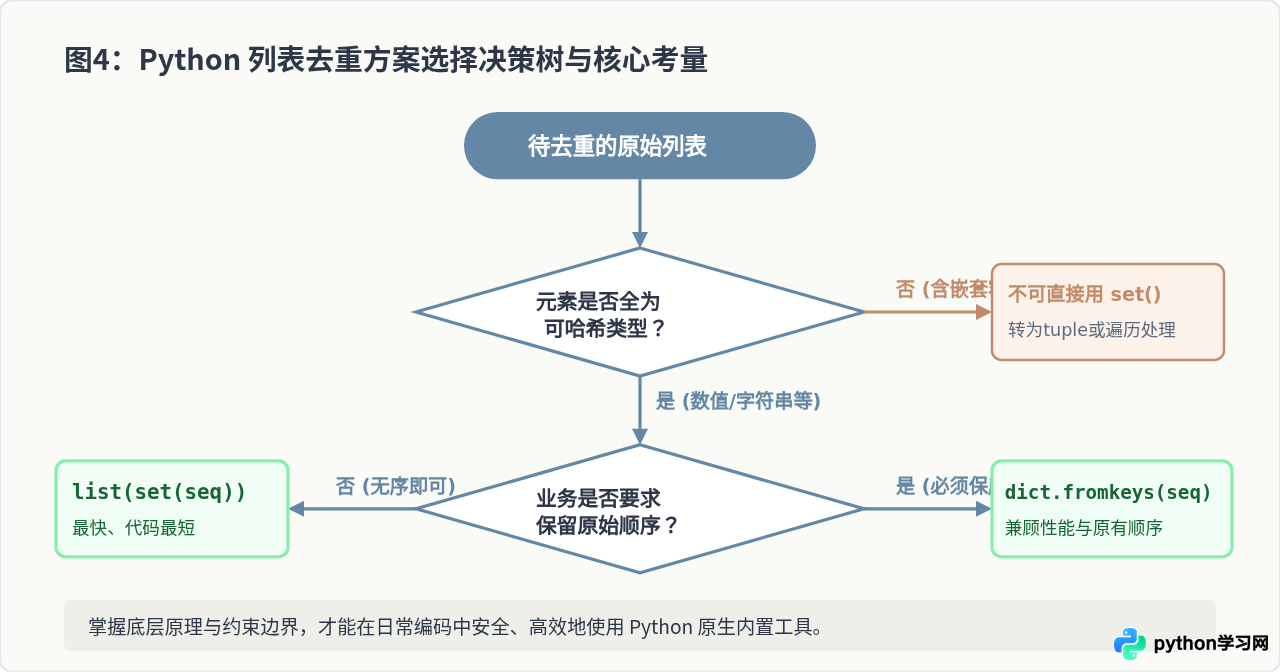
综上所述,list(set(seq)) 是 Python 中针对基础数据类型列表执行快速去重的不二之选。在不需要保留插入次序的场景下,它的执行效率和语法简洁度都无可替代;而在需要保序或面对复杂对象时,配合 dict.fromkeys() 或自定义键映射,即可从容覆盖全部业务场景。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















