


Python多线程与多进程怎么选:GIL机制与IO/CPU密集型场景解析
深入解析Python全局解释器锁(GIL)的工作机理,对比多线程与多进程在IO密集型与CPU密集型场景下的性能表现与资源开销,提供清晰的架构选型依据与生产级代码示例。
一、GIL 机制核心原理与线程调度
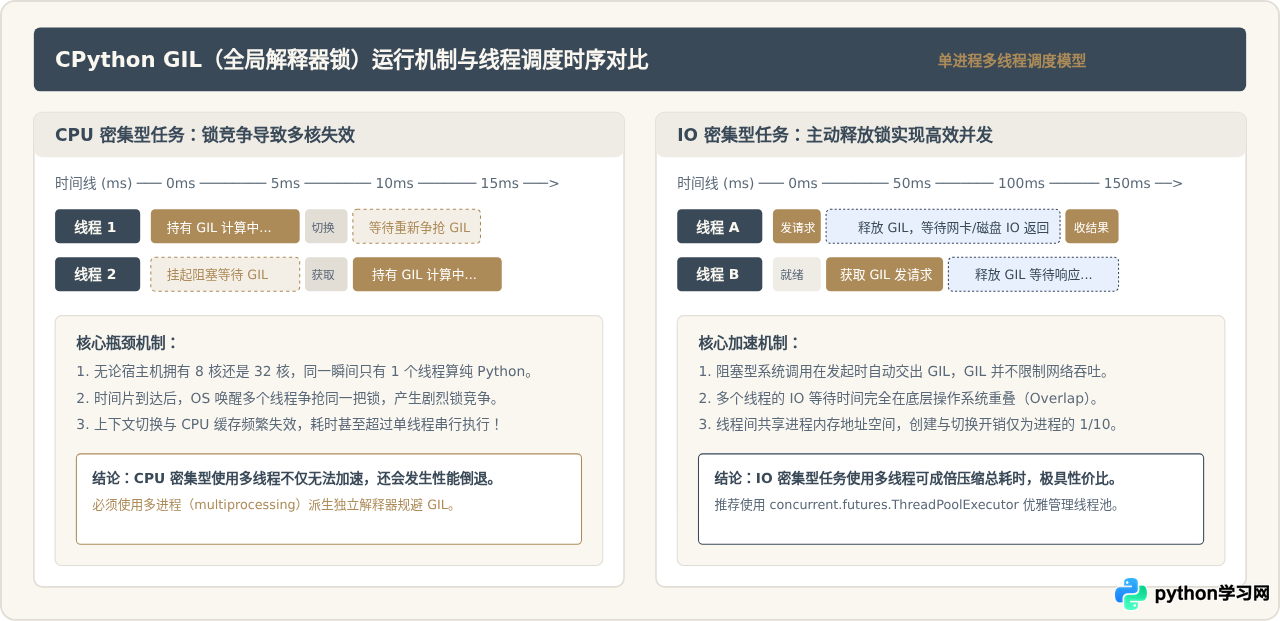
要理解 Python 多线程与多进程的性能分化,首先必须看清 CPython 内部的 GIL(Global Interpreter Lock,全局解释器锁)。GIL 是 CPython 解释器在实现层面引入的互斥锁。它的历史目的是为了保障解释器内部内存管理的安全性,特别是针对 Python 的引用计数垃圾回收机制,防止多个原生线程同时修改对象引用导致内存损坏。
GIL 的存在意味着:在任意给定的时间片内,同一个 Python 进程内部哪怕启动了数十个线程,也只能有一个线程在 CPU 核心上执行 Python 字节码。这意味着纯 Python 实现的代码无法通过原生多线程利用多核算力。
然而,GIL 并非自始至终被同一个线程死锁。CPython 会在两种关键情况下释放锁:
- 系统调用与 IO 阻塞:当线程发起网络请求(Socket)、文件读写、休眠(
time.sleep)等系统调用时,CPython 会在进入底层 C 语言代码前主动释放 GIL;等待结果返回后,该线程再重新尝试获取 GIL。在此期间,其他待命线程可以立即拿到 GIL 继续运行。 - 字节码执行配额切换:为了避免某个计算线程长期独占解释器,CPython 设置了线程切换间隔(在 Python 3 中通常默认为 5 毫秒)。当时间耗尽,当前线程被强制释放 GIL 并触发操作系统调度。
二、IO 密集型场景与多线程实战
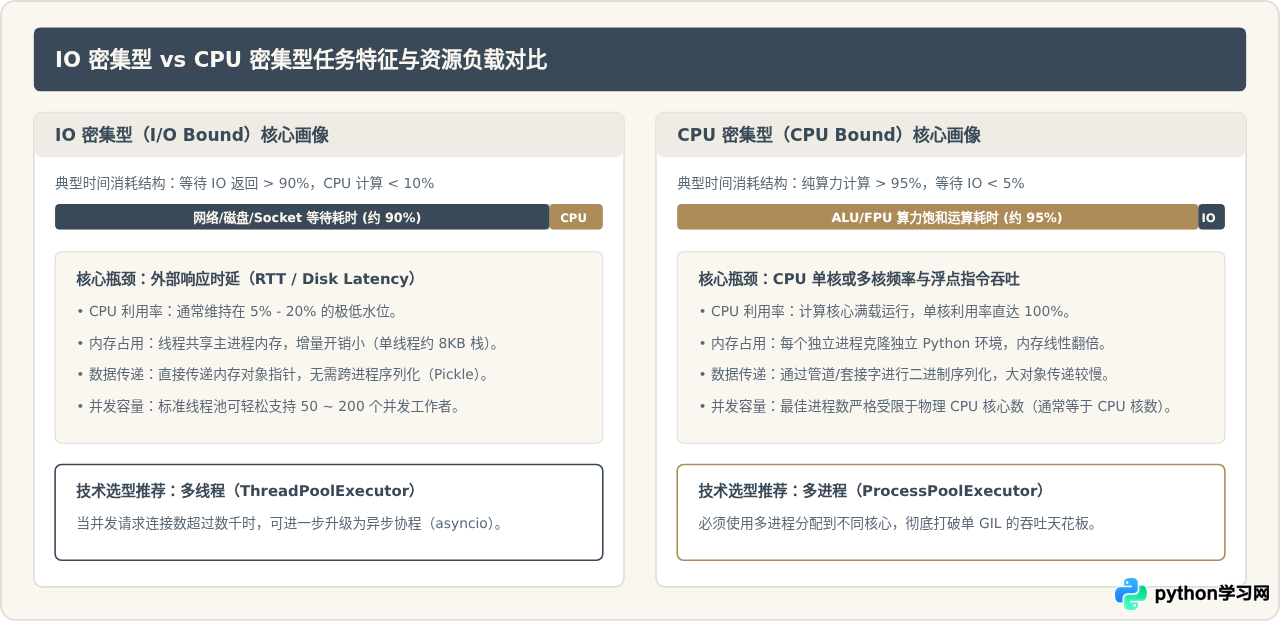
IO 密集型(I/O Bound)任务的本质是:程序执行的大部分时间都耗费在等待外部设备或远端服务的应答上,而 CPU 本身的核心算力处于闲置或极低负载状态。
典型场景包括:
- 抓取外部公开网页、调用微服务 HTTP/gRPC 接口。
- 关系型数据库的大量并发查询与数据入库。
- 文件存储系统中的批量下载、上传或磁盘日志写入。
生产级实现:ThreadPoolExecutor 并发抓取/请求
在现代 Python 中,推荐使用标准库 concurrent.futures.ThreadPoolExecutor 代替底层的 _thread 或手动管理 threading.Thread 列表。线程池提供了内置的任务队列、资源回收和结构化异常捕获。
import time
import urllib.request
from concurrent.futures import ThreadPoolExecutor, as_completed

# 模拟需要并发访问的目标接口列表
TARGET_URLS = [
    "https://api.github.com",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/ip",
    "https://httpbin.org/user-agent",
    "https://httpbin.org/headers",
]

def fetch_url(url: str, timeout: int = 5) -> dict:
    """单个请求任务:典型 IO 阻塞操作"""
    start_time = time.perf_counter()
    req = urllib.request.Request(
        url,
        headers={"User-Agent": "Python-Concurrent-Worker/1.0"}
    )
    try:
        with urllib.request.urlopen(req, timeout=timeout) as response:
            status_code = response.getcode()
            content_length = len(response.read())
            elapsed = time.perf_counter() - start_time
            return {
                "url": url,
                "status": status_code,
                "bytes": content_length,
                "elapsed": round(elapsed, 3),
                "error": None
            }
    except Exception as exc:
        elapsed = time.perf_counter() - start_time
        return {
            "url": url,
            "status": None,
            "bytes": 0,
            "elapsed": round(elapsed, 3),
            "error": str(exc)
        }

def run_io_workload():
    # IO 密集型线程数通常可以设置为核心数的 2 到 5 倍,或固定设置为 10-32
    max_workers = 5
    print(f"启动 IO 线程池并发抓取,工作线程数: {max_workers}")
    total_start = time.perf_counter()

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 提交所有异步任务到线程池
        future_to_url = {executor.submit(fetch_url, url): url for url in TARGET_URLS}

        # as_completed 允许优先处理最先返回结果的任务
        for future in as_completed(future_to_url):
            result = future.result()
            if result["error"]:
                print(f"[失败] {result['url']} 耗时: {result['elapsed']}s, 错误: {result['error']}")
            else:
                print(f"[成功] {result['url']} 状态: {result['status']}, 大小: {result['bytes']}B, 耗时: {result['elapsed']}s")

    total_elapsed = time.perf_counter() - total_start
    print(f"全部任务处理完毕,总耗时: {total_elapsed:.2f} 秒")

if __name__ == "__main__":
    run_io_workload()
对于 IO 密集型,不要把 max_workers 局限在 CPU 核心数。标准库默认值为 min(32, (os.cpu_count() or 1) + 4)。如果你的 IO 操作耗时极长(例如等待外部网络返回 2 秒以上),线程绝大部分时间处于挂起状态,将 max_workers 提高到 50 甚至 100 是安全且能显著提升吞吐的。
三、CPU 密集型场景与多进程实战
CPU 密集型(CPU Bound)任务的特点是:任务执行过程中几乎不需要发生网络交互或磁盘读写,CPU 持续满负荷运转进行数学逻辑运算、位运算或数据重组。
典型场景包括:
- 大批量高清图片的滤镜渲染、缩放和几何变形。
- 海量数据的排序、散列、压缩(如 gzip / zstd)或哈希爆破。
- 机器学习特征工程中的大规模纯 Python 循环与数值计算。
生产级实现:ProcessPoolExecutor 并行数值计算
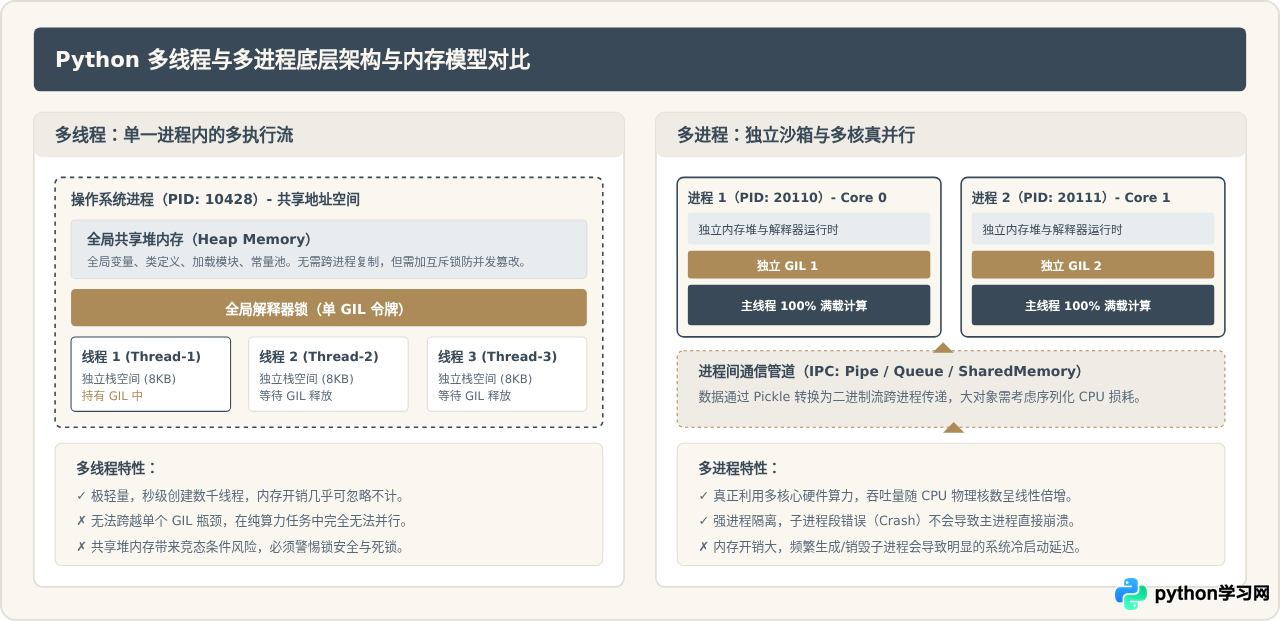
在多进程代码编写中,必须将执行逻辑置于 if __name__ == '__main__': 保护块内部。特别是在 Windows 和 macOS(Python 3.8+ 默认采用 spawn 启动模式)环境下,子进程会作为全新解释器启动并重新导入主模块代码,如果没有该保护会导致子进程递归创建直到系统崩溃。
import math
import os
import time
from concurrent.futures import ProcessPoolExecutor

def is_prime(number: int) -> bool:
    """CPU 密集型判定:大整数质数检验"""
    if number <= 1:
        return False
    if number <= 3:
        return True
    if number % 2 == 0 or number % 3 == 0:
        return False
    i = 5
    while i * i <= number:
        if number % i == 0 or number % (i + 2) == 0:
            return False
        i += 6
    return True

def count_primes_in_range(start: int, end: int) -> int:
    """计算闭区间内的质数数量"""
    pid = os.getpid()
    print(f"[进程 PID: {pid}] 开始统计区间: {start:,} 到 {end:,}")
    t0 = time.perf_counter()
    count = 0
    for n in range(start, end):
        if is_prime(n):
            count += 1
    duration = time.perf_counter() - t0
    print(f"[进程 PID: {pid}] 统计完毕,找到质数 {count} 个,耗时: {duration:.3f}s")
    return count

def run_cpu_workload():
    # 划分 4 个大范围区间的计算切片
    total_range = 8_000_000
    num_splits = 4
    step = total_range // num_splits
    ranges = [(i * step, (i + 1) * step) for i in range(num_splits)]

    # 获取物理/逻辑 CPU 核心数
    cpu_cores = os.cpu_count() or 4
    print(f"检测到本机可用 CPU 核心数: {cpu_cores}")
    print(f"启动 ProcessPoolExecutor 多进程并行计算...")

    start_time = time.perf_counter()

    # CPU 密集型任务,通常 max_workers 设置为等于物理/逻辑核心数
    with ProcessPoolExecutor(max_workers=min(cpu_cores, len(ranges))) as executor:
        # 使用 executor.map 按顺序分发切片并归集结果
        results = executor.map(count_primes_in_range, [r[0] for r in ranges], [r[1] for r in ranges])
        total_primes = sum(results)

    total_duration = time.perf_counter() - start_time
    print(f"全部计算完成!区间 0 到 {total_range:,} 内共有质数 {total_primes:,} 个")
    print(f"多核并行执行总耗时: {total_duration:.3f} 秒")

if __name__ == "__main__":
    # 强制在主模块入口执行,保障跨平台 spawn/fork 安全
    run_cpu_workload()
四、多进程与多线程的关键陷阱与权衡
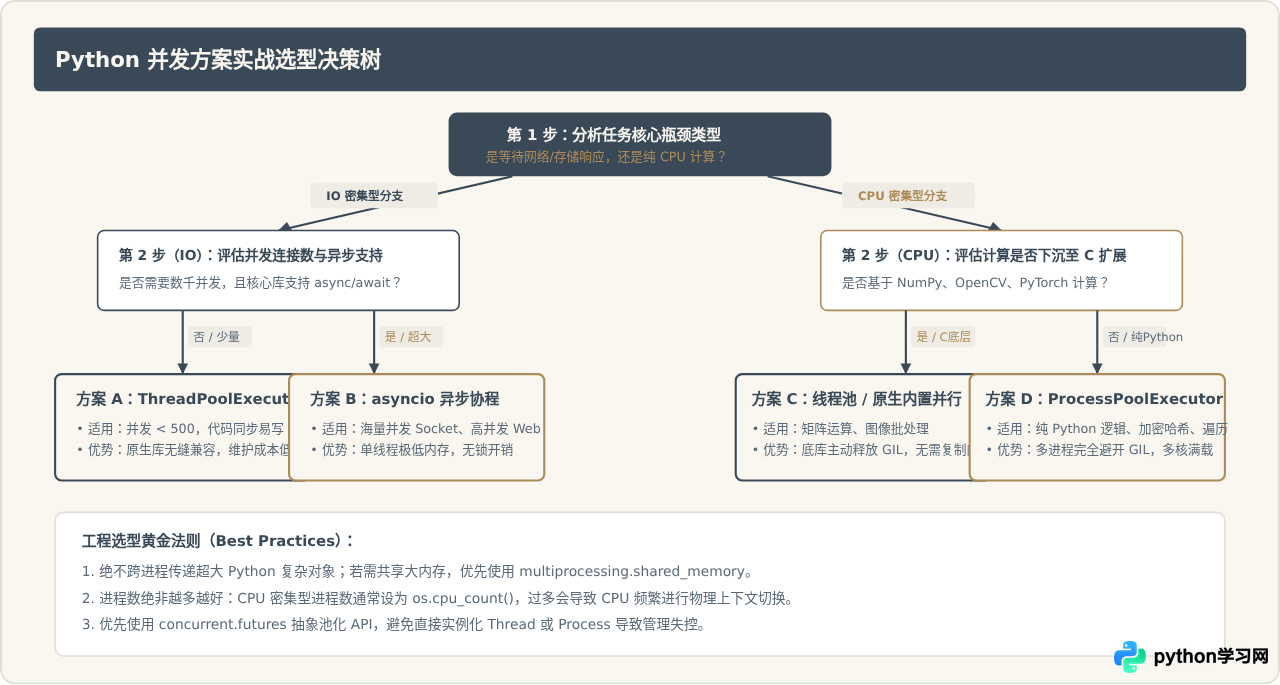
并发并非银弹。盲目套用多进程或多线程经常会导致吞吐量反而下降,以下是实际工程中最高频出现的 4 个陷阱:
1. 多进程的数据序列化(Pickle)反噬
主进程向子进程分发任务参数,以及子进程向主进程返回计算结果时,底层必须经历 pickle.dumps()(序列化)和 pickle.loads()(反序列化)。
如果你试图用多进程处理一个 2GB 大小的 Pandas DataFrame,或者传输深度嵌套的自定义 Python 类实例,仅序列化和跨进程传输的耗时,就可能远远超过多核带来的算力红利。
应对策略:使用 multiprocessing.shared_memory(共享内存)或预先将大文件切片落地为独立磁盘文件,仅向子进程传递文件路径或内存块偏移量。
2. 多线程的共享状态与隐形竞态
虽然多线程受 GIL 保护,但 GIL 绝不等于线程安全(Thread Safety)。
例如 count += 1 在 Python 字节码层面由 4 条指令组成:读取、加载、相加、回写。如果在回写前发生 GIL 时间片轮转,多个线程操作同一全局变量就会发生更新丢失。
应对策略:对所有非原子操作显式使用 threading.Lock 或 threading.RLock,或者使用线程安全的 queue.Queue 进行线程间解耦。
3. 进程创建模式:fork vs spawn 的死锁深坑
在 Linux 系统上,多进程默认采用 fork;而在 Windows 和 macOS(Python 3.8+)上采用 spawn。
如果一个程序在主进程中已经启动了多线程并持有锁,随后调用 os.fork(),子进程只会复制调用 fork 的单条线程,而其他线程持有的锁永远不会被释放,从而在子进程中引发永久死锁。
应对策略:在程序启动的第一行显式设置启动模式,例如:multiprocessing.set_start_method('spawn', force=True)。
五、全维度选型对照与前沿演进(Python 3.12+ 与自由线程)
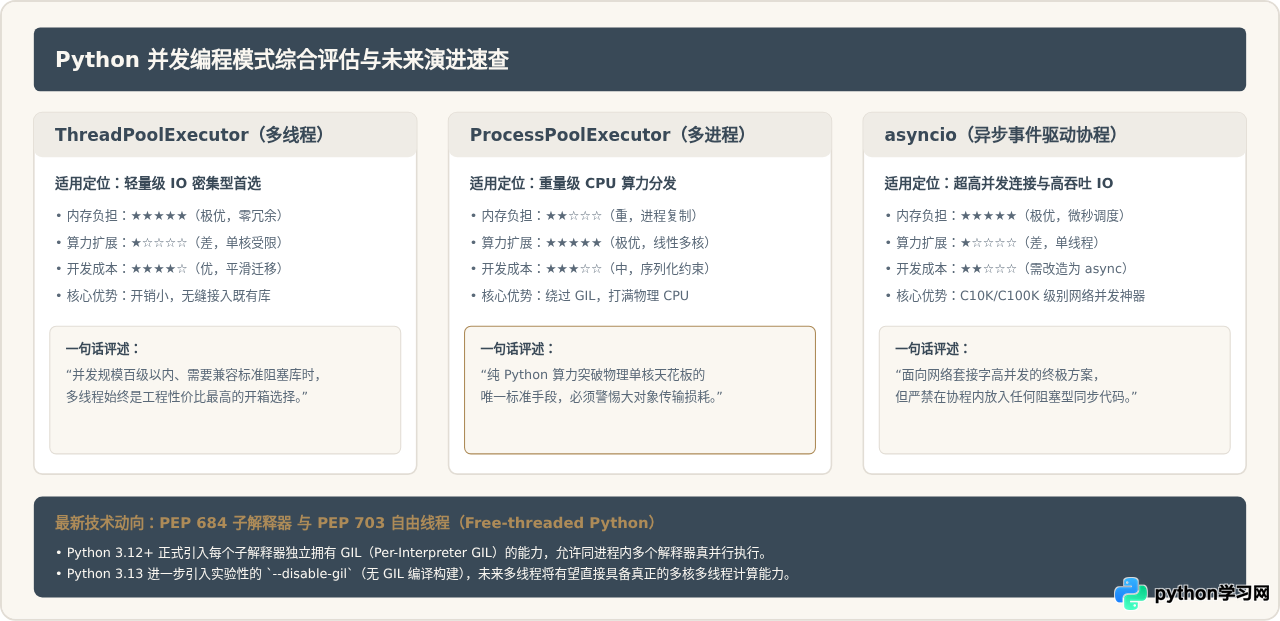
为了在架构评审或项目初期快速确定最佳方案,下表将多线程、多进程以及异步协程的核心特性进行了全方位横向对比:
| 对比维度 | 多线程(threading / ThreadPool) | 多进程(multiprocessing / ProcessPool) | 异步协程(asyncio) |
|---|---|---|---|
| 适用场景 | 网络请求、数据库查询、磁盘读写(IO 密集型) | 纯 Python 循环计算、音视频处理(CPU 密集型) | 海量并发连接、高吞吐 API 服务、网络爬虫 |
| GIL 约束 | 受制于单个 GIL(同一时刻仅 1 个线程执行) | 每个进程拥有独立 GIL,真正实现多核并行 | 单线程运行,完全不受锁竞争影响 |
| 内存开销 | 极小(共享进程内存,默认仅数 KB 栈) | 较大(复制运行环境,内存随核数成倍增长) | 极小(单协程开销仅几百字节) |
| 数据通信成本 | 零成本(直接读写全局共享变量,需加锁) | 较高(需经 IPC 管道及 Pickle 序列化) | 零成本(同一事件循环直接传递引用) |
| 代码改造难度 | 低(几乎无缝复用现有同步函数) | 中(需处理 __main__ 保护与序列化限制) |
高(传染性 async/await,第三方库需异步版) |
| 调试排错复杂度 | 高(竞态条件、死锁难以稳定复现) | 中(隔离性好,子进程崩溃不波及主进程) | 中(需要习惯追踪事件循环调用栈) |
总结与决策口诀
在当下的 Python 工程实践中,牢记以下三句话即可快速锁定最优解:
- 等待外界多,用多线程:遇到接口调用、网页爬取、文件下载等 IO 密集型场景,直接使用
ThreadPoolExecutor,代码简单且总耗时成倍降低。 - 自身算力满,用多进程:遇到大数据计算、密码哈希、循环密集运算等 CPU 密集型场景,必须选用
ProcessPoolExecutor,将负载均匀分给多个核心。 - 连接破万时,上异步协程:遇到超高并发长连接(如 WebSocket 网关、百万长轮询),拥抱
asyncio驱动的异步生态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















