


为什么开发中常把MySQL称为数据库?它在架构中的实际角色
深入解析日常开发中把MySQL统称为数据库的原因,清晰界定数据、模式、实例与管理系统的概念边界,并全面剖析MySQL在现代分层架构中的核心角色与协同关系。
一、术语混淆的根源:从日常简称到严谨层级划分
在软件工程实践中,语言交流往往倾向于追求效率与低沟通成本。“数据库”三个字在业务对话中指代明确且顺口,久而久之便成了各类具体存储系统的统称代号。但如果从软件工程与计算机科学的严格分工来看,“数据库(Database)”与“MySQL”处于完全不同的抽象层级。
具体而言,系统架构中的数据体系可以自底向上拆解为四个清晰的层次:
- 物理数据(Data Files):磁盘上以二进制格式保存的原始文件,例如 InnoDB 的表空间文件(
.ibd)、重做日志(ib_logfile)以及二进制日志(binlog)。没有运行时的管理程序,这些文件只是一堆无法被直接结构化检索的静态字节块。 - 逻辑数据库(Database / Schema):在 SQL 语法层通过
CREATE DATABASE创建的逻辑命名空间。它本质上是表、视图、存储过程等对象的逻辑归类容器,用于隔离不同业务模块的数据表定义。 - 数据库管理系统(DBMS / RDBMS):负责分配内存缓冲、解析网络请求、优化 SQL 语句、调度并发读写、执行事务恢复的庞大软件系统。MySQL 本身正是这一层级的具体实现。
- 服务端运行实例(MySQL Instance / mysqld):操作系统中实际运行的后台进程及其占用的内存结构(如 Buffer Pool)。客户端通过 TCP/IP 或 Unix Socket 建立连接的对象,实际上是这个正在运行的实例,而非静态的文件或逻辑概念。
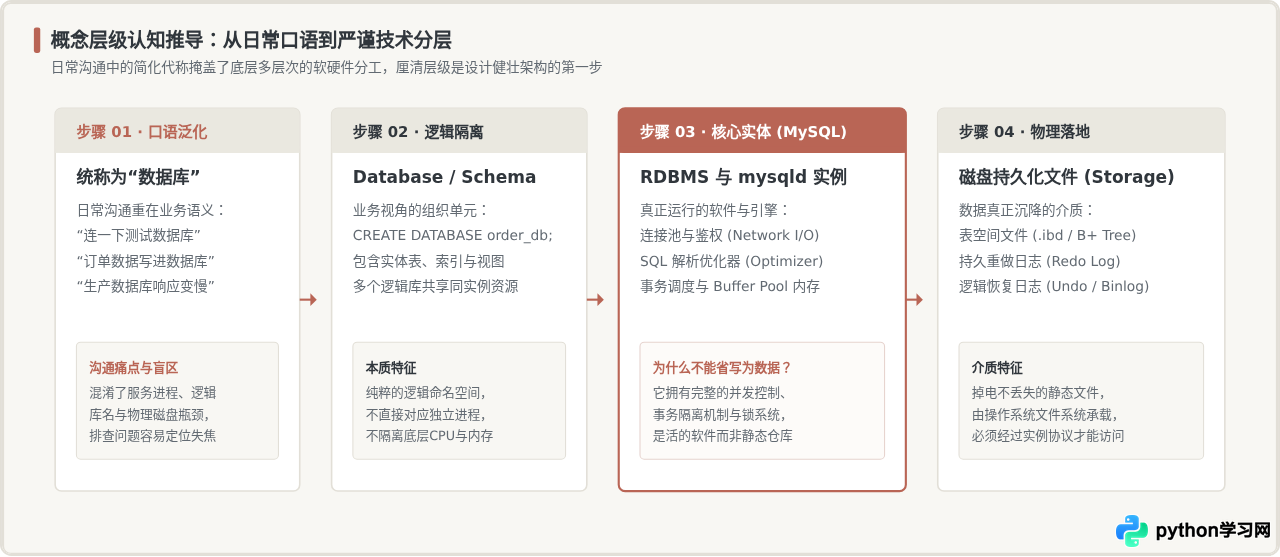
之所以开发者容易将 MySQL 整体等同于“数据库”,主要有两方面原因:其一是在应用初始化阶段,开发者通常是在同一个安装包或云主机里配置 MySQL 并直接执行建库建表语句,管理服务与数据载体高度绑定;其二是 SQL 标准中的关键字直接使用了 DATABASE(例如 SHOW DATABASES),使用户自然把掌控这些命令的宿主服务统称为数据库。
二、MySQL 在现代应用架构中的实际角色定位
在当今典型的微服务与高并发后端架构中,单靠一个 MySQL 无法支撑起全部的数据访问需求。系统往往需要结合 Redis 缓存、Elasticsearch 搜索引擎、Kafka 消息队列以及对象存储(OSS)。在这一多元化的组件网络中,MySQL 究竟处于什么位置?
答案是:核心业务状态的“唯一真实数据源”(Single Source of Truth, SSOT)与强一致性事务底座。
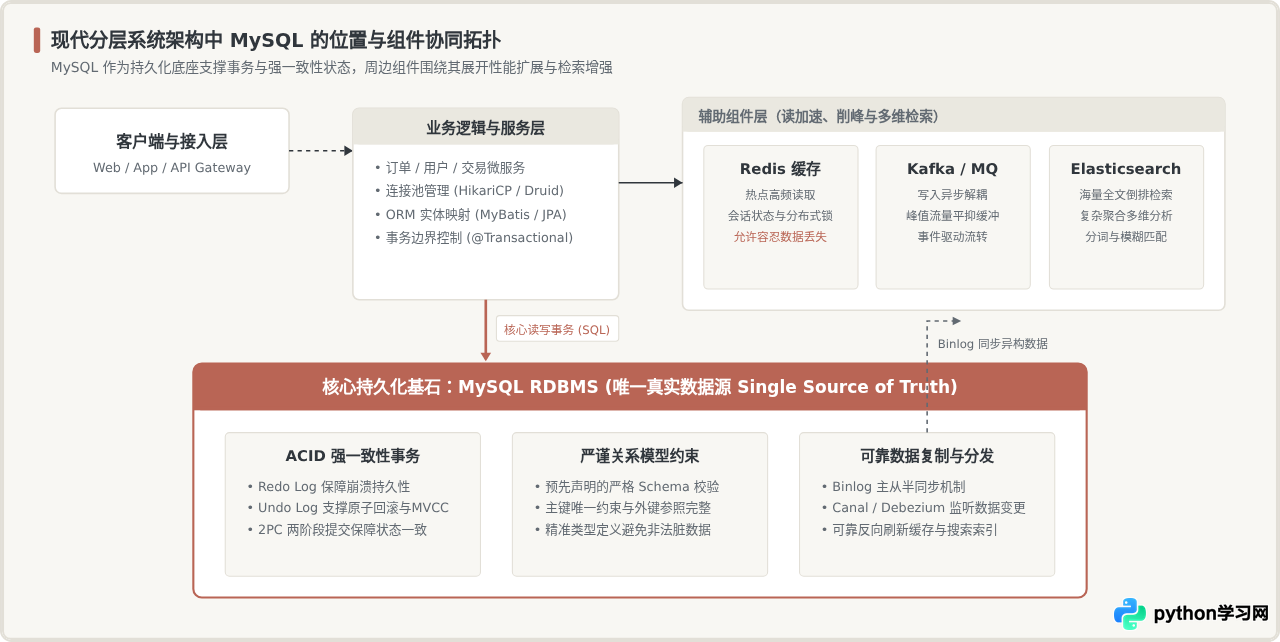
在上述架构拓扑中,其他组件虽然性能出众,但都存在不可妥协的局限性:
- Redis 速度极快,但其基于内存的设计在断电或重启时存在丢失数据的风险,其数据结构也无法天然表达复杂的实体关联逻辑。它适合作为“加速副本”,不能作为“唯一主本”。
- Elasticsearch 具备极致的模糊搜索与多维分析能力,但它的写入是准实时的(默认存在 1 秒的 Refresh 延迟),且不支持跨文档的严格 ACID 事务,无法处理转账、扣减库存等严谨交易。
- Kafka 吞吐量巨大,但它是顺序 append-only 的流式通道,无法提供基于主键或任意条件的即时随机点查与修改。
正因如此,架构中的所有派生数据(缓存、搜索索引、分析宽表)本质上都是从 MySQL 中经过业务写入或 Binlog 监听同步出来的。只要 MySQL 中的数据保持完好,整个系统的外部辅助设施哪怕全量崩溃,都可以通过重放或全量拉取重新构建。这也是为什么开发团队在讨论架构稳定性时,通常把“保护好 MySQL”放在第一优先级。
三、MySQL 的内部运行机制:从一条 SQL 看它的系统职责
如果 MySQL 仅仅是一个保存数据的容器,那它的体积不应该如此庞大。之所以称其为复杂的“管理系统”,是因为它在幕后承担着大量的计算、调度与恢复职责。
当业务代码通过 JDBC 或连接池发送一条类似 UPDATE account SET balance = balance - 100 WHERE user_id = 1001; 的语句时,MySQL 内部会经历清晰的分层处理流转:
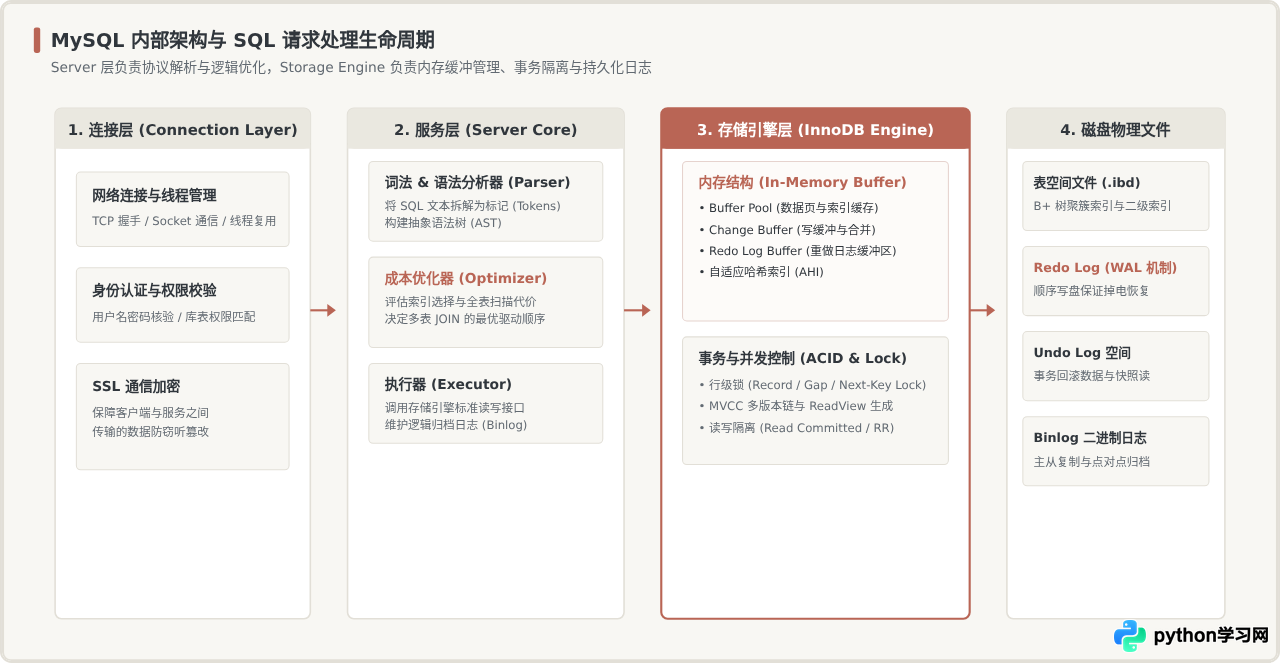
从图 3 的完整处理链条可以看出,一个简单的更新动作绝不仅仅是向磁盘写文件:
- 解析与权限检查:Server 层必须先确认当前连接是否有权修改该表,并将 SQL 解析为机器可执行的操作节点。
- 内存变更与 WAL 预写:InnoDB 不会每次都同步去修改磁盘上的
.ibd文件(随机写磁盘非常慢),而是直接在内存中的 Buffer Pool 完成修改,并将修改操作以顺序追加的方式写入Redo Log Buffer。 - 两阶段提交(2PC):为了确保 Binlog(用于集群复制)与 Redo Log(用于单机恢复)的一致性,MySQL 内部执行 Prepare、写 Binlog、Commit 的严格协议,确保在任意时刻遭遇宕机断电,数据都不会出现主从不一致或逻辑撕裂。
正是这套精密、经受过几十年工业检验的体系,让 MySQL 获得了“只要事务提交成功,数据就绝对安全”的行业信任。
四、开发实践中的认知纠偏与架构设计守则
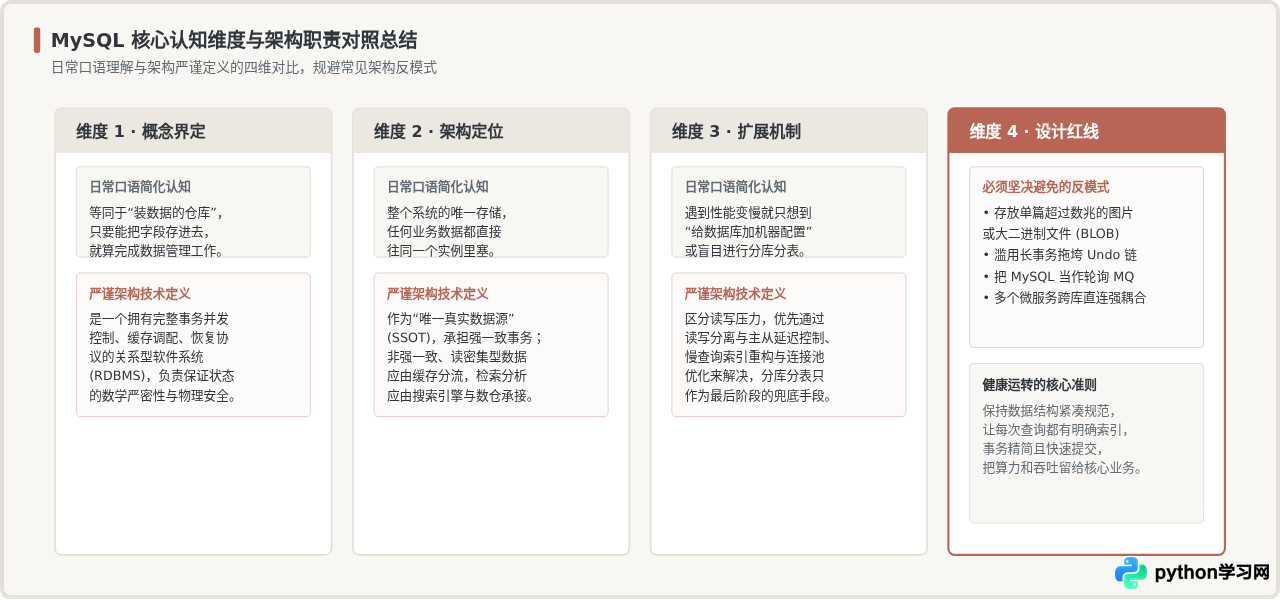
把 MySQL 称作数据库是语言习惯,但如果把“思维”也局限在“它只是存取数据的仓库”,就极容易在架构设计中产生反模式。以下是在实际系统演进中应当遵循的关键边界与设计守则:
1. 警惕把 MySQL 当作消息队列或定时调度轮询器
很多早期系统为了省事,会在表中加一个 status = 0 的标记,然后由后台多个任务不断执行 SELECT * FROM task WHERE status = 0 LIMIT 10 FOR UPDATE;。这种做法不仅会引发严重的行锁竞争与间隙锁膨胀,还会导致 InnoDB 的 Buffer Pool 被大量轮询数据冲刷,严重挤占核心业务读写的热点缓存。对于任务调度与状态通知,应当直接使用专业的 MQ 或延迟队列。
2. 明确“逻辑库隔离”并不等于“硬件资源隔离”
在微服务拆分初期,一些团队为了省成本,会在同一台 4 核 16G 的 MySQL 实例上创建 order_service、user_service、report_service 多个数据库。虽然在代码层面它们是独立的逻辑库,但在物理层面,它们共享同一个 mysqld 进程、同一个 Buffer Pool、同一份 CPU 算力与同一个磁盘 I/O 通道。一旦某个报表服务执行了一个未命中索引的慢查询导致 CPU 打满,其他核心服务的正常交易同样会发生雪崩。
五、结语
在日常开发沟通中,将 MySQL 随口称为“数据库”并不会造成障碍,这是一种基于上下文共识的效率习惯。但作为架构师与专业后端开发者,必须在认知深处保持清醒:MySQL 绝非静态的数据集合,而是一台精密运转、调度资源、维护 ACID 一致性的关系型管理巨兽。它在现代分布式架构中坚守着“最核心真实数据源”的战略底线,只有尊重其内部运行机制、合理卸载非核心压力,才能让整套系统在兼顾性能与安全的前提下长久稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















