


Python为什么没有专门的多行注释符号
深入解析Python为什么没有类似C语言/*...*/的专用多行注释符号,阐述缩进语法冲突、Zen of Python哲学以及现代编辑器与Docstring的实际应用。
#,而没有类似 /* ... */ 的专门多行注释符号?核心原因在于 Python 独特的“强制缩进”语法机制与块级注释存在天然冲突,加之“用唯一明显方式做事”的设计哲学,使 Python 在语言层面上特意放弃了独立的成对块注释标记。
一、强制缩进语法与块级注释的结构性冲突
Python 是极少数将空白字符和缩进层级作为核心语法的编程语言之一(即基于 Off-side rule 原则)。在 Python 的词法分析阶段,解释器通过扫描行首的空格生成 INDENT(增加缩进)和 DEDENT(减少缩进)记号,从而界定代码块的归属范围。
如果引入类似 C 语言的成对多行注释符号 /* 与 */,会立即在语法解析器层面引发严重的歧义。例如,当一个块注释的起始符号位于深层缩进内部,而结束符号位于外层缩进或者同一行的非首部位置时,中间被注释行的缩进应该如何计算?注释关闭后的下一行代码又应归属于哪个缩进层级?
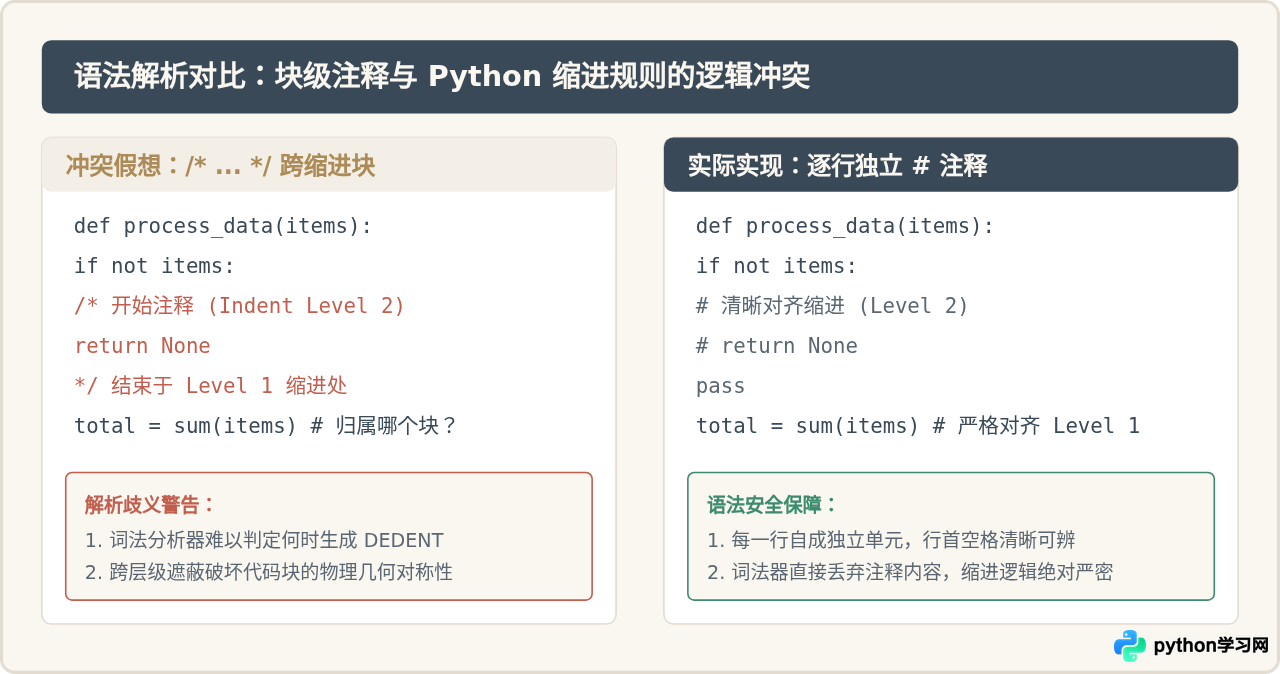
在类 C 语言中,语句边界由分号 ; 决定,代码块由花括号 { ... } 显式包围,空白符通常被解析器直接忽略。因此 /* ... */ 无论跨越多少行、放置在何处,都不会改变代码的语法结构。但在 Python 中,换行符与行首空白字符直接参与抽象语法树(AST)的构建。使用逐行 # 能确保解释器在每一行都能准确获知当前的缩进深度,彻底消除了词法分析器对注释起止范围与缩进回溯的模糊判定。
二、Python 设计哲学:一件事只有一种显而易见的方式
Python 创始人 Guido van Rossum 在设计这门语言时,确立了著名的《Python 之禅》(The Zen of Python)。其中关键的一条原则是:
(完成一件事应当只有一种——而且最好只有一种——显而易见的方式。)
在很多包含两套注释语法的语言中,开发者往往需要制定编码规范来界定“什么时候用单行注释,什么时候用多行注释”。而 Python 从语言规范层面直接砍掉了冗余机制:凡是注释,统一以 # 开头。
这种“单一方式”带来了三个直接优势:
- 视觉确定性:阅读代码时,读者仅需扫视每一行的行首,就能100%确定该行是否会被执行,而不会因为遗漏位于数百行之外的未闭合
*/导致对代码执行逻辑产生严重误判。 - 语法极简:编译器/解释器无需维护复杂的多行注释嵌套规则(例如 C++ 中
/* /* */ */容易引发语法嵌套报错)。 - 版本控制清晰:当注释内容发生局部修改时,版本控制系统(如 Git)记录的 diff 仅涉及具体发生变化的单行,行边界与语法边界天然重合。
三、三引号字符串(Docstring)为什么不能等同于多行注释
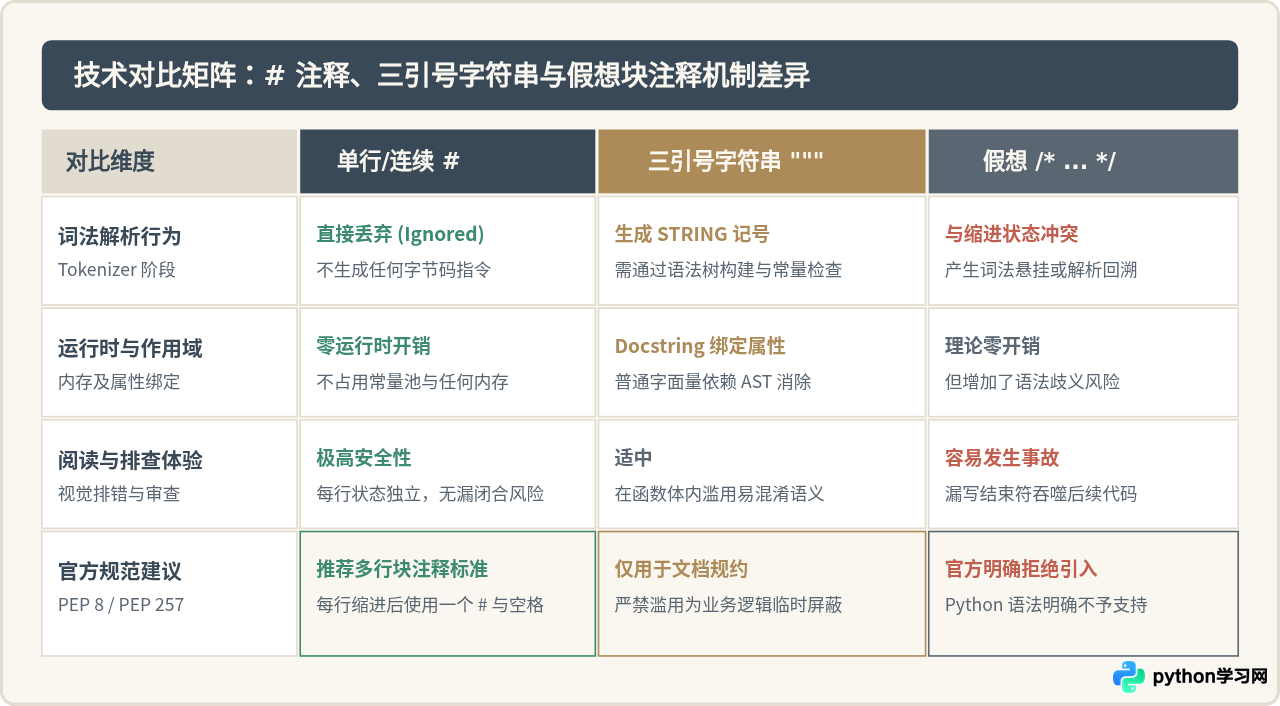
不少刚接触 Python 的开发者会习惯使用未赋值的三引号字符串(''' 或 """)来包裹多行文本,将其充当临时“多行注释”。这种做法在语法上虽然合法,但其底层运行逻辑与注释有着本质区别。
def calculate_interest(principal, rate, years):
    """
    这是标准文档字符串(Docstring)。
    它在运行时被编译器挂载到函数的 __doc__ 属性上,
    可以通过 help() 或 calculate_interest.__doc__ 访问。
    """

    '''
    这是普通的未赋值字符串字面量。
    它不是语法层面的注释!
    解释器仍需将其词法解析为字符串对象并检查语法。
    '''
    return principal * (1 + rate * years)
在编译阶段,真正的注释 # 在词法扫描(Tokenizing)阶段就直接被分词器丢弃,完全不会进入语法树;而多行字符串字面量会被完整解析为 str 常量。如果该三引号字符串不是位于模块、类或函数的首部(即非 Docstring 场景),虽然 Python 的字节码优化器(AST Optimizer)在发现该表达式无副作用后可能会在最终生成的代码对象中优化掉无用常量,但它仍然需要承受前期的编译开销,并且在某些内嵌场景下会占用内存中的常量表常量池。
四、工程实操:现代编辑器一键批量多行注释
反对缺少多行注释符号的最常见声音是:“如果需要临时屏蔽二三十行调试代码,难道要手动逐行输入 # 吗?”
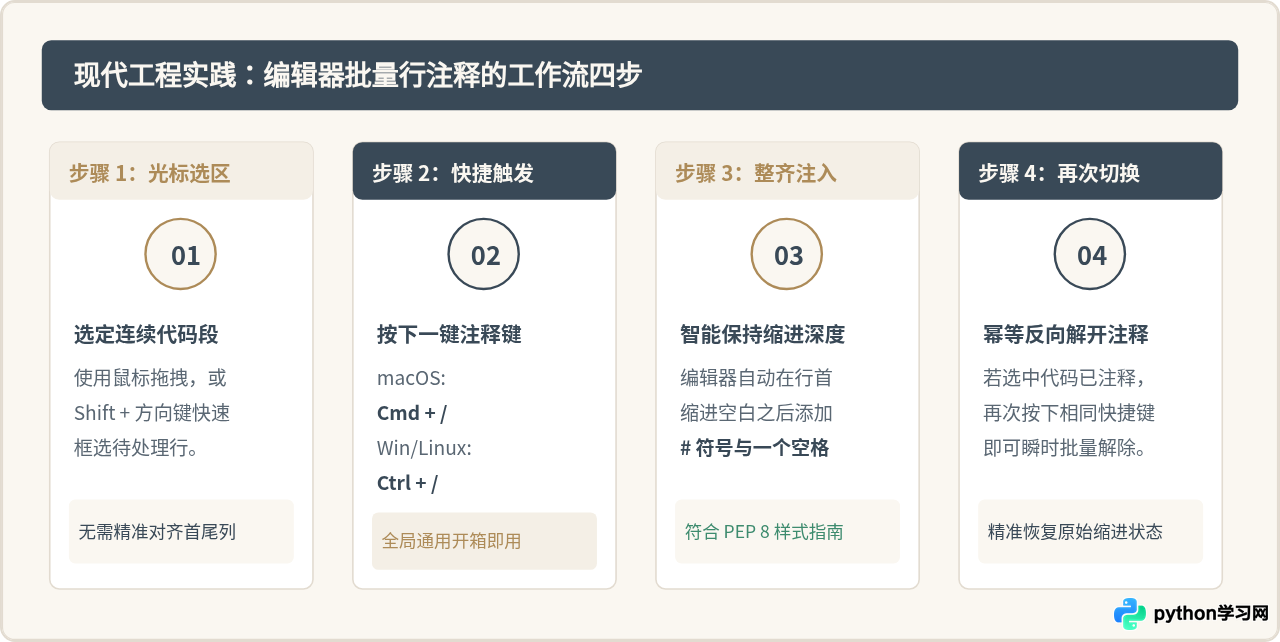
在实际软件工程中,这一操作完全由集成开发环境(IDE)与代码编辑器代劳。现代主流编辑器(如 VS Code、PyCharm、Cursor、Vim、Sublime Text 等)均将“批量行注释”作为核心内置功能。通过简单的快捷键,即可在微秒级完成数十行代码的注释与还原。
各主流编辑器的标准操作方式
- VS Code / Cursor:选中代码后按下
Cmd + /(macOS) 或Ctrl + /(Windows/Linux)。若要使用成对注释块模式,它也通过内置语言策略自动转为逐行#。 - PyCharm / IntelliJ IDEA:使用
Cmd + /或Ctrl + /执行单行/多行批量注释,操作完全相同。 - Vim / Neovim:配合常用插件(如
tpope/vim-commentary),只需使用gc动作或在可视行模式(Visual Line)下按快捷指令。
借助工具链的这一通用能力,“多行注释输入繁琐”的痛点在工程实践中早已被完全消除。
五、规范与总结:何时用 #,何时用 Docstring
PEP 8(Python 官方代码风格指南)对注释与文档做出了非常明确的职责划分:
- 解释代码逻辑、屏蔽临时代码:必须使用一个或多个以
#开头的行。每一行注释应与对应代码维持相同的缩进层级。 - 解释接口契约、编写模块与类说明:必须使用三引号字符串(Docstrings),遵循 PEP 257 规范。
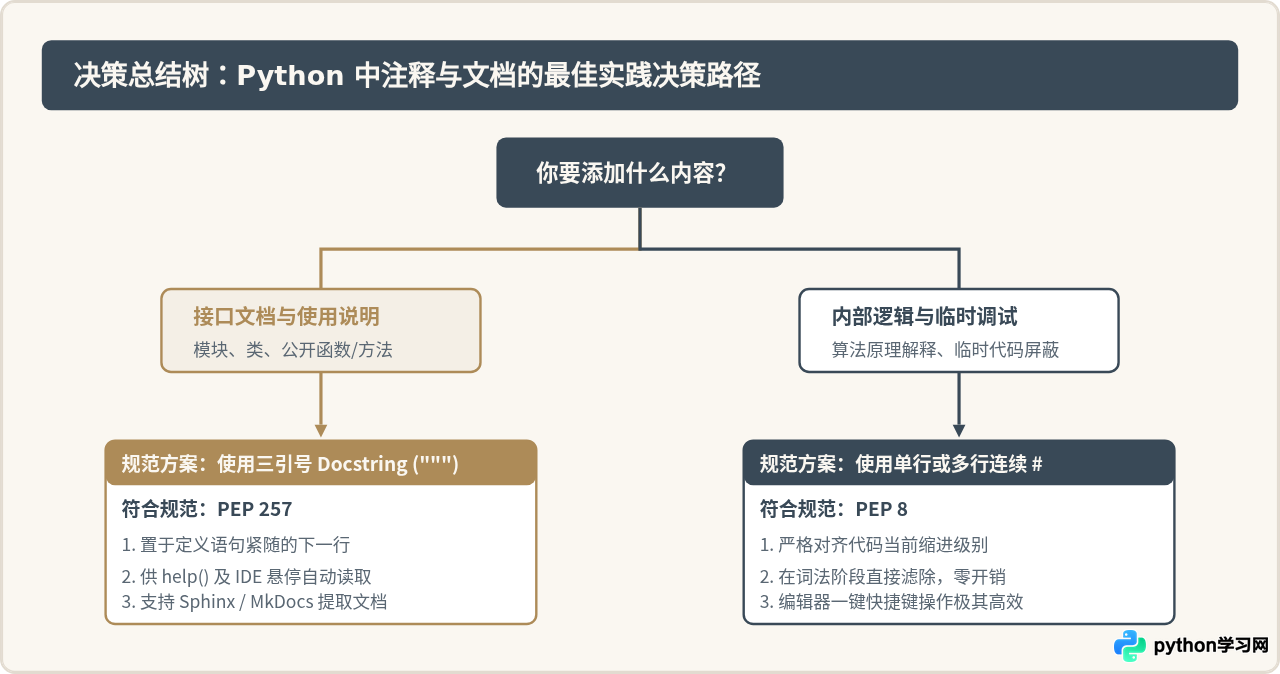
Python 没有专门的多行注释符号,不是一种遗漏,而是一项经过深思熟虑的刻意设计:它在底层规避了缩进语法树在语法分析时的歧义风险,在顶层贯彻了简洁明了的语言哲学,而在日常工程中又完美融入了现代编辑器的快捷操作体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















