


Python主要应用领域有哪些:Web开发、数据分析与人工智能
深入解析Python的三大核心应用领域:Web开发、数据分析与人工智能。涵盖各个领域的技术栈分工、落地流程、代码示例、架构图示及学习选型建议。
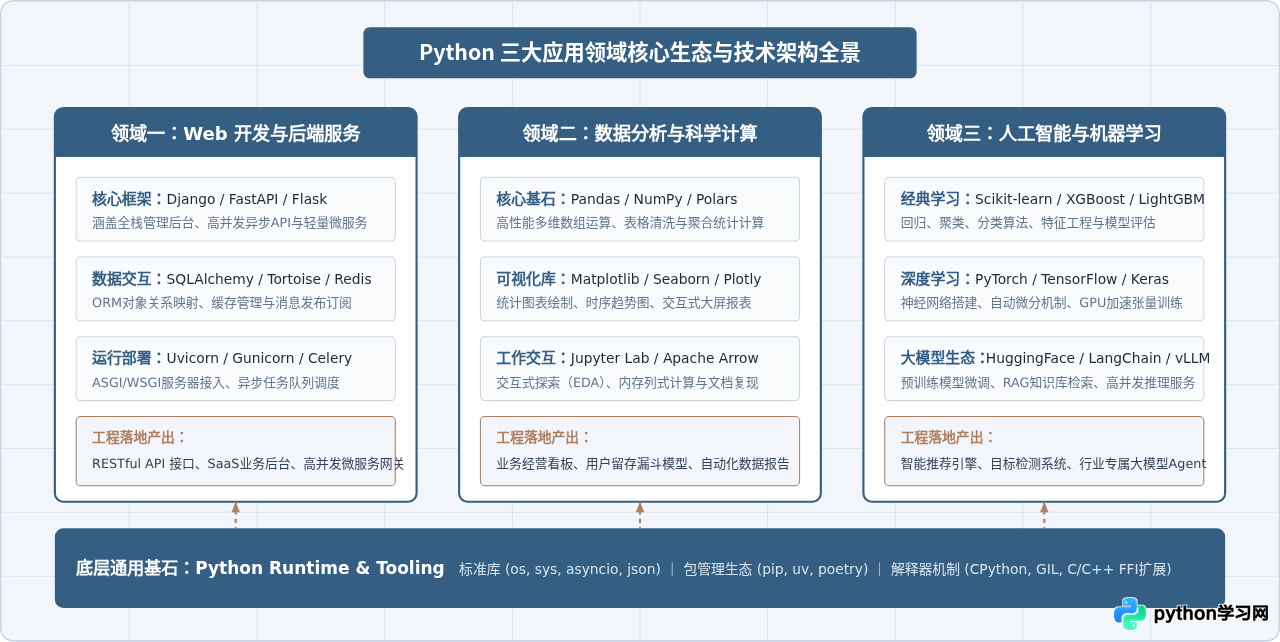
一、三大核心领域的产业定位与生态全景
Python 凭借语法简明、标准库完善以及极为庞大的第三方开源社区,在不同业务形态下承担着明确的工程角色。这三大方向各有侧重,既相互独立,又在实际数字化系统中紧密联动:
- Web 开发:主要聚焦于后端服务架构、RESTful/GraphQL API 开发、微服务系统以及后台数据管理平台。核心诉求在于业务逻辑的高效交付、路由分发与数据持久化。
- 数据分析:覆盖从多源数据清洗、结构化处理、探索性统计分析(EDA)到可视化交互报表的完整链条。核心诉求在于释放业务数据价值,辅助经营决策与指标追踪。
- 人工智能:涵盖经典机器学习建模、深度学习网络训练、计算机视觉(CV)、自然语言处理(NLP)及当前的大语言模型(LLM)工程化编排。核心诉求在于利用数学算法发掘高阶规律并完成自动化推理预测。
二、Web 开发:高效率构建后端服务与业务 API
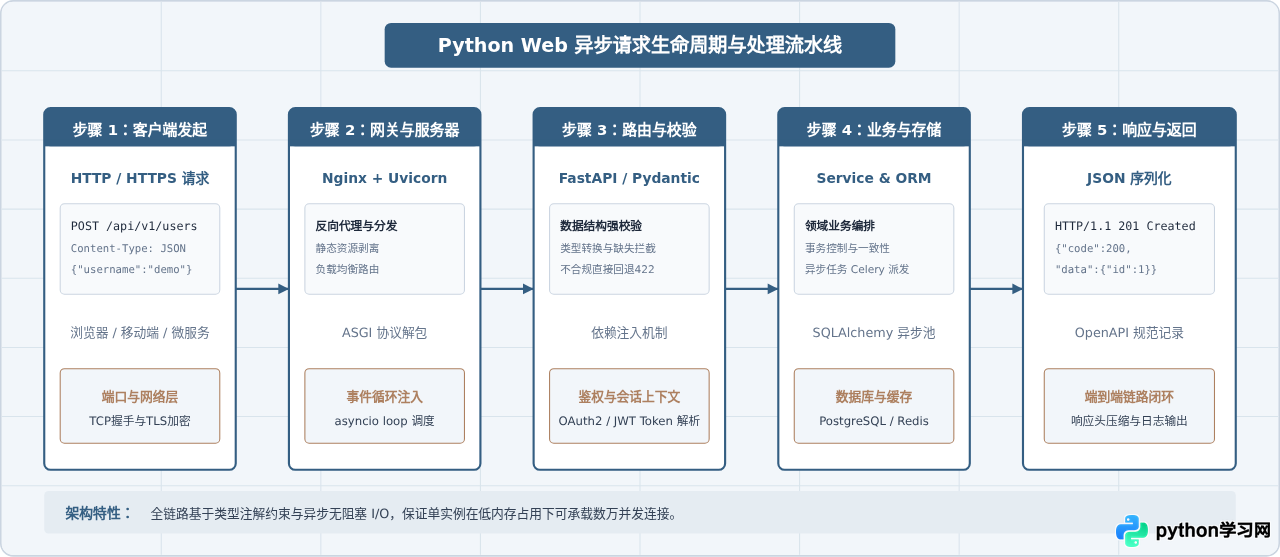
在 Web 工程体系中,Python 常用于后端逻辑承载、RESTful 接口开发与服务聚合。其显著优势在于极高的开发人效:借由成熟的生态支持,开发者可以用少量代码快速完成模型定义、权限验证和业务流转。
1. 主流 Web 框架选型对比
- FastAPI:基于 Python 3.6+ 类型提示(Type Hints)与 Starlette / Pydantic 构建的现代异步框架。原生支持
asyncio异步编程,自动生成 OpenAPI 标准交互式接口文档(Swagger UI),序列化与反序列化性能强,是当前构建微服务与 AI 接口的主流首选。 - Django:贯彻“内置电池(Batteries-Included)”理念的全功能框架。自带强劲的 ORM 体系、管理后台(Admin)、用户鉴权系统以及防 CSRF/XSS 安全组件。适合企业级中后台系统、内容管理平台(CMS)以及业务逻辑复杂的单体应用。
- Flask:轻量级微框架(Micro-framework),核心仅包含路由分发与模板渲染。扩展极其自由,非常适合代码行数较少的小工具、快速原型验证或高度定制化的项目架构。
2. 完整后端接口实现示例(FastAPI 路由与参数校验)
以下为一个可直接执行的 FastAPI 后端服务代码,展示请求数据通过 Pydantic 自动完成校验、入库模拟与标准化响应的全过程:
# main.py
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional
import uvicorn

app = FastAPI(title="用户资源管理接口", version="1.0.0")

# 1. 定义请求入参数据模型(自带类型约束与字段验证)
class UserCreateSchema(BaseModel):
    username: str = Field(..., min_length=3, max_length=20, description="用户唯一账号名")
    email: str = Field(..., regex=r"^[\w\.-]+@[\w\.-]+\.\w+$", description="合规电子邮箱")
    age: Optional[int] = Field(None, ge=18, le=120, description="年龄必须在18至120周岁之间")

# 2. 模拟持久化存储结构
user_database = {}

# 3. 声明路由与业务处理逻辑
@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user(user: UserCreateSchema):
    if user.username in user_database:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail=f"用户名为 '{user.username}' 的账号已存在"
        )
    user_record = user.dict()
    user_record["id"] = len(user_database) + 1
    user_database[user.username] = user_record

    return {"code": 200, "message": "用户创建成功", "data": user_record}

if __name__ == "__main__":
    # 使用 Uvicorn ASGI 高性能服务器运行
    uvicorn.run("main:app", host="127.0.0.1", port=8000, reload=True)
执行该脚本后,服务将在本地 8000 端口监听。访问 http://127.0.0.1:8000/docs 即可获得全自动生成的交互式 API 测试控制台。
async def 接口函数中直接调用阻塞型 I/O 操作(例如未封装的 time.sleep() 或同步数据库驱动 pymysql)。阻塞调用会直接挂起事件循环单线程,导致其他并发请求无法及时响应。数据库读写应使用支持异步协议的驱动(如 asyncmy、asyncpg)。
三、数据分析:从混乱数据源到业务量化洞察
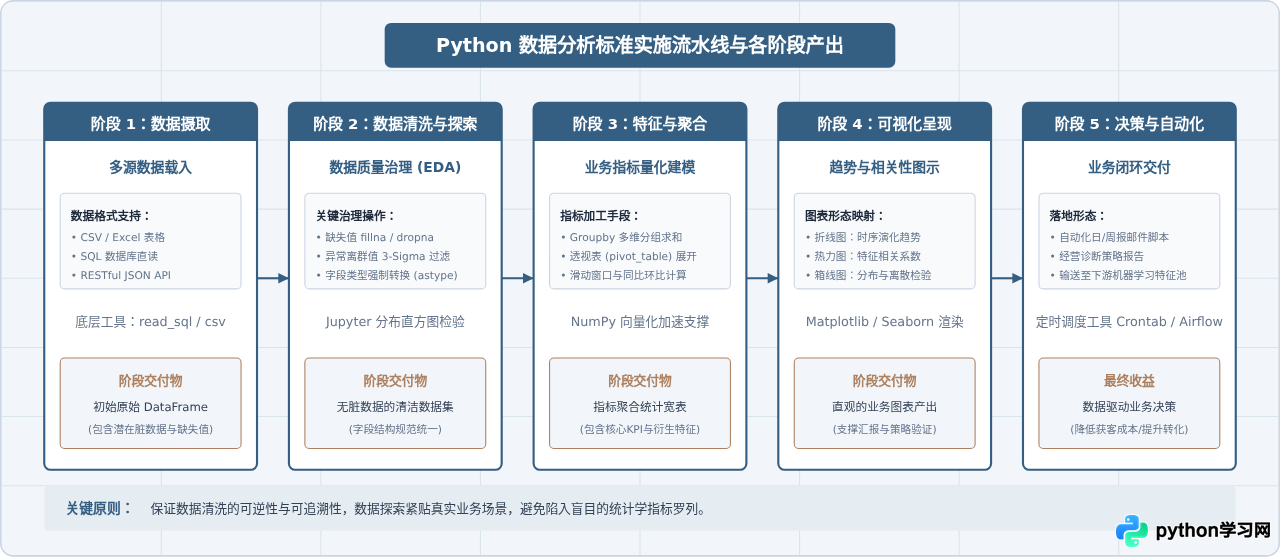
数据分析是 Python 确立行业统治地位的核心阵地。由于底层核心计算依赖 C/Fortran 原生编译代码,Python 在提供胶水语言友好语法的同质,具备了匹敌底层原生语言的数组计算与矩阵操作速度。
1. 数据分析核心工具栈分工
- NumPy:提供高维数组对象
ndarray以及向量化运算底层支持,避免原生 Python 循环带来的性能损耗。 - Pandas:提供以
DataFrame为核心的表格数据操作接口,内置丰富的时间序列处理、透视表分析、缺失值修补与合并关联功能。 - Matplotlib & Seaborn:用于静态、专业级别的科学图表与统计分布绘制,支持高度定制化的坐标轴与图层控制。
- Jupyter Lab / Notebook:交互式探索计算环境,支持分块执行代码、即时查看中间图表与结果,形成可解释、可复现的数据分析报告。
2. 标准数据分析处理全流程示例
以下示例演示从原始数据构建、缺失值治理、多维度分组统计到结果导出的完整步骤:
# data_pipeline.py
import pandas as pd
import numpy as np

# 步骤 1:构造/读取原始业务数据
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "channel": ["线上直销", "电商平台", "线上直销", "线下门店", "电商平台", "线上直销"],
    "amount": [299.0, np.nan, 150.5, 890.0, 450.0, np.nan],
    "quantity": [2, 1, 1, 5, 3, 2]
}
df = pd.DataFrame(raw_data)

# 步骤 2:数据清洗(缺失值与脏数据治理)
# 检测缺失值并按渠道均值进行合理插补
channel_mean = df.groupby("channel")["amount"].transform("mean")
df["amount"] = df["amount"].fillna(channel_mean)

# 步骤 3:特征衍生与计算
df["unit_price"] = (df["amount"] / df["quantity"]).round(2)

# 步骤 4:多维度聚合统计分析
summary = df.groupby("channel").agg(
    total_revenue=("amount", "sum"),
    order_count=("order_id", "count"),
    avg_order_value=("amount", "mean")
).reset_index()

# 格式化输出分析结果
print("=== 各渠道销售表现分析表 ===")
print(summary.to_string(index=False))

# 步骤 5:导出清洗后的结构化数据
summary.to_csv("channel_sales_summary.csv", index=False, encoding="utf-8-sig")
chunksize 分块读取、指定紧凑数据类型(如将 int64 转为 int32,字符串转为 category),或迁移至基于 Rust 编写的列式分析库 Polars。
四、人工智能:机器学习与大模型工程落地的核心枢纽
Python 在人工智能(AI)领域的垄断性地位几乎无可替代。全球前沿的学术论文开源实现、主流工业级深度学习计算引擎、大模型微调推理平台均以 Python 作为第一优先级交互语言。
1. 核心技术分支与工程分层
- 经典机器学习(Scikit-learn):针对结构化表格数据的分类、聚类与回归任务,如随机森林(Random Forest)、支持向量机(SVM)、梯度提升树(XGBoost/LightGBM)。计算开销低,可解释性极强,广泛应用于金融风控与营销反作弊。
- 深度学习框架(PyTorch & TensorFlow):依托张量(Tensor)运算与动态自动微分(Autograd)机制,搭建卷积网络(CNN)、循环网络(RNN)与 Transformer 架构。PyTorch 凭借 Pythonic 的调试体验已成为学术界与工业界的主流研发首选。
- 大语言模型与 Agent 应用开发:随着生成式 AI 的爆发,Python 生态迅速演化出面向大模型的中间层框架。通过
Hugging Face Transformers加载开源模型权重,利用LangChain或LlamaIndex搭建 RAG(检索增强生成)知识库与自主调用外部工具的智能体(Agent)。
2. 经典机器学习训练与评估完整示例
以下示例展示基于 scikit-learn 实现数据集切分、标准化预处理、模型拟合与分类评估指标生成的完整链路:
# ml_training.py
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score
import joblib

# 步骤 1:加载数据并拆分训练集与测试集(保持严谨的数据隔离)
data = load_iris()
X, y = data.data, data.target

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 步骤 2:特征工程(标准化缩放)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)  # 注意:测试集严禁用 fit 避免数据穿越

# 步骤 3:模型实例化与训练
model = RandomForestClassifier(n_estimators=100, max_depth=4, random_state=42)
model.fit(X_train_scaled, y_train)

# 步骤 4:模型推理与精度评估
y_pred = model.predict(X_test_scaled)
acc = accuracy_score(y_test, y_pred)

print(f"测试集准确率: {acc:.4f}\n")
print("=== 分类性能报告 ===")
print(classification_report(y_test, y_pred, target_names=data.target_names))

# 步骤 5:模型序列化持久化(供线上生产服务调用)
joblib.dump({"scaler": scaler, "model": model}, "model_pipeline.joblib")
print("模型流水线已持久化保存至 model_pipeline.joblib")
五、三大领域技术选型、能力要求与发展路径总结
面对三个不同的技术领域,学习者与工程团队应根据具体的业务目标、既有基础和硬件投入做出清晰的路径规划,避免漫无目的地“全盘兼收”:
| 对比维度 | Web 开发 | 数据分析 | 人工智能与大模型 |
|---|---|---|---|
| 核心业务目标 | 搭建业务功能、接口响应、用户鉴权与后台管理系统 | 分析经营指标、定位业务瓶颈、自动化报表与数据驱动 | 构建自动化识别、智能预测、语义理解与内容生成系统 |
| 前置基础要求 | HTTP协议、SQL数据库、Linux基础、基本前后端交互 | 基础统计学、业务理解力、SQL查询、数据清洗思维 | 高等数学(微积分/线代/概率论)、算法基础、深度学习架构 |
| 硬件算力依赖 | 低(普通开发机与标准云主机即可满足研发要求) | 中(单机对内存需求较高,通常要求 16GB-64GB+) | 高(深度学习与大模型需要英伟达 GPU 算力集群加速) |
| 初学者上手周期 | 约 1 - 2 个月即可独立开发完整 CRUD 业务系统 | 约 2 - 3 周即可掌握基础数据清洗与常规报表绘制 | 需要 6 个月以上系统积累(大模型Prompt应用层除外) |
| 典型交付成果 | REST API 接口、SaaS 业务平台、后台管理系统 | 交互式分析看板(Dashboard)、策略优化报告 | 高精度预测模型权重、RAG 知识库、垂直 Agent 应用 |
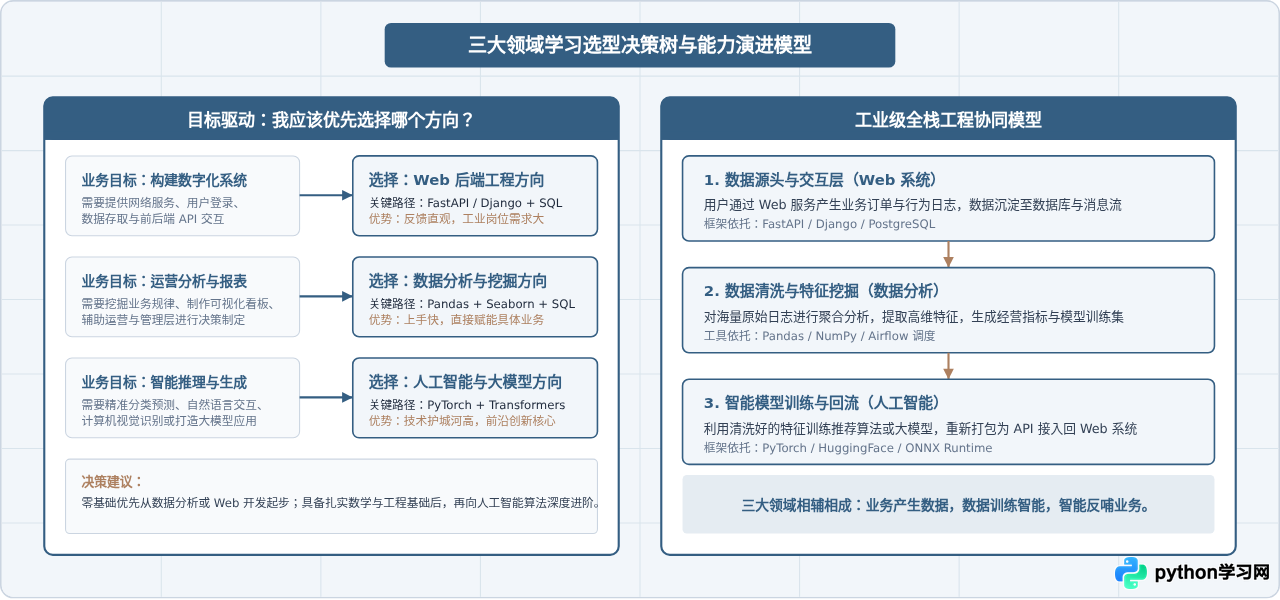
总结而言,Web 开发保障了系统的互联与服务交付能力,数据分析赋予了企业透视业务真相的量化手段,而人工智能则将自动化决策与感知生成能力推向了全新高度。清晰理解这三大应用领域的工程边界与协同机制,将帮助开发者在技术选型与能力进阶中有的放矢,最大化发挥 Python 的技术生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















