


为什么Python字符串调用方法后原值不变?理解字符串不可变性
深入解析为什么Python中字符串调用方法后原值不变,剖析字符串不可变性(Immutability)的底层机制、设计初衷、内存模型以及正确的操作规范。
strip()、upper()、replace())后,原字符串变量的值都不会改变。这是因为 Python 中的字符串类型(str)被设计为不可变对象(Immutable Object)。字符串一旦在内存中分配,其内部字符序列便无法被就地修改;所有看似“修改”字符串的方法,本质上都是计算并返回一个全新的字符串对象。若需要保留修改后的结果,必须显式地将返回值重新赋值给变量。
一、现象重现:为什么调用方法后原字符串“纹丝不动”?
很多刚从其他语言转向 Python,或者刚接触编程的开发者,在处理字符串时常会写出类似下面的代码:
# 示例代码:初学者常见的字符串处理误区
raw_text = "   python 教程   "
raw_text.strip()
raw_text.upper()

print("处理结果:", repr(raw_text))
# 实际输出依然是原值: ' python 教程 '运行这段代码后会发现,两处方法调用并没有去除两端的空格,也没有将英文字母转为大写,raw_text 的内容与初始状态完全一致。
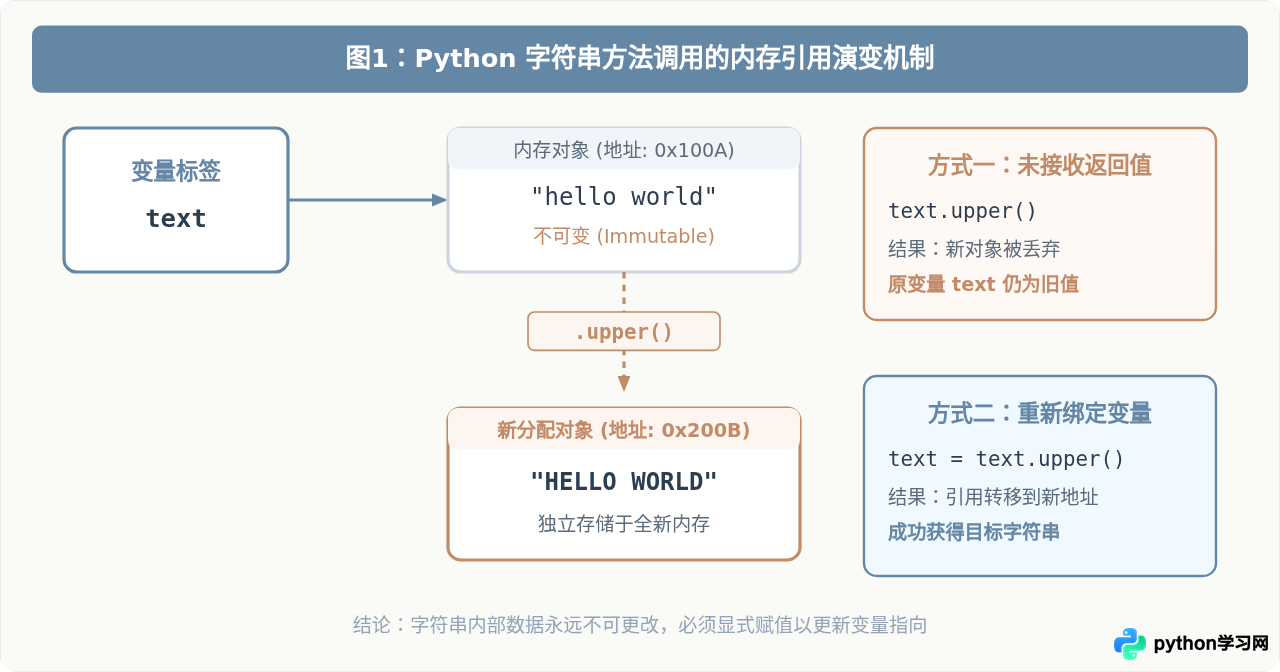
产生这一现象的原因在于:Python 中的字符串方法不具有就地(in-place)修改原对象的副作用。raw_text.strip() 确实执行了去除空格的操作,并且产生了一个干净的新字符串 'python 教程',但因为代码中没有用变量接收这个返回值,该新对象在生成后由于没有引用指向它,随即被 Python 的内存垃圾回收器销毁,原变量 raw_text 依然指向最初的字符串。
二、深入底层:变量、对象与不可变性机制
为了透彻理解这一行为,需要建立正确的 Python 内存对象模型。在 Python 中:
- 变量不是盒子,而是贴在对象上的“标签”或“指针”。
- 对象是分配在内存中的实体。 内存实体具有三要素:唯一标识(
id)、类型(type)和值(value)。
通过 id() 函数验证内存地址
我们可以使用内置函数 id() 查看对象在内存中的唯一标识符(即内存地址),观察调用方法前后的实际变化:
s = "apple"
print("原对象地址:", id(s), "内容:", s)

# 调用 replace 方法并接收结果
new_s = s.replace("a", "A")
print("新对象地址:", id(new_s), "内容:", new_s)
print("原对象地址验证:", id(s), "内容:", s)

# 输出示例:
# 原对象地址: 4358941232 内容: apple
# 新对象地址: 4358944544 内容: Apple
# 原对象地址验证: 4358941232 内容: apple从输出中可以清晰地看到:s 所指向的内存地址与 new_s 完全不同,而调用方法后原地址 4358941232 上的数据依然是 'apple'。这充分证明了原对象没有被修改,Python 在内存中重新开辟了区域来存储运算得到的新字符串。
可变类型(Mutable)与不可变类型(Immutable)的对比
很多初学者之所以感到困惑,是因为 Python 中的另一些类型支持就地修改。最典型的代表是列表(list):
# 列表支持就地修改(可变类型)
my_list = [1, 2]
my_list.append(3)
print(my_list)  # 输出 [1, 2, 3],原列表在原地被修改

# 字符串不支持就地修改(不可变类型)
my_str = "abc"
# my_str[0] = "A"  # 尝试修改字符将直接抛出 TypeError 异常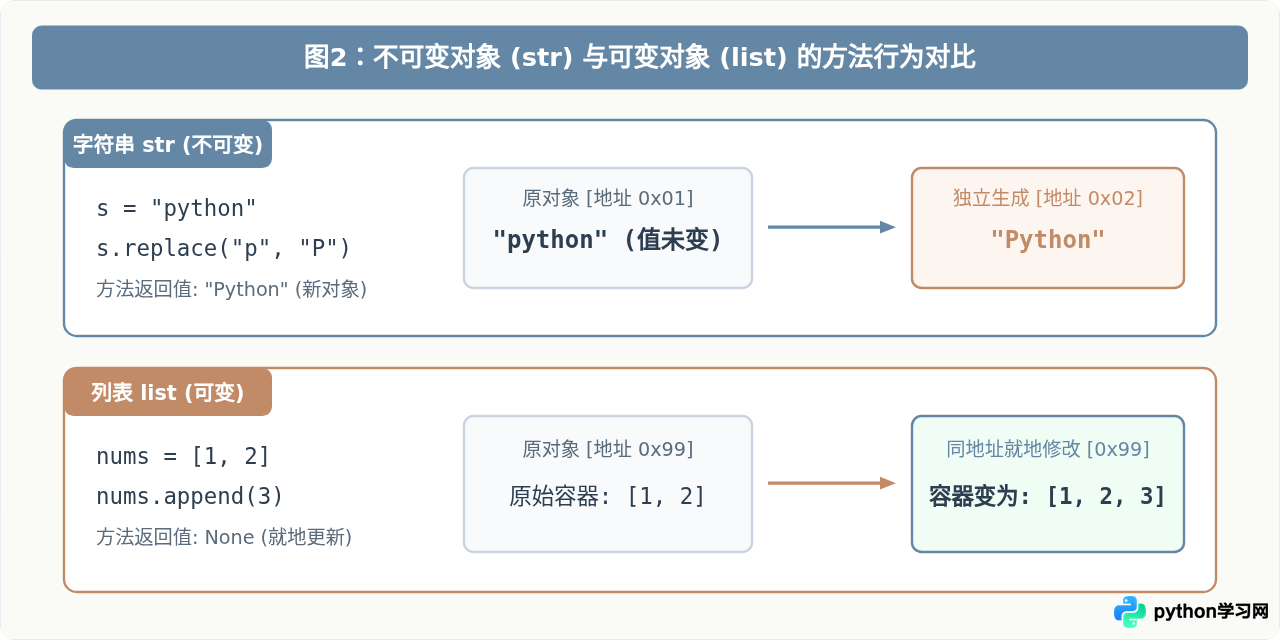
三、为什么 Python 要将字符串设计为不可变?
不可变性看起来似乎增加了一次“必须显式赋值”的步骤,但这并非 Python 的缺陷,而是经过深思熟虑的核心语言设计架构。将字符串设计为不可变对象带来了三大关键优势:
1. 保证字典键(Key)和集合(Set)的哈希安全性
在 Python 中,字典的查找速度极快(时间复杂度为 O(1)),这依赖于键对象的哈希值(Hash Value)。字典在插入键值对时,会计算键的哈希并将其存放在哈希表的固定槽位中。
如果字符串是可变的,当作为键的字符串内容发生变化时,其哈希值也会改变,导致后续查找无法定位到正确的存储槽位,字典的映射逻辑将彻底崩溃。因此,Python 规定只有不可变对象才是可哈希的(Hashable),保证了字典与集合的绝对稳定。
2. 启用字符串驻留机制(String Interning)以节省内存
由于字符串不可变,相同的字符串字面量在内存中共享同一份存储是绝对安全的。Python 解释器会对短字符串、标识符等进行驻留优化:无论程序在多少处声明了 "hello",它们在底层都可以指向同一个内存对象。这极大减少了大型程序中的重复内存开销,并且在判断字符串相等(is 比较指针)时速度极快。
3. 天生线程安全(Thread Safety)
在多线程并发环境中,多个线程读取同一个字符串对象时,无需加互斥锁,因为任何线程都不可能中途篡改字符串的内容。这消除了一大类由并发修改引发的数据竞争(Race Condition)缺陷。
四、操作步骤:正确使用 Python 字符串方法的标准流程
在实际编码中,处理字符串只需建立清晰的流水线思维。以下是推荐的标准操作三步法:
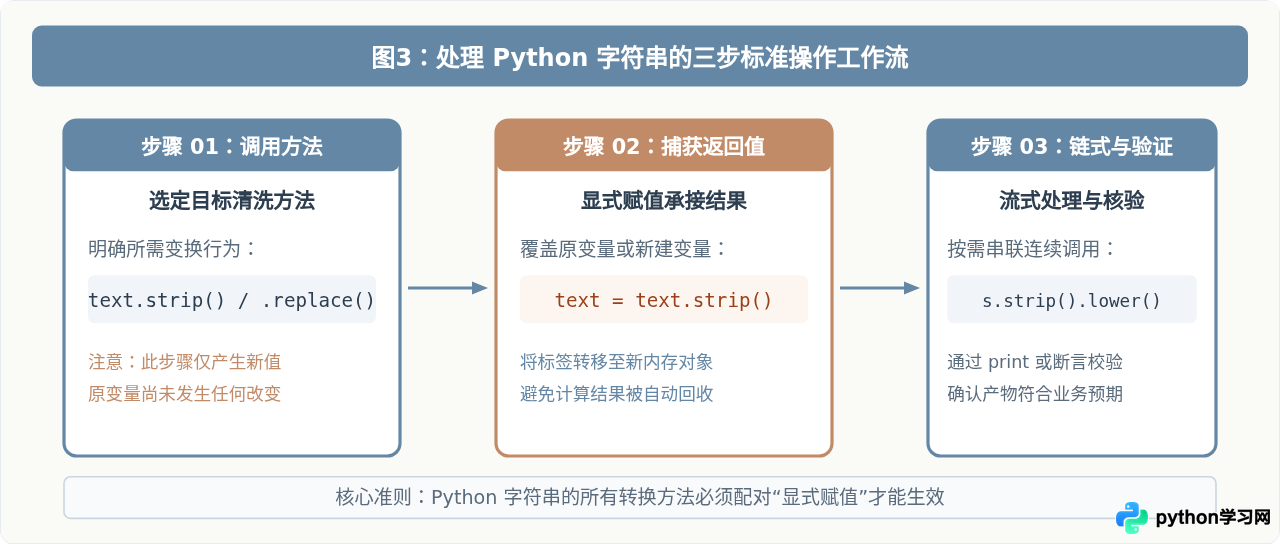
步骤 1:显式接收返回值(重新绑定或创建新变量)
如果后续逻辑不再需要原始字符串,最直接的方式是变量重新赋值(Re-binding):
raw_input = "  user@example.com  "
# 方式 A:将处理后的新对象重新绑定给原变量名
raw_input = raw_input.strip()

# 方式 B:若后续需要保留原始输入供审计排查,则赋予具有明确含义的新变量名
cleaned_email = raw_input.lower()
步骤 2:利用链式调用(Method Chaining)简化连续操作
因为每个字符串方法返回的依然是一个标准的 str 对象,所以可以顺畅地使用点号语法将多个处理步骤串联起来,既简洁又无需定义大量中间临时变量:
query = "   SELECT * FROM users; \n"
# 链式处理:去除两端空白 -> 转为小写 -> 去除末尾分号
formatted_query = query.strip().lower().rstrip(";")
print("规范化SQL:", formatted_query) # 输出: 'select * from users'+= 拼接大量字符串因为字符串不可变,每次使用
s += item 都会在内存中新建一个字符串对象并复制之前全部字符,在循环大量拼接时会导致严重的性能损耗(时间复杂度达 O(N²))。遇到批量拼接场景,务必使用列表收集后通过 "".join(str_list) 一次性高效组装。
五、全景总结与常见避坑清单
理解了不可变性,就掌握了 Python 字符串行为的核心逻辑。下表总结了日常开发中容易混淆的常见场景与正确解法:
| 场景分类 | 初学者常见错误写法 | 正确规范写法 | 背后原因与逻辑 |
|---|---|---|---|
| 清洗空格 / 大小写 | s.strip()(未赋值) |
s = s.strip() |
方法返回新对象,不就地修改原值。 |
| 子串替换 | text.replace("a", "b") |
text = text.replace("a", "b") |
替换产生新内存块,需重新捕获。 |
| 方法链误赋为 None | lst = [3,1].sort()(混淆了列表行为) |
列表就地返回 None,而字符串始终返回有效 str |
list.sort() 是可变操作;字符串所有方法均有返回值。 |
| 循环高频拼接 | result += word(在多千次循环中) |
words.append(word)"".join(words) |
不可变性导致频繁分配中间内存;join() 一次性预估内存。 |
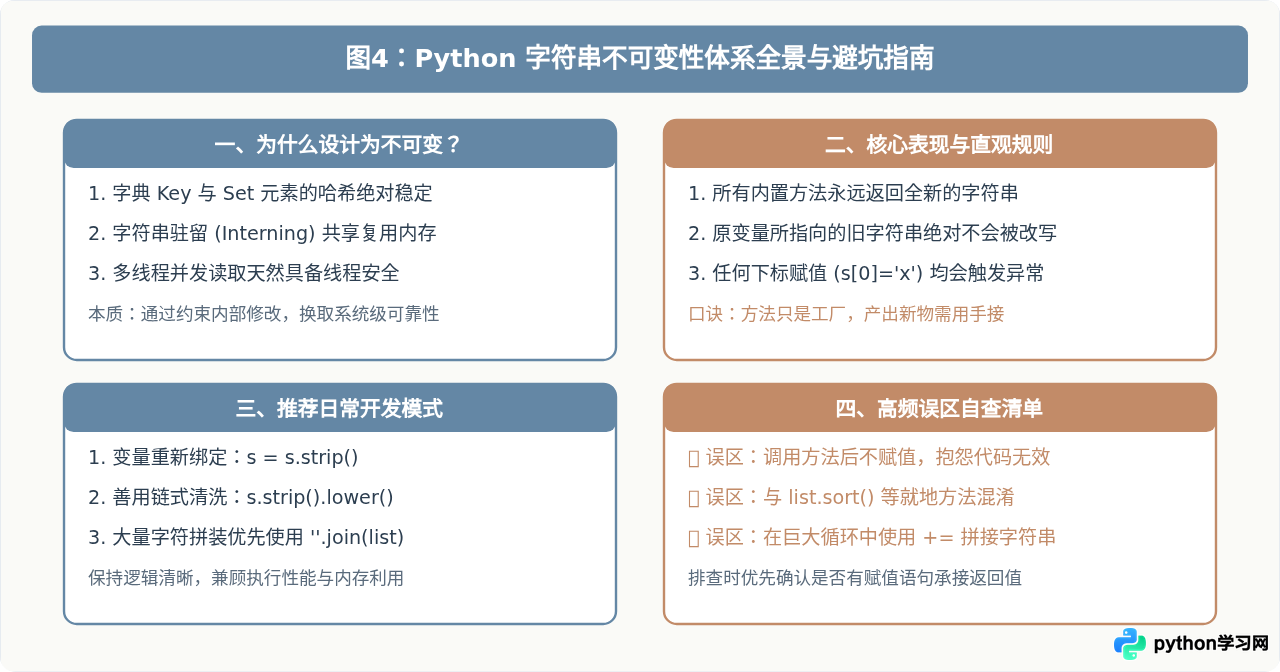
总结来说,Python 字符串调用方法后原值不变,是因为不可变性是字符串对象最基础且核心的语言契约。记住“方法永不修改原值,必须赋值接收新结果”,就能从根本上避免此类代码行为与预期不符的问题,写出更严谨、更高效的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















