


怎么区分《Python数据分析与应用》第一版与第二版习题答案
本文详细介绍如何区分《Python数据分析与应用》第一版与第二版习题答案,从关键代码语法演进、章节习题编排变动、实训数据集特征及微课配套标识等多维度提供切实可行的核对方法。
区分《Python数据分析与应用》第一版与第二版的习题答案,核心在于比对代码中是否包含已废弃的旧版 Pandas 语法(如 ix 与 as_matrix())、核对各章节操作题的具体题干和数据集名称,以及观察配套的微课版资源标识。两版教材分别编写于不同阶段,第一版基于较早期的 Python 3.5/3.6 与 Pandas 0.20 体系,第二版(通常封面标有“微课版”)则针对 Python 3.7+ 和现代 Pandas 规范进行了全面重构。掌握以下几个明确的特征,即可在数分钟内准确识别答案版本。
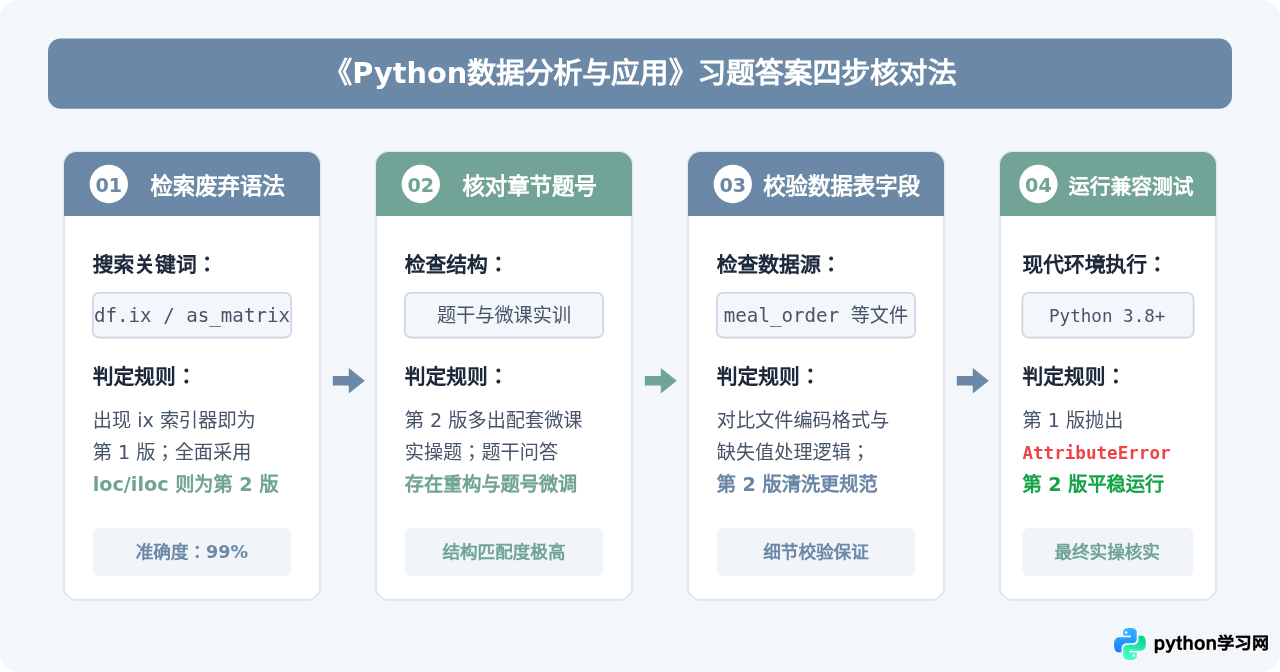
一、四步快速排查法:从特征到结论的核对路径
面对一份来源不明的题解文件或代码脚本,不需要逐字阅读全部内容。通过一套结构化的核对流程,可以快速定位关键证据,确定其所属的具体版本。
- 检索特征代码关键字:使用编辑器的全局搜索功能,检索关键词 .ix[、as_matrix、to_numpy 与 .loc[。若答案中频繁使用 df.ix,可百分之百判定为第一版答案。
- 比对章节与习题编号:翻看目录与题号安排。第一版与第二版在课后习题题型分类上有明显改动,第二版强化了上机实验与微课配套实训题,部分小题的题干和所求指标发生过增删。
- 校验实训数据表与字段名:核对典型案例数据文件(例如餐饮营业数据 meal_order_detail.csv 等)的读取方式与清洗要求。第二版对部分字段编码、统计指标的计算要求进行了规范与微调。
- 运行兼容性测试:将核心习题代码粘贴至当前通用的数据分析环境(Python 3.8+、Pandas 1.3+ 及以上版本)中执行。第一版答案会因旧 API 被移除直接抛出异常,第二版答案则能平稳运行。
二、关键代码与 API 差异:最直接的技术分水岭
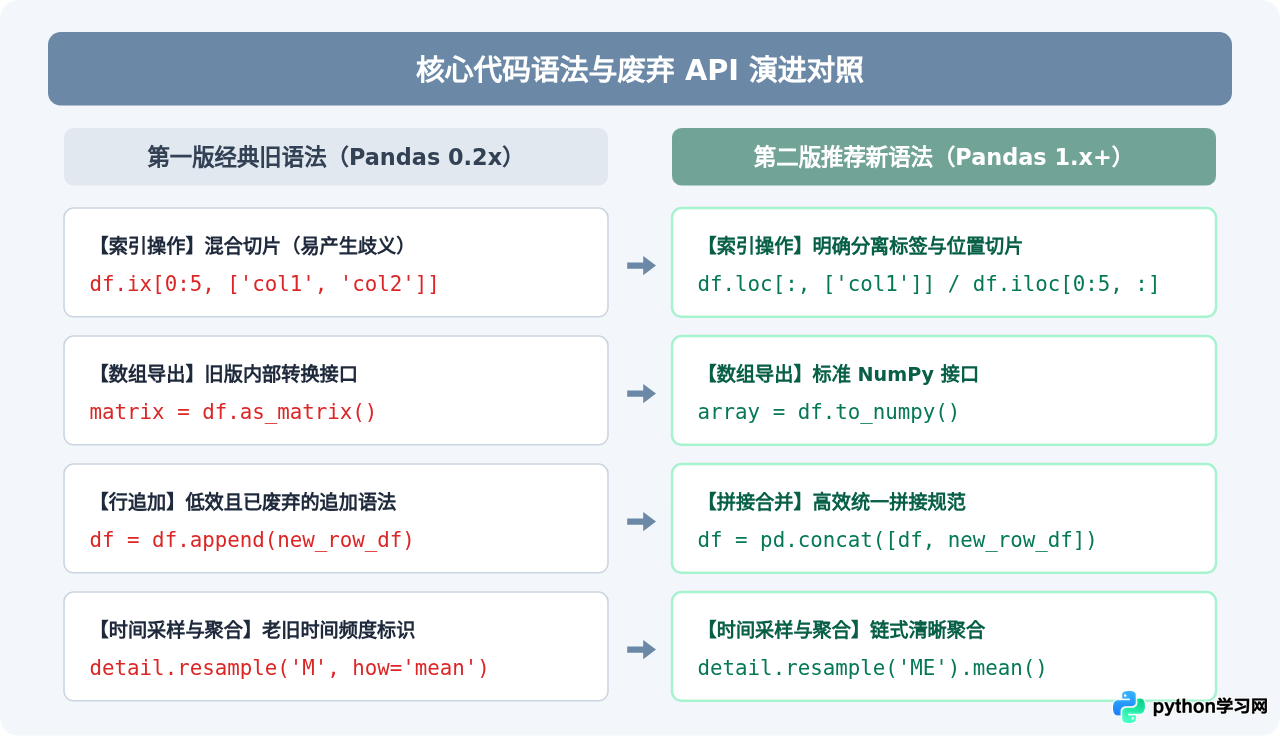
教材两版之间跨越了数据分析主流库的重大迭代。第一版教材出版时,Pandas 的版本普遍处于 0.20 至 0.23 区间;而第二版出版时,Pandas 已全面进入 1.0+ 时代,大量老旧且易混淆的语法被彻底移除。因此,观察习题答案中的代码实现是区分度最高的方法。
1. 索引器语法:ix 与 loc/iloc
在第一版习题答案中,涉及 DataFrame 行列切片时,经常能够见到如下形式的代码:
而在第二版习题答案中,ix 索引器被严格禁止并彻底替换。第二版规范了基于标签的 loc 与基于位置的 iloc:
2. 数据导出接口:as_matrix() 与 to_numpy()
在处理第 5 章或第 6 章机器学习与数据建模习题时,经常需要将 DataFrame 转换为 NumPy 二维数组输入给 Scikit-learn 模型。第一版答案习惯调用已废弃的 df.as_matrix(),而第二版答案严格采用官方推荐的 df.to_numpy() 或 df.values。在现代环境中运行 as_matrix() 会直接触发 AttributeError 致命错误。
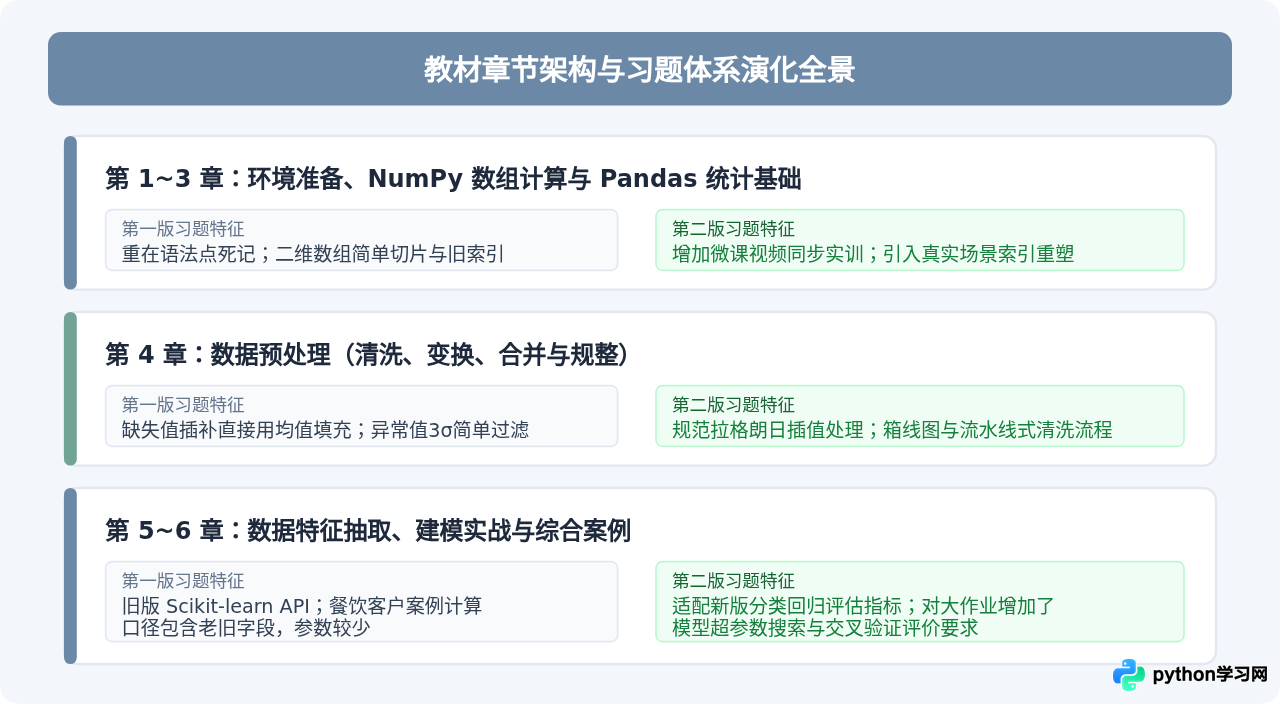
三、章节目录与习题编排体系的结构差异
教材版本迭代不仅停留在单行代码层面,整套教材的教学设计与习题结构也发生了系统性调整。第二版定位为“微课版”,在各章节引入了更多与微课视频直接对应的步骤式实训习题,强化了问题导向的分析训练。
四、实训数据集与案例细节差异
《Python数据分析与应用》以“餐饮企业经营数据分析”等经典实训案例贯穿全书。两版教材在配套数据文件的细节处理上也有明显差异:
- 数据文件编码与加载参数:第一版配套的部分 CSV 文件在 Windows 下默认采用 GBK 或 ANSI 编码,读取时答案代码多写为 pd.read_csv('...', encoding='gbk');第二版配套资源对数据集进行了统一转码与清洗,多数数据文件保存为标准的 UTF-8 编码,答案中参数书写更加规范统一。
- 列名与清洗后结果差异:在第 4 章清洗异常值和空白字符练习中,第一版答案通常直接通过字符串切片替换空格,而第二版答案多结合正则表达式或矢量化字符串方法(如 .str.strip() 与 .str.replace())。
- 图表绘制属性与中文字体配置:在第 3 章与综合案例的 Matplotlib 绘图题中,第一版答案常直接使用简短的全局参数配置,部分图形标签重叠未做边距处理;第二版答案普遍添加了 plt.rcParams['font.sans-serif'] = ['SimHei'] 与 plt.rcParams['axes.unicode_minus'] = False,并显式调用了 plt.tight_layout() 保持布局整洁。
五、综合核对与决策矩阵
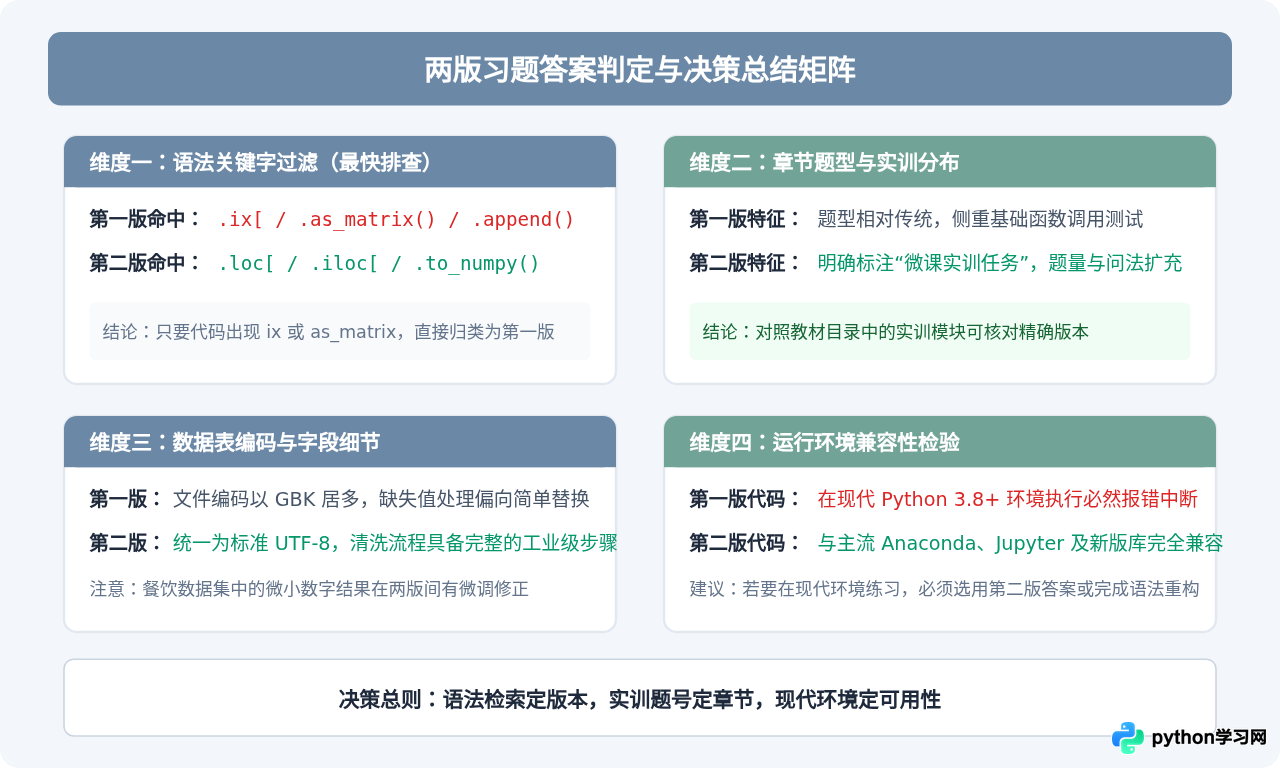
为了帮助读者直观、系统地完成比对,下表将两版习题答案的关键特征集中归纳:
| 核对维度 | 第一版习题答案特征 | 第二版(微课版)习题答案特征 | 判定权重 |
|---|---|---|---|
| 索引取值 | 出现 df.ix[...] 混合索引语法 | 全部使用 df.loc 或 df.iloc | 决定性(100%) |
| 数组转换 | 频繁出现 df.as_matrix() | 采用 df.to_numpy() 或 df.values | 决定性(100%) |
| 数据追加 | 使用 df.append() 拼接新行 | 统一使用 pd.concat() 批量处理 | 高(90%) |
| 时间重采样 | 参数常见 resample('M', how='mean') | 链式写法 resample('ME').mean() | 高(85%) |
| 微课实训题 | 无微课相关题目标记与二维码配套说明 | 包含微课配套实训小题与多维度考核点 | 结构性(95%) |
| 现代环境执行 | 在 Python 3.8+ / Pandas 1.3+ 抛出异常报错 | 在现代环境下无需改动即可顺畅运行 | 验证性(100%) |
六、核对时的常见疑惑与自查要点
若当前手持第二版教材却参考了第一版答案,代码在课后作业判题系统或现代 Jupyter Notebook 环境中会直接因废弃语法抛出异常;反之,若在较老的教学机房(仅预装 Python 3.5 环境)执行第二版答案,可能会遇到部分新特性未支持的情况。因此,做题与核对前务必首先匹配教材与答案的版本一致性。
在实际核对过程中,读者常常遇到以下两类特殊情况:
- 网络下载的“汇总版答案”混合了两版内容:不少网传资料是由历届学生整理拼凑而成,前三章使用了第一版代码,后几章又混入了第二版答案。此时不能仅看前言或第一章,应按本文方法抽查第 2 章 NumPy 数组、第 3 章切片语法以及第 5 章模型导出的关键行。
- 出版年份与书号辅助验证:正规出版教材及配套答案手册均带有出版信息。第一版出版时间大多集中在 2017 年至 2018 年前后,第二版微课版通常在 2021 年之后出版。查看文档属性中的创建时间或配套说明,也是佐证版本的有效线索。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















