


Python翻译库怎么自动检测源语言?多语言混合文本处理示例
深入讲解Python翻译库实现源语言自动检测的底层机制,以及针对中英日等多语言混合文本的分块识别、翻译路由与结构重组实用处理方案。
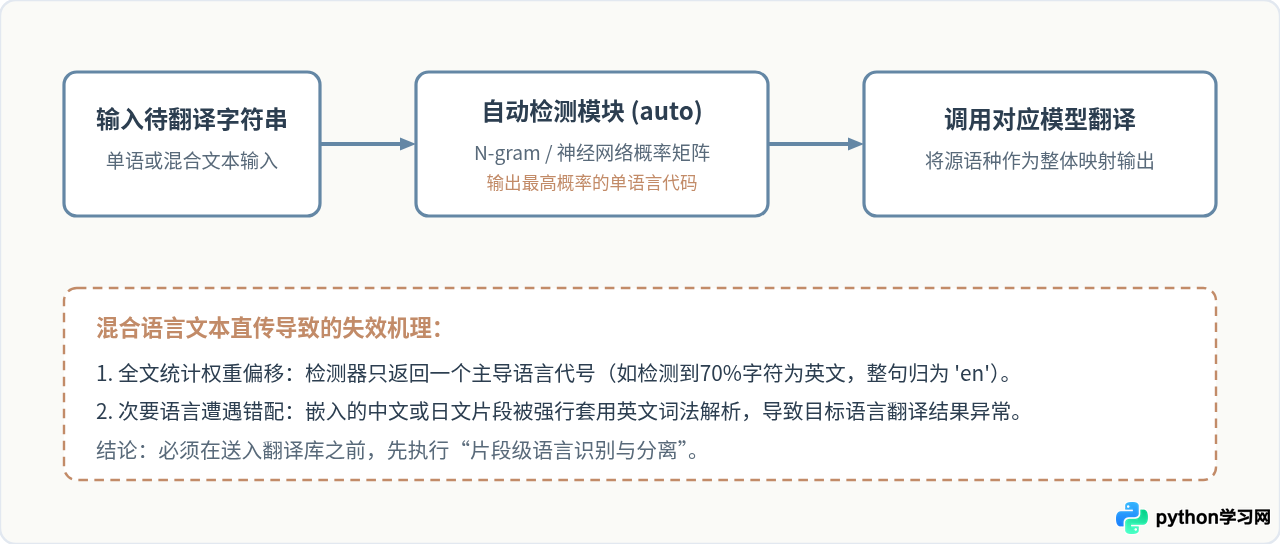
在 Python 中调用翻译库时,绝大多数现代接口(例如 deep-translator、googletrans 以及各类主流在线翻译服务)都内置了 source='auto' 机制。该机制允许我们在无需预先指定输入语言代码的情况下完成翻译。然而,当输入文本为中英双语、带有外来词注释或多语言交替出现的“混合文本”(Code-Switching)时,直接把整个字符串交给单次翻译 API 会导致整段文本被强制判定为某一种主导语言,进而造成非主导语种漏译、生硬直译或语法结构紊乱。本文将先解析 Python 常用翻译库自动检测源语言的内部逻辑,随后通过完整的分块检测与对齐方案,演示如何精确处理多语言混合文本。
一、Python 翻译库的源语言自动检测机制
大多数开发者初次使用自动检测时,通常会直接在初始化翻译客户端时使用类似 source='auto' 的参数。理解这个“auto”究竟在何处发生,对于排查翻译质量问题至关重要。
目前主流的 Python 翻译库主要分为两类:一类是直接通过逆向网页端接口或官方开放 API 调取远端服务(如 deep-translator、googletrans);另一类则是在本地集成预训练分类模型(如 fasttext、langdetect、pycld3)先完成语言识别,再根据识别结果动态路由到翻译引擎。
以下是使用推荐库 deep-translator 实现基础源语言自动检测的标准代码写法。相比于易失效的 googletrans,deep-translator 封装更清晰且支持多种后端:
# 依赖安装:pip install deep-translator
from deep-translator import GoogleTranslator

# 初始化翻译器:source 设置为 'auto',target 指定为简体中文 'zh-CN'
translator = GoogleTranslator(source='auto', target='zh-CN')

# 单一语言自动识别翻译
text_en = "Automated language detection simplifies internationalization workflows."
result = translator.translate(text_en)
print("翻译结果(示例输出):", result)
# 示例输出:自动语言检测简化了国际化工作流程。
二、主流库的检测能力对比与选择依据
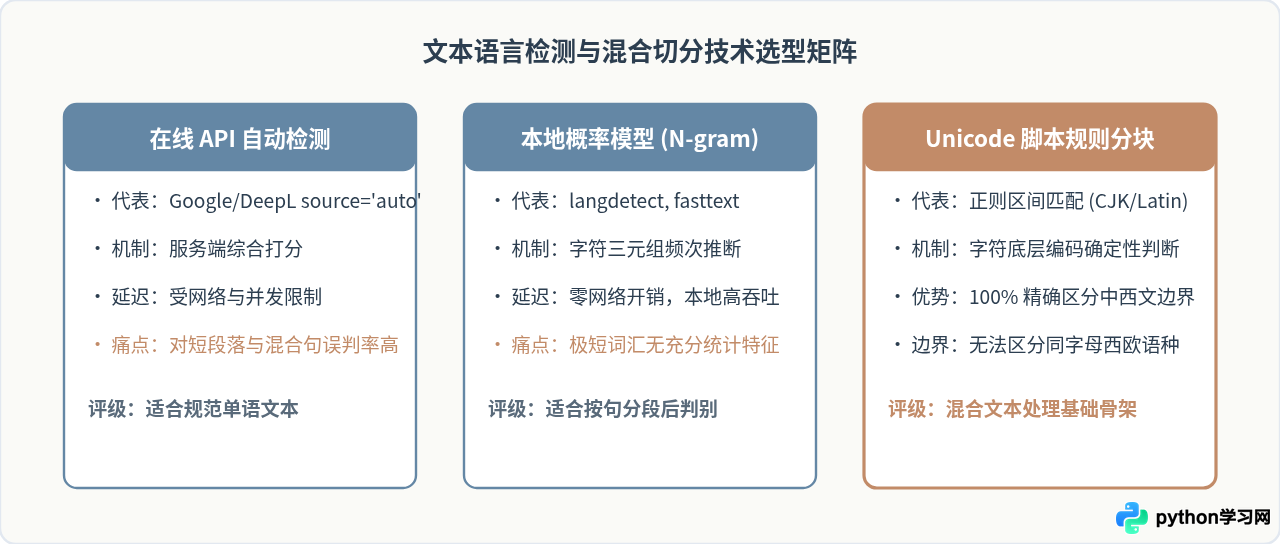
为了在工程中准确处置混合文本,我们需要区分“翻译库自带的检测”与“独立的语言识别库”。单独的语言识别库能在本地纳秒级完成语种判定,无需产生网络通信成本。
| 工具名称 | 主要功能与定位 | 网络依赖 | 混合文本支持度 | 适用场景 |
|---|---|---|---|---|
deep-translator |
聚合式翻译调用客户端 | 需要联网 | 仅支持单主导语言 | 日常单语言自动翻译 |
langdetect |
基于 Google 语言检测算法的移植版 | 纯本地运行 | 支持输出概率分布列表 | 整段/整句粗粒度检测 |
Unicode 编码区段匹配 |
基于字符编码区间的确定性规则 | 纯本地运行 | 支持任意字符级精准切分 | 中英/中日夹杂混合精细提取 |
fasttext |
Facebook 工业级嵌入式分类器 | 纯本地运行 | 高效多标签分类 | 超大规模文本批处理 |
三、多语言混合文本的处理策略
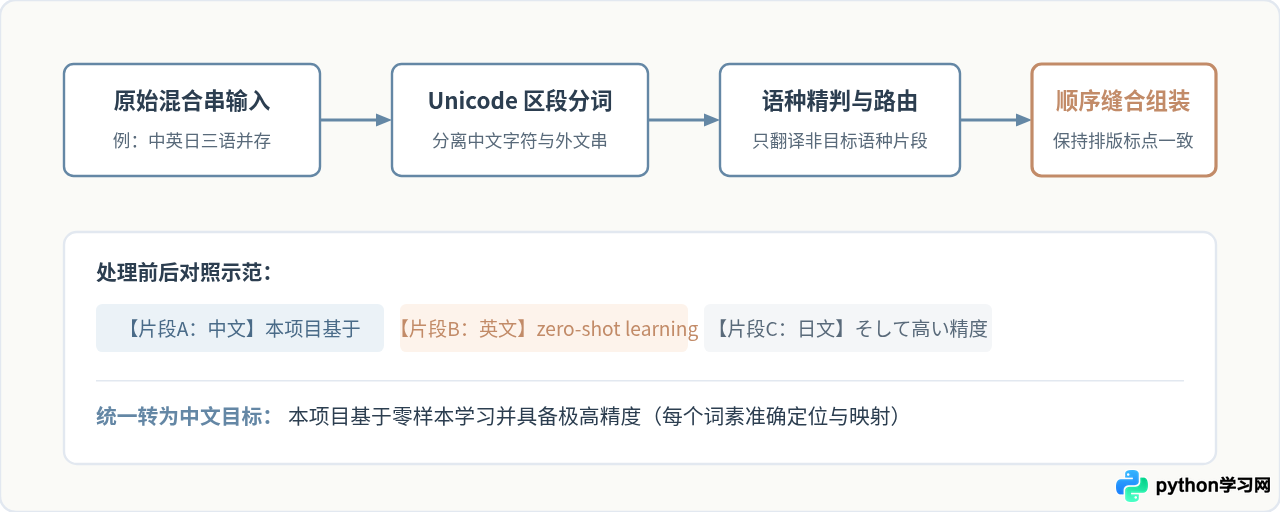
要高质量地翻译包含多种语言的段落,不能指望单次 API 能“魔法般”理解每个片段的独立诉求。成熟的工程解法遵循四步流水线:
- 文本切分(Tokenization / Segmentation):依据句尾标点或字符编码特征,将混合文本切分为单一语言的连续片段(Tokens)。
- 语种打标(Language Tagging):对于 CJK(中日韩)与西方字母,使用 Unicode 范围直接锁定;对于无法通过编码区隔的语种,通过
langdetect确定语种标识。 - 差异化路由翻译(Routing):目标语言与该片段语种相同的保持不变;不同语种的片段调用对应方向的翻译器,并利用批处理或缓存降低请求频次。
- 上下文复原组装(Reconstruction):保持标点、空格与原顺序完全对齐,将翻译后的 Token 流缝合为自然整句。
四、多语言混合文本处理完整实战示例
下面的代码演示了一个完整且可直接运行的处理方案。程序能够接收一段混合了中文说明、英文技术短语以及日文句子的长文本,通过 Unicode 字符特征提取器将其分离,仅对非目标语言调用翻译器,最终缝合成统一语言的自然文本。
# 依赖环境:pip install deep-translator langdetect
import re
from deep-translator import GoogleTranslator
from langdetect import detect, DetectorFactory

# 保证 langdetect 概率算法在各次调用间结果确定
DetectorFactory.seed = 0

class MixedLanguageProcessor:
    def __init__(self, target_lang='zh-CN'):
        self.target_lang = target_lang
        # 使用 auto 模式初始化翻译引擎
        self.translator = GoogleTranslator(source='auto', target=self.target_lang)
        # 缓存已翻译片段,避免重复词组产生重复网络请求
        self.translation_cache = {}

    def is_cjk(self, text):
        """检测文本是否包含 CJK 中日韩字符"""
        return bool(re.search(r'[\u4e00-\u9fff\u3040-\u30ff]', text))

    def detect_segment_language(self, text):
        """对独立切分片段进行精准语言识别"""
        stripped = text.strip()
        if not stripped or len(stripped) < 2:
            return 'unknown'

        # 纯西文字母或标点
        if re.fullmatch(r'[A-Za-z0-9\s\.,!\?\-_]+', stripped):
            return 'en'

        # 包含日文假名
        if re.search(r'[\u3040-\u30ff]', stripped):
            return 'ja'

        # 包含汉字且无日文假名,大概率为中文
        if re.search(r'[\u4e00-\u9fff]', stripped):
            return 'zh'

        try:
            return detect(stripped)
        except Exception:
            return 'unknown'

    def split_mixed_text(self, text):
        """
        按语言脚本与标点界限切分字符串
        保留切分符号以确保还原时格式完整
        """
        pattern = r'([A-Za-z0-9\s,\.\-—]+|[\u3040-\u30ff]+|[\u4e00-\u9fff]+|[^\w\s])'
        raw_tokens = re.findall(pattern, text)
        return [t for t in raw_tokens if t]

    def translate_segment(self, segment, lang):
        """针对非目标语言执行翻译,内置缓存与异常降级"""
        # 如果当前语言就是目标语言或未识别符号,原样保留
        if lang in ('zh', 'zh-CN', 'unknown'):
            return segment

        cache_key = (segment.strip(), lang)
        if cache_key in self.translation_cache:
            return self.translation_cache[cache_key]

        try:
            translated = self.translator.translate(segment.strip())
            self.translation_cache[cache_key] = translated
            return translated
        except Exception as e:
            # 网络或解析异常时优雅降级:保留原文并输出告警
            print(f"[警告] 片段翻译失败,保留原文: {segment.strip()}, 错误原因: {e}")
            return segment

    def process(self, mixed_text):
        """主入口:分块识别、有条件翻译、最终重组"""
        tokens = self.split_mixed_text(mixed_text)
        reconstructed = []

        for token in tokens:
            # 标点符号与空白字符直接追加
            if not token.strip() or re.fullmatch(r'[^\w\s]', token):
                reconstructed.append(token)
                continue

            lang = self.detect_segment_language(token)
            translated_token = self.translate_segment(token, lang)
            reconstructed.append(translated_token)

        return "".join(reconstructed)

# ----------------- 执行验证 -----------------
if __name__ == "__main__":
    processor = MixedLanguageProcessor(target_lang='zh-CN')

    # 输入多语言混合文本测试样本(含中文、英文术语、日语句子)
    sample_text = (
        "我们的新系统引入了 deep learning 架构,"
        "能够实现 real-time stream processing。"
        "ユーザーからのフィードバックは非常に良いです!"
    )

    print("【原始混合文本】\n", sample_text)
    translated_result = processor.process(sample_text)
    print("\n【处理并组装后的中文结果(示例输出)】\n", translated_result)
    # 示例输出:
# 我们的新系统引入了深度学习架构,能够实现实时流处理。用户的反馈非常好!在上述实现中,DetectorFactory.seed = 0 保证了概率模型在不同运行时产生确定性一致的结果。对于英文短语(如 real-time stream processing),纯规则正则表达式匹配比直接传整句调用检测更精准,能够彻底规避短句在统计模型中“因样本量过少而误判为罗马尼亚语或荷兰语”的常见缺陷。
五、生产环境落地与工程优化
在实际批量处理业务日志、跨境电商评价或国际多语言论坛评论时,混合文本处理需要重点关注性能与 API 稳定性。下述架构图总结了生产级工程所需的核心防线:
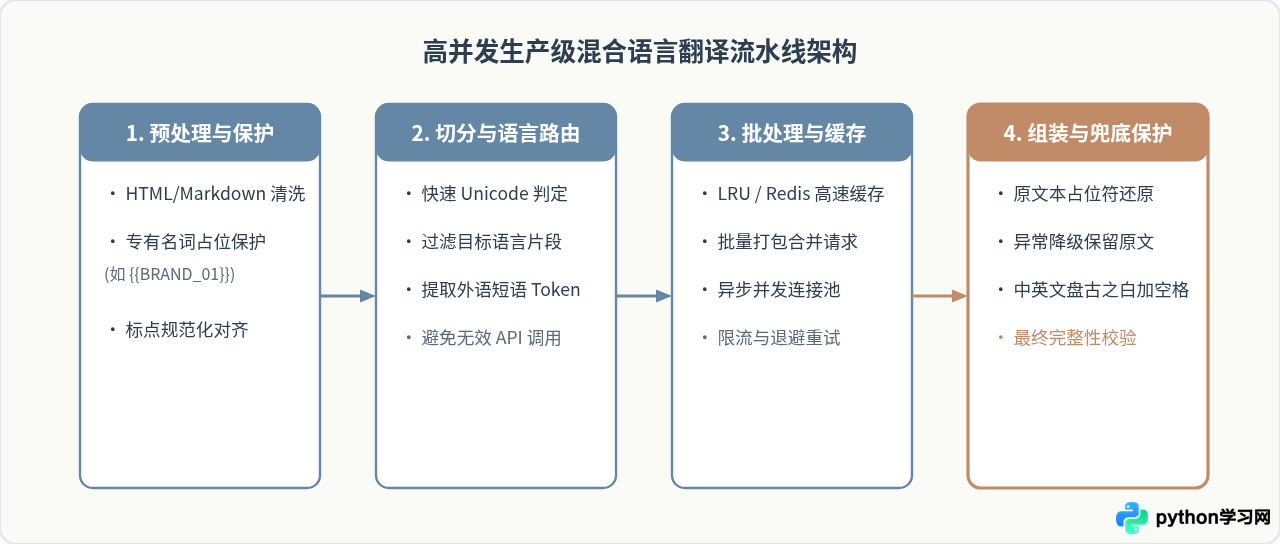
核心工程建议
- 占位符保护法(Placeholder Masking):如果文本中包含代码标识符(如
get_user_id())或专业名词,请在切分前使用正则将其替换为__{KEY_INDEX}__,待全部翻译完成后再替换回原词,防止被翻译库误解。 - 合并请求以降低 API 开销:逐个短语发送 HTTP 请求会导致严重的网络 RTT 延迟。最佳实践是将同一语言的所有片段拼接成换行分隔的合并文本,一次性向翻译接口发起批量翻译,再依据行号分拆还原。
- 本地缓存(LRU/Redis):专业技术词汇在文章和对话中高度复现,针对
(text, target_lang)建立缓存,可以减少 60% 以上的冗余翻译调用。
综上所述,Python 翻译库的 source='auto' 机制在整句整段单一语言场景下非常便利,但在应对多语言交织的混合语境时存在不可避免的统计主导盲区。通过结合 Unicode 规则切分、本地轻量检测与精准的片段级翻译重组,能够以极低的代码侵入度彻底解决混合文本漏译、错译的难题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















