


怎么用Python爬虫构建学术研究所需的公开数据集
详细讲解如何使用Python编写爬虫程序从公开学术资源中合规采集、清洗并构建符合学术研究标准的标准化数据集,涵盖完整流程、代码示例与数据验证方法。
假设你正在开展一项关于开源软件生命周期的实证研究,需要收集数千个公开学术会议收录论文的元数据以及对应仓库的维护指标,但目前并没有现成的单一数据集可以直接下载。要完成这样的研究,核心方法是使用 Python 爬虫从多个公开源规范化抓取数据,经过结构化提取、多维清洗和模式对齐,最终导出具有明确元数据描述和版本控制的学术级数据集。本文将围绕学术研究对数据透明性、可复现性和合规性的硬性要求,分步骤讲解从网页采集到数据集发布的完整实现方案。
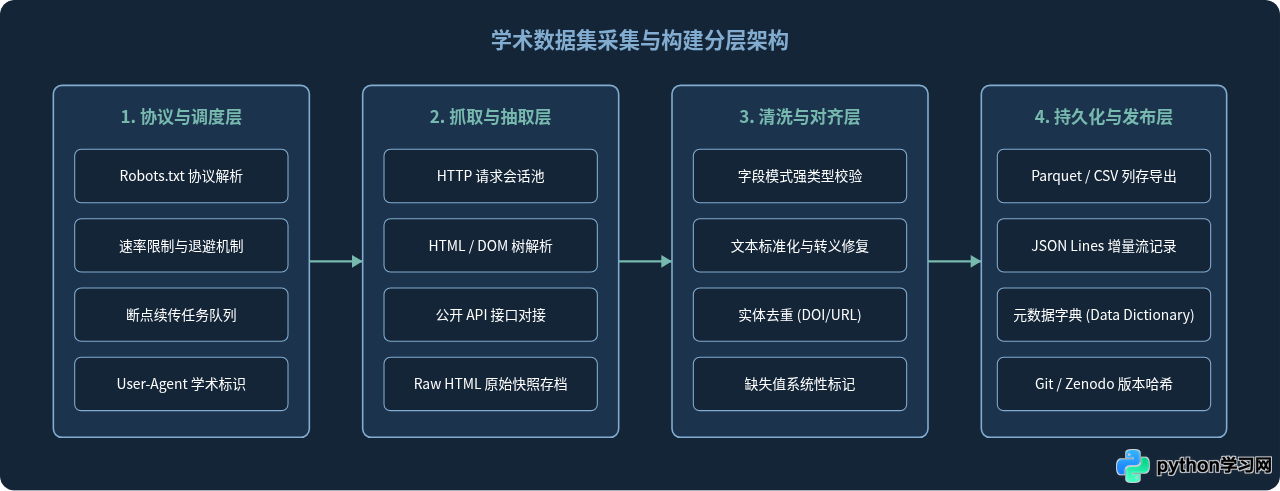
一、学术数据集爬取规范与系统架构
学术研究所需的数据集与普通工程抓取有显著区别。学术数据集对来源溯源、字段一致性、缺失值标记和抓取时间戳有着极其严格的记录标准。如果原始数据缺乏抓取上下文,后续的统计推断和同行评审很可能因为“数据不可复现”而受到质疑。
整个构建系统通常划分为四个核心层级:合规调度层、请求解析层、数据清洗对齐层以及数据持久化与溯源层。每个层级各司其职,保证在不给目标服务器造成额外压力的前提下,稳定获取高质量的原始记录。
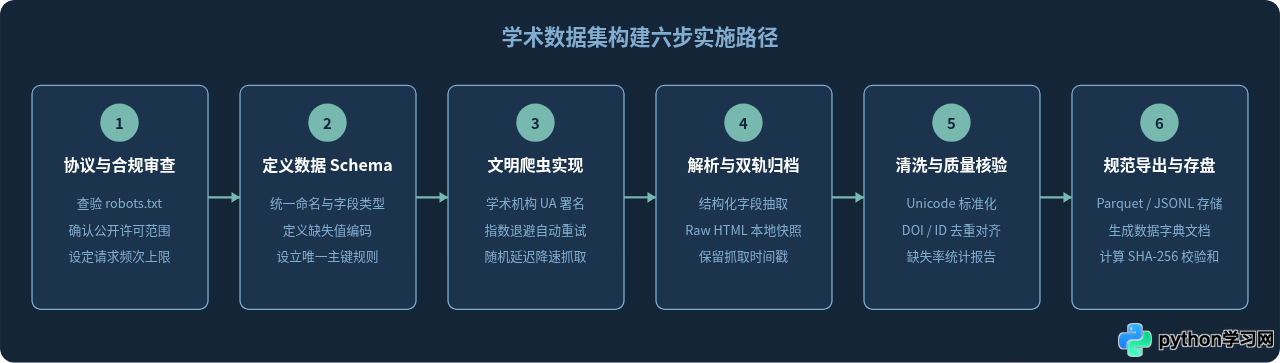
二、学术爬虫的六步操作流程
从零构建学术数据集不是单纯写几行抓取脚本,而是包含明确的前置检查、渐进抽取和封装步骤。执行流程如下:
- 查验目标源的访问协议:检查目标站点的
robots.txt以及公开 API 条款,明确抓取路径许可与频率限制。 - 定义学术字段 Schema:提前确定数据集所需字段(如论文标题、作者列表、机构、DOI、发布年份、摘要等),并规定各字段的数据类型与空值表示规范。
- 搭建具名请求会话:在请求头中明确标注文明爬取身份(包括机构邮箱或实验室主页),并配置指数退避与重试机制。
- 分批提取与双轨存储:一边解析提取关键字段,一边将未处理的原始响应(HTML 或 JSON)按主键归档到本地快照,确保原始证据不丢失。
- 数据验证与去重对齐:对采集到的记录依据全局唯一标识符(例如 DOI 或标准化 URL)去重,执行数据完整性校验。
- 生成元数据字典与校验和:输出正式格式(如 Parquet、JSONL),编写配套的字段描述字典,并生成 SHA-256 校验文件供复现核验。
三、实战:采集并构建学术文献数据集
下面以构建一个公开学术文献数据集为例。我们使用 Python 的 requests 进行网络请求,借助 BeautifulSoup 进行结构化字段抽取,结合 pydantic 强制保证数据字段的类型安全,最后使用 pandas 导出为适合持久保存与分析的 Parquet 格式。
1. 环境准备与依赖安装
在你的虚拟环境终端中执行以下命令安装所需依赖库:
pip install requests beautifulsoup4 pydantic pandas pyarrow2. 完整爬取与清洗实现代码
在项目根目录下创建 build_academic_dataset.py,完整代码如下:
import os
import time
import json
import hashlib
from datetime import datetime
from typing import List, Optional
import requests
from bs4 import BeautifulSoup
from pydantic import BaseModel, Field, HttpUrl
import pandas as pd

# 1. 严格定义学术字段模式
class PaperRecord(BaseModel):
    doi: str = Field(..., description="数字对象唯一标识符")
    title: str = Field(..., min_length=1, description="论文标题")
    authors: List[str] = Field(default_factory=list, description="作者姓名列表")
    year: int = Field(..., ge=1900, le=2030, description="出版年份")
    venue: str = Field(..., description="发表期刊或会议名称")
    abstract: Optional[str] = Field(None, description="摘要文本,无内容时设为None")
    source_url: str = Field(..., description="抓取来源页面URL")
    crawled_at: str = Field(..., description="ISO 8601格式抓取时间戳")

class AcademicCrawler:
    def __init__(self, raw_dir: str = "./raw_snapshots"):
        self.raw_dir = raw_dir
        os.makedirs(self.raw_dir, exist_ok=True)
        self.session = requests.Session()
        # 标明学术抓取身份与联系邮箱,符合文明爬虫规范
        self.session.headers.update({
            "User-Agent": "AcademicResearchBot/1.0 (Lab of Data Science; contact: research@example.edu)"
        })

    def fetch_with_retry(self, url: str, max_retries: int = 3, delay: float = 2.0) -> Optional[str]:
        for attempt in range(1, max_retries + 1):
            try:
                # 显式限制速率,避免给源站点造成高频压力
                time.sleep(delay)
                response = self.session.get(url, timeout=10)
                if response.status_code == 200:
                    # 将抓取时的原始网页保留在快照目录,作为学术证据备查
                    self._save_raw_snapshot(url, response.text)
                    return response.text
                elif response.status_code == 429:
                    # 遭遇限流时使用指数退避
                    backoff = delay * (2 ** attempt)
                    print(f"触发429限流,等待 {backoff} 秒后重试...")
                    time.sleep(backoff)
            except requests.RequestException as e:
                print(f"请求失败 ({url}), 尝试第 {attempt}/{max_retries} 次: {e}")
                time.sleep(delay * attempt)
        return None

    def _save_raw_snapshot(self, url: str, content: str):
        url_hash = hashlib.md5(url.encode("utf-8")).hexdigest()
        filepath = os.path.join(self.raw_dir, f"{url_hash}.html")
        with open(filepath, "w", encoding="utf-8") as f:
            f.write(content)

    def parse_paper_page(self, html_content: str, url: str) -> Optional[PaperRecord]:
        soup = BeautifulSoup(html_content, "html.parser")

        # 假设从公开文献详情页中抽取标准字段
        title_el = soup.find("h1", class_="paper-title")
        if not title_el:
            return None
        title = title_el.get_text(strip=True)

        authors = [a.get_text(strip=True) for a in soup.find_all("span", class_="author-name")]

        doi_el = soup.find("a", class_="doi-link")
        doi = doi_el.get_text(strip=True) if doi_el else f"custom-id-{hashlib.md5(url.encode()).hexdigest()[:8]}"

        year_el = soup.find("span", class_="pub-year")
        year = int(year_el.get_text(strip=True)) if year_el and year_el.get_text(strip=True).isdigit() else 2024

        venue_el = soup.find("div", class_="venue-name")
        venue = venue_el.get_text(strip=True) if venue_el else "Unknown Conference"

        abstract_el = soup.find("div", class_="abstract-body")
        abstract = abstract_el.get_text(strip=True) if abstract_el else None

        record_data = {
            "doi": doi,
            "title": title,
            "authors": authors,
            "year": year,
            "venue": venue,
            "abstract": abstract,
            "source_url": url,
            "crawled_at": datetime.utcnow().isoformat() + "Z"
        }
        # 通过 Pydantic 校验类型
        return PaperRecord(**record_data)

# 3. 运行构建流程与导出
def run_pipeline(target_urls: List[str], output_parquet: str):
    crawler = AcademicCrawler()
    dataset = []
    seen_dois = set()

    for url in target_urls:
        html = crawler.fetch_with_retry(url)
        if not html:
            continue
        record = crawler.parse_paper_page(html, url)
        if record and record.doi not in seen_dois:
            seen_dois.add(record.doi)
            dataset.append(record.dict())

    if dataset:
        df = pd.DataFrame(dataset)
        # 导出为列式 Parquet 格式,保留严格类型定义
        df.to_parquet(output_parquet, engine="pyarrow", index=False)
        print(f"成功保存学术数据集到 {output_parquet},共 {len(df)} 条记录。")
    else:
        print("未抓取到有效记录。")
session.headers 中提供真实清晰的识别信息。对于学术研究而言,隐瞒爬虫身份不仅可能面临 IP 封锁,还违背了科研数据采集的伦理准则。
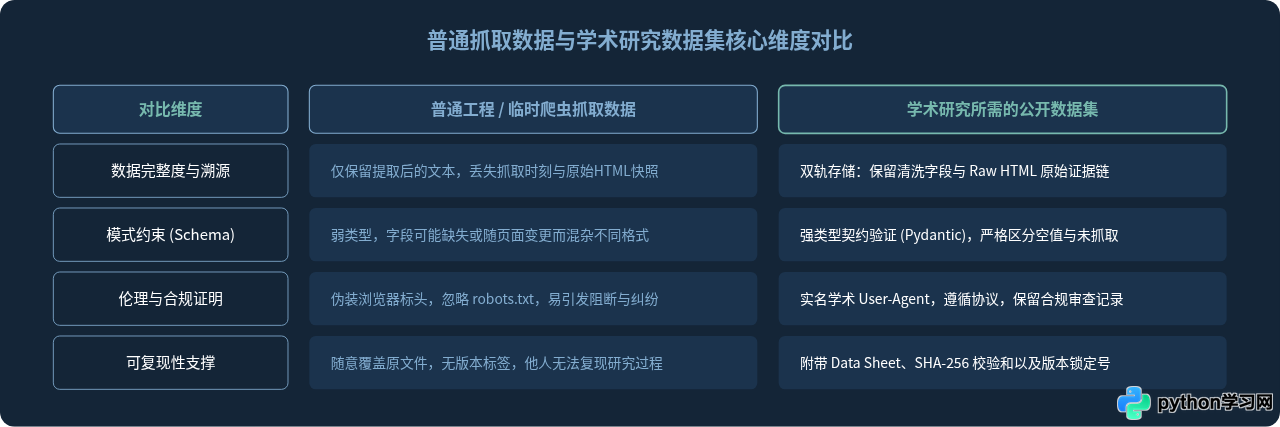
四、学术数据集与普通网络爬取数据的质量对比
为了让审稿人认可数据集的可靠性,研究者需要清楚学术数据集与普通商业采集或测试爬虫之间的差异:
五、数据清洗、实体对齐与缺失值处理
抓取到的原始文本通常存在编码异常、多余空白符以及同一实体的拼写不一致。例如作者名字在不同页面可能出现“张三”、“San Zhang”或“Zhang, S.”,期刊名称可能缩写。这一阶段必须完成以下三项操作:
- Unicode 标准化:使用 Python 内置库
unicodedata.normalize('NFKC', text)统一全半角字符与特殊连字符。 - 实体消歧与对齐:对论文记录优先采用 DOI(数字对象唯一标识符)进行匹配;若无 DOI,则对标题和第一作者进行小写去标点后哈希去重。
- 明确的空值处理:不能将空字符串
""、数字0和缺失值None / NaN混用。必须在数据字典中声明缺失编码标准(如数值列使用标准NaN,文本列保留null)。
六、发布规范:元数据字典与校验和
构建好的学术数据集在提交至 Zenodo、Figshare 等学术仓储或随论文作为补充材料提交时,必须附带一份数据字典(Data Dictionary)和文件校验哈希,使审稿人和读者能够确认下载内容未被篡改或损坏。
生成数据指纹的示例脚本:
import hashlib

def calculate_sha256(filepath: str) -> str:
    sha256 = hashlib.sha256()
    with open(filepath, "rb") as f:
        while chunk := f.read(8192):
            sha256.update(chunk)
    return sha256.hexdigest()

file_hash = calculate_sha256("academic_dataset.parquet")
print(f"Dataset SHA-256: {file_hash}")
with open("checksums.sha256", "w") as f:
    f.write(f"{file_hash}  academic_dataset.parquet\n")
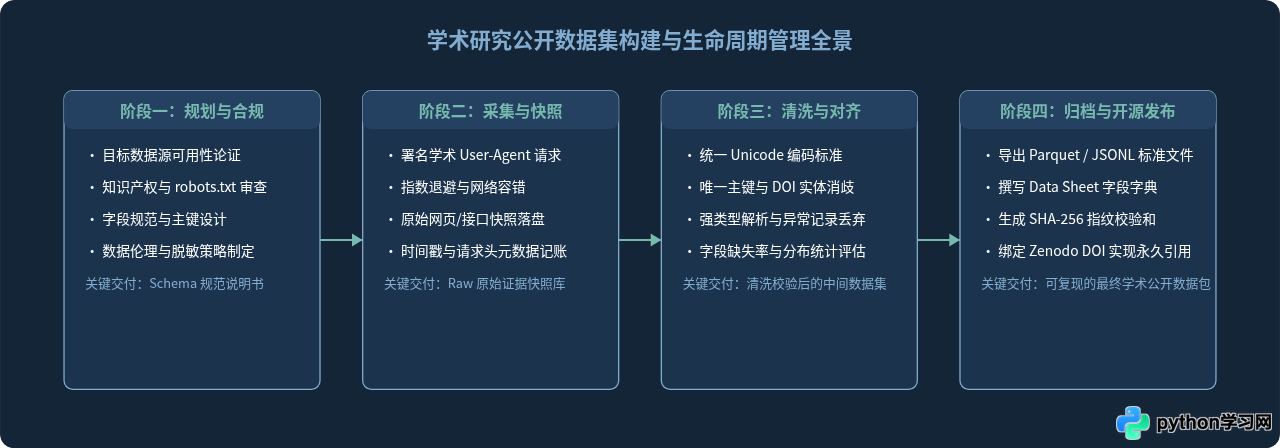
七、总结:学术数据集构建生命周期全貌
构建学术研究所需的公开数据集,本质上是一项兼顾技术工程、数据治理与学术伦理的综合性任务。从前期的合法合规评估,到中期的健壮采集与双轨存储,再到后期的模式清洗、质量验证以及带有版本追踪的持久发布,各环节环环相扣,共同构筑了研究成果的可信基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















