


Python set()转换与字面量定义集合的区别及适用场景
深入对比 Python 中使用 set() 内置函数转换与使用花括号字面量定义集合的核心区别,从语法表现、解构机制、底层字节码执行模型到实际工程选型场景全面解析。
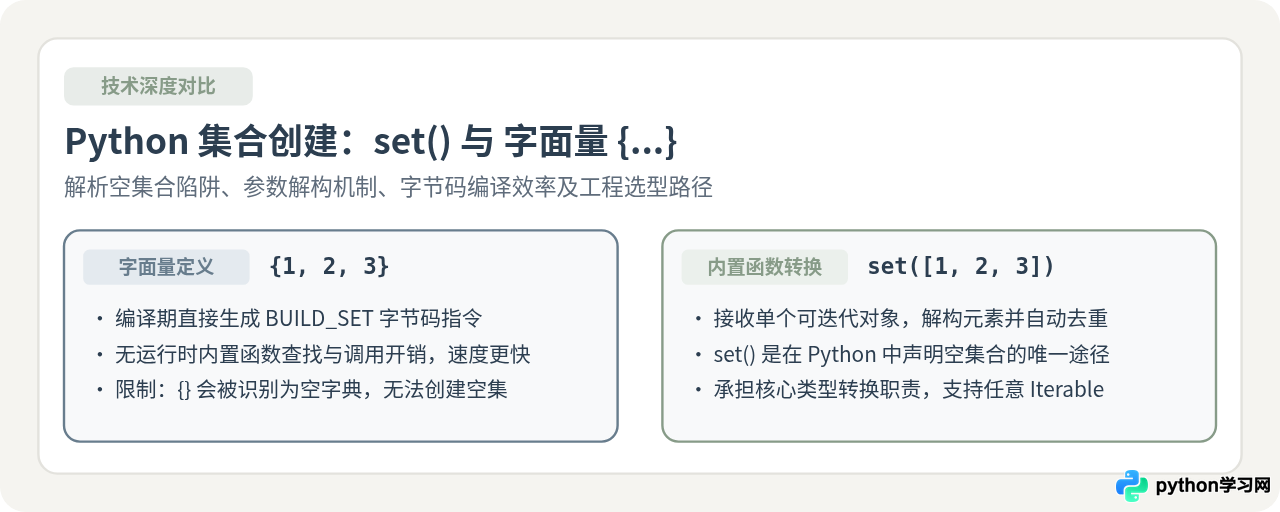
{1, 2, 3} 或调用内置构造函数 set([1, 2, 3])。两者最终都会生成标准的 set 对象,但在运行机制与使用约束上有本质不同:花括号字面量在编译期直接由专用字节码 BUILD_SET 在栈上快速构建,执行效率极高,但无法直接定义空集合;而 set() 则承担容器解构与类型转换职责,能够接收任意可迭代对象进行元素去重,并且是创建空集合的唯一语法途径。
一、语法形式与基础使用对比
Python 在 2.x 后期及 3.x 中引入了花括号集合字面量语法。开发者在日常编码时,常常会在字面量与内置函数之间做选择。理解它们的第一步,是认清它们的语法书写形式及关键语法特例。
集合字面量通过花括号包裹以逗号分隔的离散元素完成定义,例如 colors = {"red", "green", "blue"}。这种写法与 Python 中的字典非常类似,但内部只有独立的值而没有冒号键值对。内置函数 set() 则是一个构造器,它接收最多一个参数,该参数必须是一个可迭代对象(如列表、元组、字符串或生成器)。
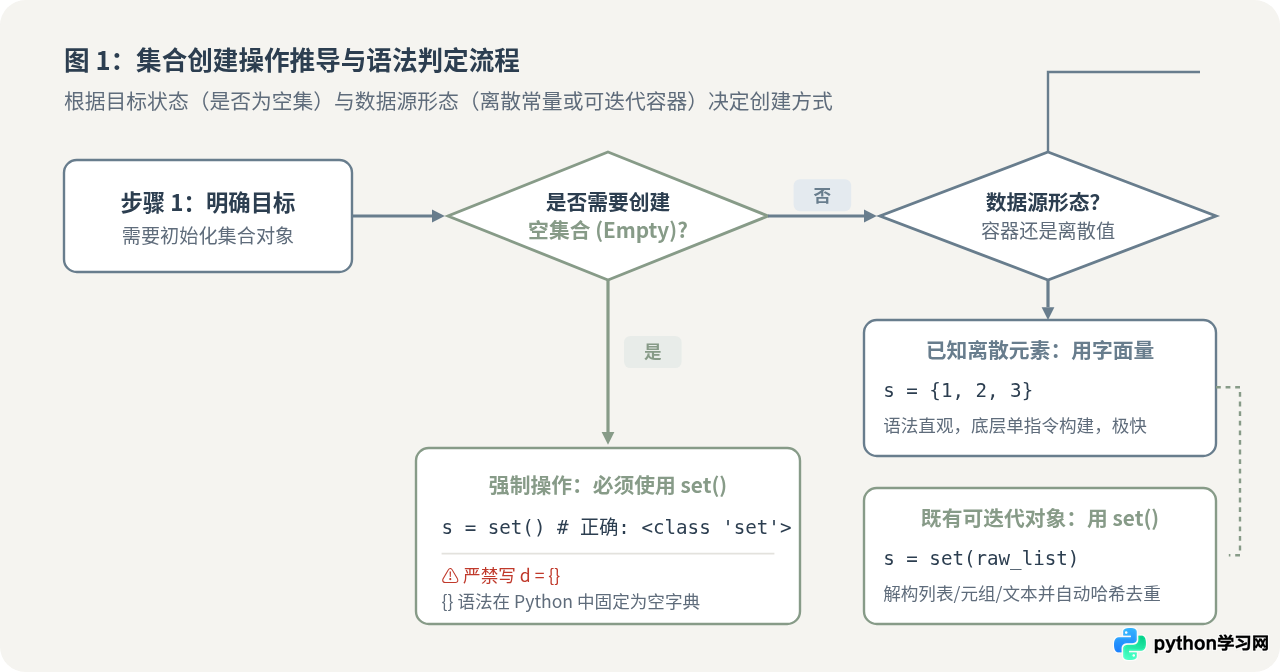
关键陷阱:空集合的定义
许多初学者最容易犯的错误是试图使用空花括号 {} 来创建一个空集合。在 Python 的语法规范中,{} 已经被保留用于创建空字典(dict)。
以下代码清晰地展示了该语法特性:
# 示例:创建空容器的类型检查
empty_literal = {}
empty_func = set()

print("empty_literal 类型:", type(empty_literal))
print("empty_func 类型:", type(empty_func))empty_func 类型: <class 'set'>
s = {} 当作空集合使用,后续在调用集合特有的 s.add(item) 方法时,代码将抛出 AttributeError: 'dict' object has no attribute 'add' 运行时异常。声明空集合时,必须且只能书写 s = set()。
二、传参机制与数据解析差异
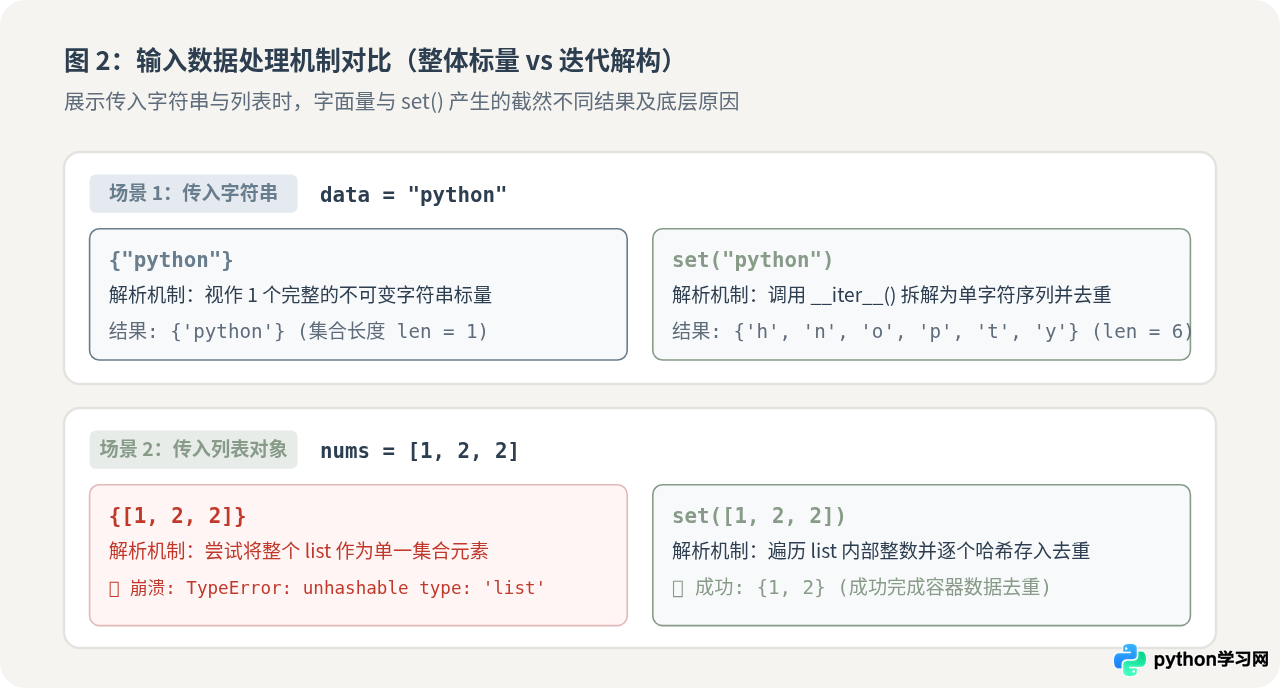
字面量与构造函数在接收数据时的“解析粒度”完全不同。字面量接收的是逗号分隔的一个个独立元素表达式;而 set() 接收的是一个整体的可迭代容器,并在内部触发迭代解构协议。
1. 处理字符串时的差异
当传入同一个字符串时,两种语法产生的结果截然不同:
# 示例:传入相同字符串 "python"
literal_set = {"python"}
func_set = set("python")

print("字面量生成结果:", literal_set)
print("set() 函数生成结果:", func_set)set() 函数生成结果: {'p', 'y', 't', 'h', 'o', 'n'}
字面量 {"python"} 将整个字符串当作单一不可变元素对待,生成包含 1 个元素的集合;而 set("python") 则将字符串视作字符序列,通过遍历解构为 6 个独立的单字符并装入集合。
2. 处理非哈希对象与参数个数限制
集合要求其所包含的所有元素都必须是可哈希(Hashable)的。然而,在传参时两者的错误触发时机存在关键差别:
-
字面量中放入不可哈希对象:如果编写
[1, 2, 3],解释器会试图把整个list作为集合的一个元素,由于list是可变对象不可哈希,立即报TypeError: unhashable type: 'list'。 -
构造函数传入容器对象:如果编写
set([1, 2, 3]),set()提取的是列表内部的整型数字1, 2, 3。由于整数本身可哈希,因此能够正常去重并生成合法集合{1, 2, 3}。 -
构造函数的多参数误用:
set()只接收 0 个或 1 个参数。如果像字面量那样传入多个逗号隔开的离散元素(如set(1, 2, 3)),会报TypeError: set expected at most 1 argument, got 3。
三、底层字节码与执行性能深度对比
除了语法与参数解析的区别,字面量与 set() 在 Python 虚拟机(CPython)中的执行路径有着显著的性能差异。
我们可以使用 Python 标准库中的 dis 模块反编译两个定义集合的极简函数,观察底层字节码指令流:
import dis

def make_by_literal():
    return {1, 2, 3}

def make_by_func():
    return set([1, 2, 3])

print("--- 字面量字节码 ---")
dis.dis(make_by_literal)

print("
--- 函数调用字节码 ---")
dis.dis(make_by_func)2 0 LOAD_CONST 1 (1)
2 LOAD_CONST 2 (2)
4 LOAD_CONST 3 (3)
6 BUILD_SET 3
8 RETURN_VALUE
--- 函数调用字节码 ---
5 0 LOAD_GLOBAL 0 (set)
2 BUILD_LIST 0
4 LOAD_CONST 1 ((1, 2, 3))
6 LIST_EXTEND 1
8 PRECALL 1
12 CALL 1
22 RETURN_VALUE
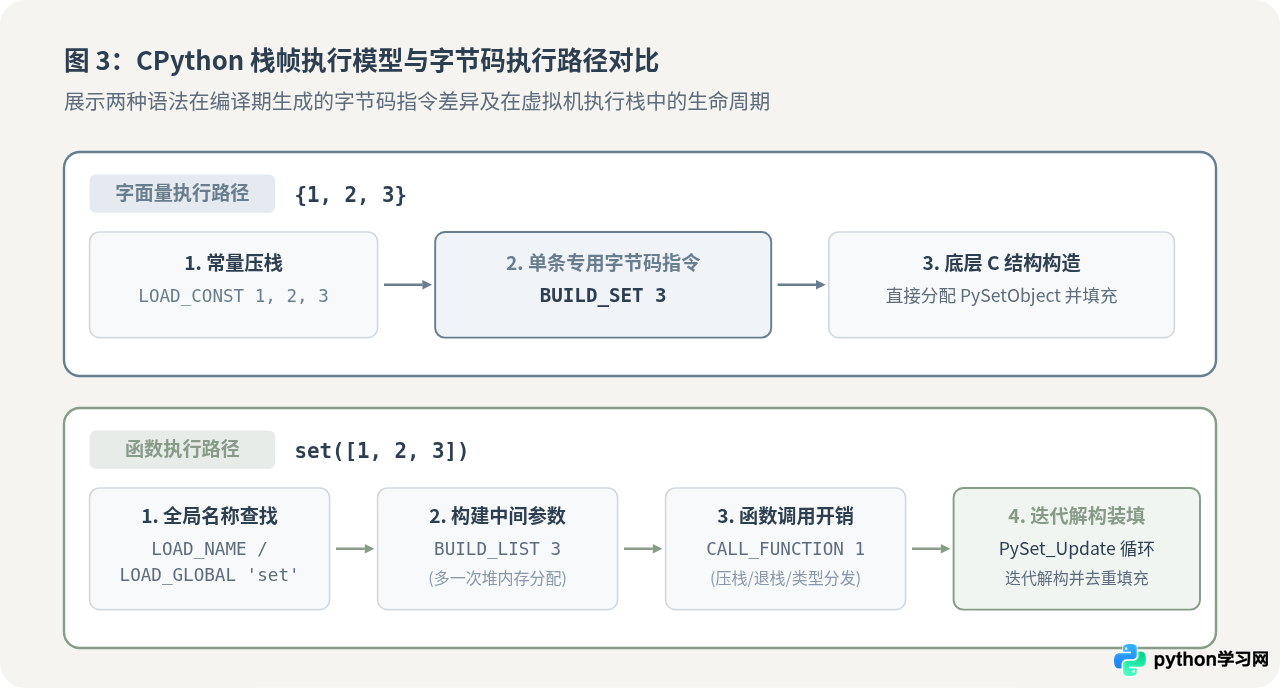
字节码层面的核心差异分析:
-
指令精简度:字面量语法直接通过
BUILD_SET 3将虚拟机评估栈上的 3 个常量弹入新分配的 C 底层PySetObject,过程几乎无额外消耗。 -
命名空间查找开销:
set()是内置命名空间中的一个类对象。虚拟机必须先执行LOAD_GLOBAL(或LOAD_NAME)在当前作用域及内置作用域中解析'set'符号。 -
临时对象创建与函数栈帧:
set([1, 2, 3])在调用前需要先在堆上分配一个临时列表list,接着通过CALL指令进入类型构造器,构造器再通过遍历该列表的迭代器接口填充集合,最后销毁临时列表。这带来了额外的内存分配与垃圾回收负担。
在基准测试中,对于固定长度的小型集合,字面量定义的执行速度通常比 set([...]) 构造快 2 到 4 倍。因此在定义固定配置项或枚举项时,应始终首选字面量。
四、典型适用场景与选型指南
通过上述机制对比,可以清晰划分出两种方式在实际工程代码中的适用边界:
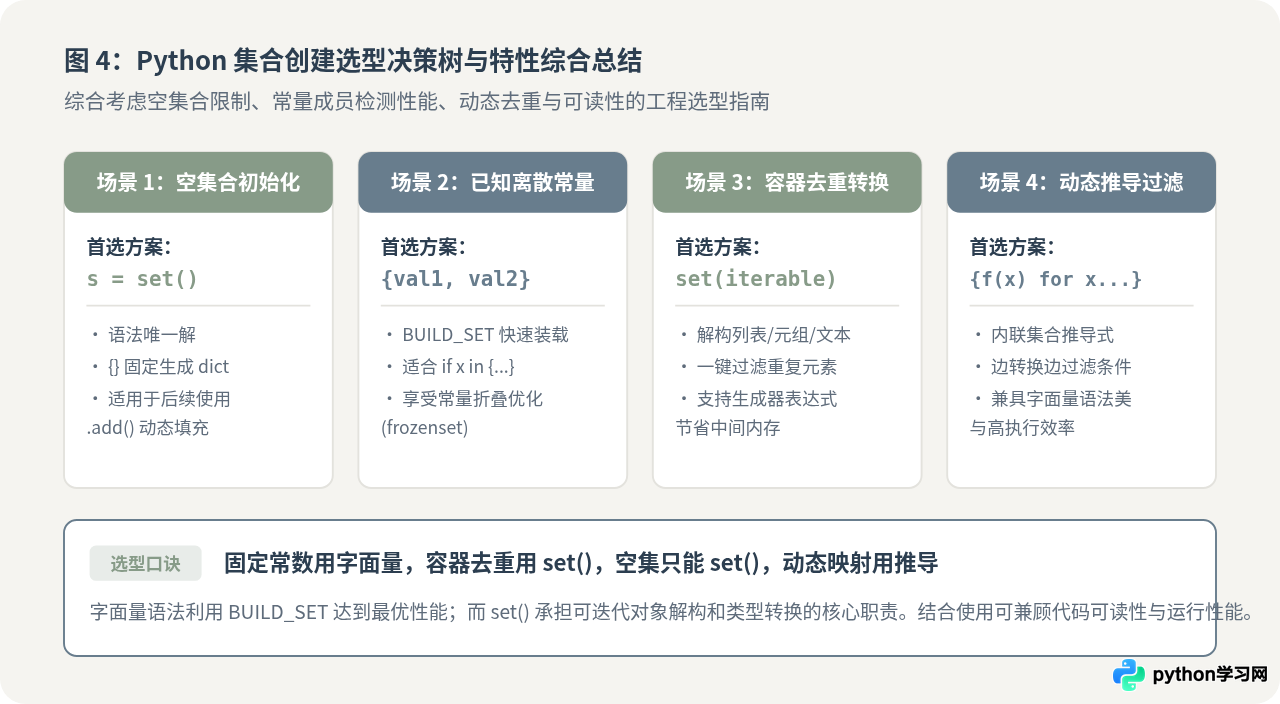
场景 1:空集合初始化(必须使用 set())
当需要在循环或业务分支前先初始化一个空集合,并在后续过程中通过 .add() 或 .update() 动态累积元素时,set() 是唯一合法的声明方式。
# 正确实践:初始化空集合用于动态收集已访问节点
visited_nodes = set()

for node in graph.get_neighbors(start_node):
    if node not in visited_nodes:
        visited_nodes.add(node)
场景 2:已知离散常量的成员判断(首选字面量 {...})
当集合的成员在编写代码时就已经固定,且常用于 in 关系判断时,字面量无论在可读性还是性能上都是最佳选择。在某些场景下,Python 编译期还会将字面量常量集合直接优化折叠为 frozenset 常量,实现零运行时构造开销。
# 良好实践:在校验逻辑中使用字面量集合
ALLOWED_STATUSES = {"pending", "approved", "rejected"}

def update_status(status: str):
    if status not in ALLOWED_STATUSES:
        raise ValueError(f"非法状态: {status}")
    # 执行后续更新逻辑
场景 3:现有数据容器的类型转换与去重(首选 set(iterable))
当数据已经存在于列表、元组、文件行对象或数据库游标等可迭代容器中,需要去除重复值或利用集合的高性能差集/交集计算时,必须使用 set() 进行转换。
# 常见实践:列表数据去重
raw_user_ids = [1001, 1002, 1001, 1005, 1002, 1006]
unique_user_ids = set(raw_user_ids)

print("去重后唯一 ID 集合:", unique_user_ids)场景 4:动态过滤与映射(优先使用集合推导式)
若需要从现有序列中提取元素并进行运算处理,同时生成无重复集合,集合推导式 {expr for item in iterable if cond} 是结合了字面量高效指令与函数式动态迭代的最优解法:
# 集合推导式:过滤空值并标准化为小写
raw_tags = [" Python ", "python", "Django", "  ", "FLASK", "django"]
clean_tags = {tag.strip().lower() for tag in raw_tags if tag.strip()}

print("标准化标签集合:", clean_tags)五、综合对比与总结对照表
为了方便快速查阅,下表全面归纳了 set() 构造与字面量定义的核心维度差异:
| 对比维度 | 花括号字面量 {...} |
内置函数 set(...) |
|---|---|---|
| 语法形式 | {item1, item2, ...} |
set(iterable) 或 set() |
| 空集合支持 | ❌ 不支持({} 会被识别为字典) |
✅ 唯一合法的空集合创建方式 |
| 底层实现机制 | 由 BUILD_SET 字节码直接在栈上构造 |
全局命名空间查找 + 函数调用 + 迭代协议装填 |
| 执行性能 | 极高(无函数调用与中间对象开销) | 较低(含函数分发与迭代开销) |
| 传参要求 | 多个以逗号分隔的合法哈希值 | 仅接收 0 个或 1 个可迭代容器对象 |
| 字符串处理结果 | {"abc"} 得到长度为 1 的 {'abc'} |
set("abc") 拆解为字符序列 {'a', 'b', 'c'} |
| 典型适用场景 | 固定常量枚举定义、快速成员包含判断 | 空集合声明、已有容器去重、可迭代对象类型转换 |
总结而言,选择哪种方式取决于数据的初始来源与目标形态:定义固定的已知常量集合,优先使用字面量语法以换取更直观的代码风格与更高的执行性能;面对容器类型去重转换或需要初始化空集合时,则规范使用 set() 函数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















