


Python中怎么使用for循环遍历列表、字典和字符串
详细讲解在Python中使用for循环遍历列表、字典和字符串的具体方法,包含直接遍历、带索引遍历、键值对解包以及遍历修改容器的常见陷阱与解决方案。
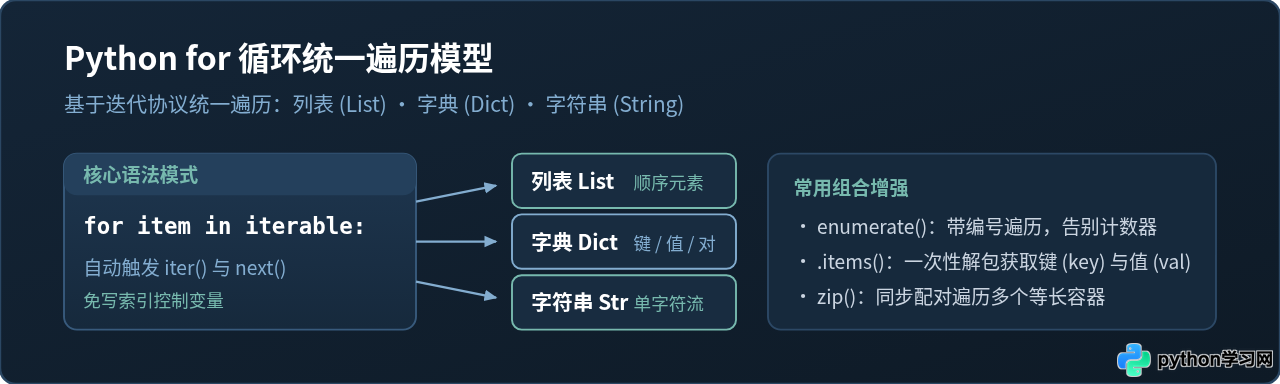
for循环并不是基于传统的数值计数器(如 C/Java 中的 for(i=0; i<n; i++)),而是依托底层的迭代器协议(Iterator Protocol)工作的。无论面对的是有序序列(列表、字符串)还是键值映射(字典),语法形式均统一为 for 变量 in 可迭代对象:。针对列表和字符串,它按顺序逐个取出元素或单字符;针对字典,默认提取所有的键,若需取值或同时提取键与值,则配合 .values() 或 .items() 解包即可。
一、for 循环底层运作机制与执行流程
很多初学者容易以为 for 循环只是按下标顺序依次读取。实际上,Python 解释器在执行 for item in iterable: 语句时,会在后台静默完成以下三步操作:
- 创建迭代器:调用内置函数
iter(iterable),取得该对象持有的迭代器。 - 逐次获取元素:在每次循环开始时,自动执行
next(iterator),并将返回值赋给循环变量。 - 安全退出:当元素取尽时,迭代器内部抛出
StopIteration异常。for循环会自动拦截该异常并平稳结束,无需开发者手动处理边界越界问题。
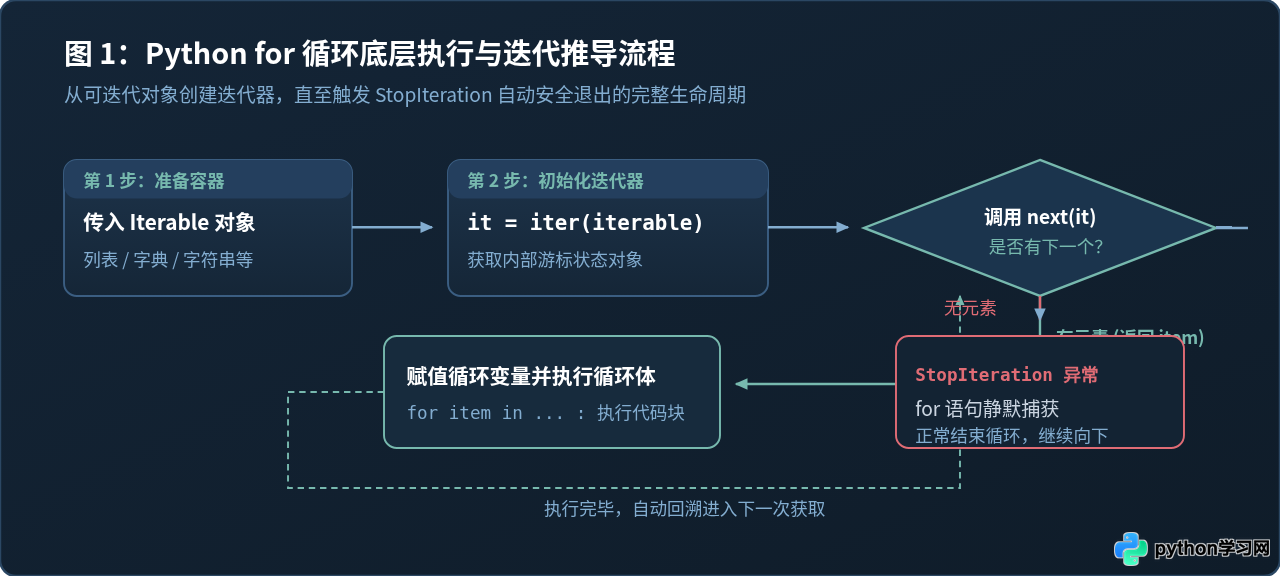
我们可以用等价的 while 循环代码来验证这一过程:
# 示例代码:for 循环的底层等价实现
data = [10, 20, 30]

# 标准 for 循环:
# for x in data:
#     print(x)

# 等价底层操作:
iterator = iter(data)
while True:
    try:
        x = next(iterator)
        print(x)
    except StopIteration:
break20
30
二、遍历列表(List)的常见方法与实用技巧
列表是 Python 中最常用的有序可变容器。遍历列表主要涉及三种场景:单纯消费元素值、需要同步获知索引位置,以及同时配对遍历多个列表。
1. 直接遍历元素
如果业务逻辑只需要列表里的每一项数据,无需知道其处于第几个位置,直接使用 for item in list 是最高效且最符合 Pythonic 风格的写法。
# 示例代码:直接遍历列表
frameworks = ["Flask", "FastAPI", "Django"]

for name in frameworks:
print(f"框架名称: {name}")框架名称: FastAPI
框架名称: Django
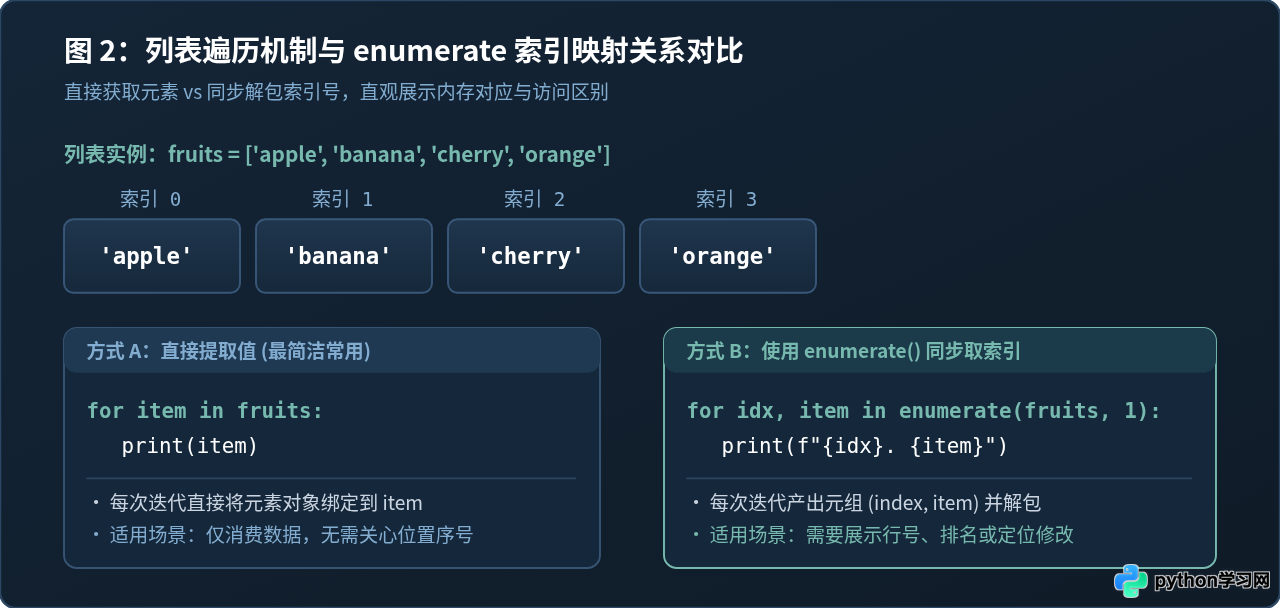
2. 需要索引时:使用 enumerate() 代替 range(len())
当打印排名、行号或需要记录元素次序时,初学者常写出 for i in range(len(list)): list[i]。这种写法不仅繁琐,而且降低代码可读性。Python 提供了内置函数 enumerate(),它在每次迭代时返回一个包含 (索引, 元素) 的元组,并可直接在循环头解包,还可以通过 start 参数指定起始计数。
# 示例代码:使用 enumerate 获知编号
frameworks = ["Flask", "FastAPI", "Django"]

for index, name in enumerate(frameworks, start=1):
print(f"序号 {index}: {name}")序号 2: FastAPI
序号 3: Django
3. 并行遍历多个列表:使用 zip()
当有两个或多个长度一致的相关列表(例如姓名列表与分数列表),需要一一对应处理时,使用 zip() 能将对应位置的元素打包成元组共同输出:
# 示例代码:使用 zip 并行处理两个列表
students = ["张三", "李四", "王五"]
scores = [92, 88, 95]

for name, score in zip(students, scores):
print(f"学生: {name} | 得分: {score}")学生: 李四 | 得分: 88
学生: 王五 | 得分: 95
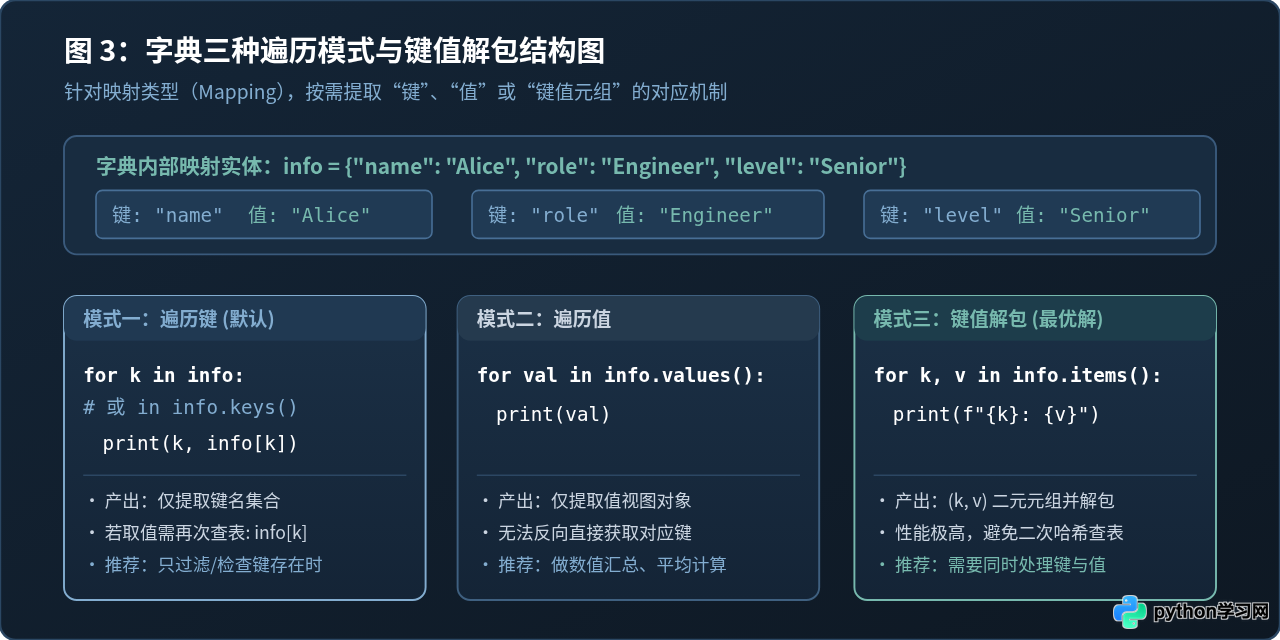
三、遍历字典(Dict)的三种常用模式
字典是一种基于哈希表的键值映射结构。与列表不同,字典本身包含键(Key)与值(Value)两个维度,因此遍历方式更加丰富。
1. 模式一:默认遍历所有键(Keys)
当直接将字典对象传给 for 循环时,Python 默认只产出它的键。for k in d: 与 for k in d.keys(): 效果完全等同,前者更精简。
# 示例代码:默认遍历字典的键
server = {"host": "192.168.1.10", "port": 8080, "protocol": "https"}

for key in server:
print(f"键: {key} -> 对应值: {server[key]}")键: port -> 对应值: 8080
键: protocol -> 对应值: https
2. 模式二:仅遍历所有值(Values)
如果只需处理数值、累计求和或统计状态,完全不在意对应字段的键名,调用 .values() 方法即可避免无谓的键提取:
# 示例代码:仅遍历字典的值
sales = {"apple": 30, "banana": 45, "orange": 25}

total = 0
for count in sales.values():
    total += count

print(f"总销量为: {total}")3. 模式三:键值解包(Items)——推荐的最优解
当同时需要读取键和对应的值时,强烈建议使用 .items()。该方法每次迭代产出 (key, value) 二元元组,由 Python 自动解包赋值。与先遍历键再去 server[key] 查表相比,.items() 省去了二次哈希检索,运行效率更高且代码语义最直接。
# 示例代码:使用 items() 键值解包
server = {"host": "192.168.1.10", "port": 8080, "protocol": "https"}

for key, value in server.items():
print(f"属性名: {key:<10} | 配置参数: {value}")属性名: port | 配置参数: 8080
属性名: protocol | 配置参数: https
四、遍历字符串(String)的具体方式
在 Python 中,字符串是不可变的字符序列。当把字符串放入 for 循环时,迭代器会按照从左到右的顺序,每次输出一个长度为 1 的单个字符。
1. 逐字符提取与处理
直接遍历字符串可用于字符检查、数字统计或转义处理:
# 示例代码:逐字符遍历与分类计数
sentence = "Python 3.12"

digits_count = 0
alpha_count = 0

for char in sentence:
    if char.isdigit():
        digits_count += 1
    elif char.isalpha():
        alpha_count += 1

print(f"字母数量: {alpha_count}, 数字数量: {digits_count}")2. 带字符位置索引遍历
与列表类似,如果需要定位某字符在字符串中的绝对索引位置(例如查找特定分隔符或校验首字母),同样可以使用 enumerate():
# 示例代码:利用 enumerate 检索字符位置
text = "abc@def.com"

for index, char in enumerate(text):
    if char == "@":
print(f"发现 @ 符号,位于下标位置: {index}")for 循环内部频繁执行 new_str += char 拼接大量字符,这会在每次循环中创建新对象并复制全部内存,导致 $O(N^2)$ 的时间复杂度。标准做法是将符合条件的字符先 append 到一个列表中,循环结束后调用 "".join(list) 一次性组装。
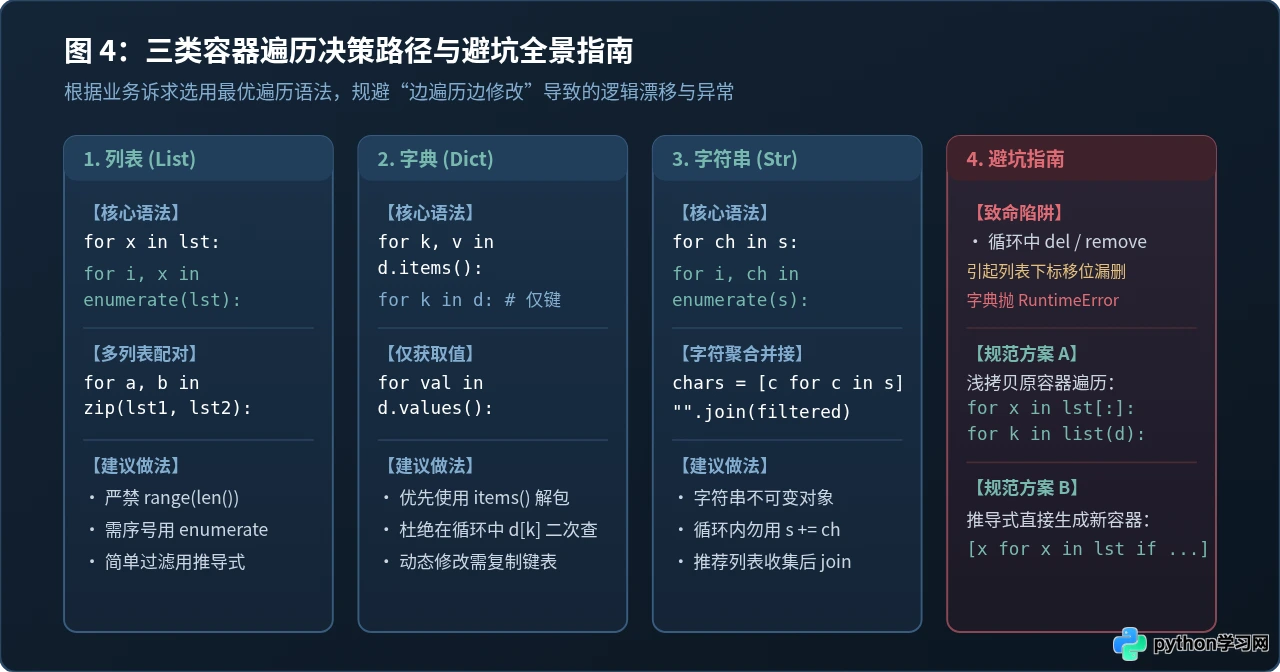
五、循环遍历中的关键注意事项与避坑指南
在开发过程中,最隐蔽、最容易引发线上事故的操作之一是:在 for 循环体内部直接增加或删除正在被遍历的容器元素。
1. 陷阱一:循环中修改列表导致“漏项”
Python 列表是有序内存块,底层迭代器依赖内部整数偏移量索引推进。若在遍历过程中执行 list.remove() 或 del,后续所有元素的索引会向前移动一位,导致紧邻被删元素的下一项直接被游标跳过:
# 错误示例:边遍历边删除列表元素(会导致漏删!)
numbers = [1, 2, 2, 3, 4]

for num in numbers:
    if num == 2:
        numbers.remove(num)

print(f"错误删除后的结果: {numbers}")
# 第二个 2 因索引移位被漏跳,依然残留在列表中!2. 陷阱二:循环中修改字典直接抛出 RuntimeError
字典的迭代器比列表有更严格的一致性防护。一旦在遍历过程中增加或删除了字典的键,下一次迭代时迭代器会检测到哈希表字典大小变动,直接中断并抛出致命错误:
# 错误示例:边遍历边修改字典尺寸
data = {"a": 1, "b": 2, "c": 3}

try:
    for k in data:
        if k == "b":
            del data[k]
except RuntimeError as err:
print(f"触发致命异常: {err}")3. 安全解决方案
面对在遍历中筛选或剔除数据的需求,有两种标准且安全的解决路径:
- 使用切片浅拷贝或转列表:遍历容器的副本,修改原始容器。例如列表使用
for item in numbers[:]:,字典使用for key in list(data.keys()):。由于被遍历的副本结构固定,对原容器的修改不会破坏迭代。 - 使用推导式生成全新容器(最推荐):直接使用列表推导式
numbers = [x for x in numbers if x != 2]或字典推导式,不仅逻辑纯粹无副作用,运行速度通常也显著高于显式for循环加append/remove。
六、三类容器遍历特性速查表
为了便于在日常编写 Python 代码时快速查阅与选型,下表归纳了列表、字典与字符串在不同场景下的推荐遍历语法:
| 容器类型 | 常规遍历语法 | 带索引/编号语法 | 解包或扩展语法 | 高频应用场景 |
|---|---|---|---|---|
| 列表 (List) | for x in lst: |
for i, x in enumerate(lst): |
for a, b in zip(l1, l2): |
按顺序处理数据记录、批处理队列、并行比对 |
| 字典 (Dict) | for k in d: |
for i, k in enumerate(d): |
for k, v in d.items(): |
JSON参数解析、键值关联映射、配置项检索 |
| 字符串 (Str) | for c in s: |
for i, c in enumerate(s): |
[c for c in s if ...] |
文本清洗、敏感词扫描、格式校验与字符统计 |
掌握以上 for 循环与迭代器机制、enumerate()、.items() 的组合用法,并时刻警惕遍历中修改容器的副作用,就能在绝大多数 Python 编程任务中写出清晰、安全且高性能的循环处理逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















